
「これ直して」だけではAIは6.4ポイント落ちる。RealSWEが暴いた実務プロンプトの弱点
「空の入力で落ちる。直して」
人間同士なら、これで会話は始まります。ところが、コーディングAIの実力を測るベンチマークでは、再現手順、実行環境、期待する動作、関連ファイルまで整った依頼が渡されることが少なくありません。

では、同じバグを直す仕事でも、依頼文が現実らしく短くなったら成績はどれくらい変わるのでしょうか。
Sungkyunkwan Universityの研究チームが公開した「RealSWE」は、この差を同じ381タスクで測りました。結果ははっきりしています。7種類のLLMすべてで解決率が下がり、平均低下幅は6.4ポイントでした。
ただし、本当に面白いのは「短い依頼はダメ」という話ではありません。文章を丁寧にすることより、何を明示するかのほうが重要だったのです。
従来のベンチマークは、依頼が親切すぎる
SWE-bench系の評価は、実在するGitHub issueと修正コミットを使います。実際のリポジトリでテストを通す必要があるため、単純なコード生成よりずっと厳しい評価です。
一方で、そのissue自体は人間が整理した情報の塊です。観測した不具合、望ましい動作、再現手順、環境情報、背景まで書かれていることがあります。
RealSWEの研究チームは、実際の開発者とコーディングAIの対話データ「SWE-chat」から、最初のユーザー依頼718件を抽出しました。これをSWE-bench VerifiedとSWE-bench Proの問題文1,229件と比較しています。
すると、現実の依頼の88%は「問題だけ」か「問題と少しの補足」でした。ベンチマークで同じ構成は7%しかありません。
書き方も違います。現実の依頼の86.8%はくだけた表現でしたが、SWE-bench Verifiedでは84.8%、SWE-bench Proでは100%が形式的な文章でした。
普段の依頼は短い。ベンチマークの依頼は、かなり親切。この違いを無視すると、実運用の性能を高く見積もる可能性があります。
RealSWEは、仕事を変えずに依頼文だけを変える
現実の依頼とベンチマークをそのまま比べても、公平な比較にはなりません。仕事そのものの難しさが違うからです。
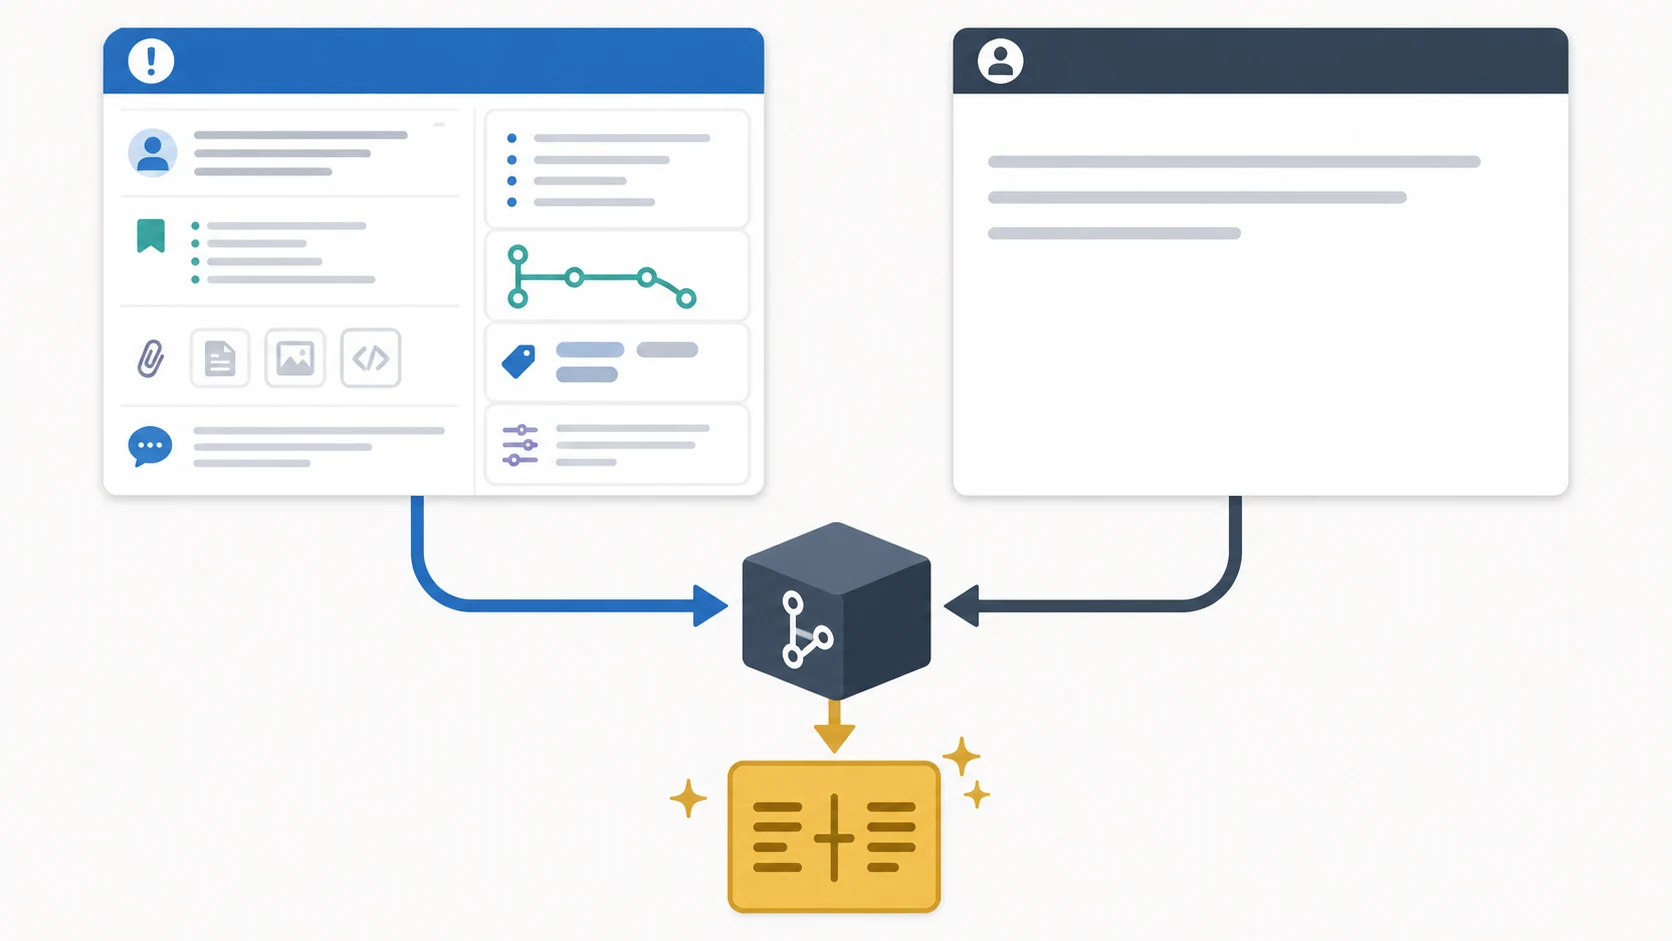
RealSWEの工夫は、同じ仕事に複数の依頼文を用意したことです。元のリポジトリ、直すべき課題、正解となるパッチは固定し、依頼文に含める情報と文体だけを変えます。
バグ修正の依頼は、次の情報に分解されます。
- 起きている問題
- 直した後に期待する動作
- 再現手順
- 実行環境
- その他の補足
新機能の依頼では、期待する機能に加えて「なぜ必要なのか」という動機を分けます。
研究チームは、すべての必要項目を含む候補403件を作り、品質監査で22件を除外しました。最終的なRealSWE-benchは381タスクです。内訳はバグ修正192件、新機能189件で、21リポジトリ、4言語にまたがります。
各モデルは同じmini-SWE-agent v2上で動き、最大100ステップまで実行します。モデルと条件の組み合わせごとに3回走らせ、平均と標準偏差を報告しています。
ここが重要です。別の問題を解かせて「現実のほうが難しかった」と言っているのではありません。同じ問題で、渡す情報だけを変えています。
7モデルすべてで成績が落ちた
元のSWE-bench問題文と、現実の分布に合わせた短い依頼を比べると、7モデルすべてで解決率が下がりました。
全381タスクの平均低下幅は6.4ポイントです。モデル別では4.0から8.0ポイントの低下で、相対的には平均13.6%の減少でした。
たとえばDeepSeek V4 Proは53.9%から45.9%へ、DeepSeek V4 Flashは49.7%から41.6%へ下がっています。Claude Haiku 4.5も42.1%から36.7%へ低下しました。
短い依頼になると、モデルの順位まで変わる場合があります。つまり、整ったissueで強いモデルが、そのまま雑な実務依頼にも強いとは限りません。
丁寧さより「直した後」を書く
では、短い依頼を長く書き直せばよいのでしょうか。
RealSWEの分解実験は、もっと具体的な答えを示しています。
バグ修正では「直した後にどう動いてほしいか」を取り除くと、4モデルすべてで解決率が7.1から8.9ポイント低下しました。平均は8.0ポイントで、統計補正後も全モデルで有意です。
一方、再現手順、環境情報、その他の補足を順に外したときの平均変化は合計1.8ポイントでした。もちろん特定のバグでは再現手順や環境が不可欠です。ただ、全体平均では「期待する動作」の寄与が際立っています。
新機能では「なぜ必要なのか」という動機を外すと、平均3.4ポイント低下しました。95%信頼区間は0.2から8.2ポイントです。効果はバグ修正の期待動作ほど一様ではありませんが、追加情報の中で最も価値がありました。
対照的に、情報を保ったまま文体だけを変えた場合、バグ修正の平均変化は0.0ポイント、新機能ではマイナス1.8ポイントでした。8つの比較はいずれも統計的に有意ではありません。
敬語にするか、命令形にするか、文章を整えるか。そこに神経を使うより、成功条件を一文足すほうが効く可能性があります。プロンプトの化粧より、要件の骨格です。AIも空気は吸えますが、空気読みはまだ課金対象のようです。
実務では「要求補完ゲート」を置く
この結果を、日々のコーディングAI利用へどう落とし込めばよいでしょうか。
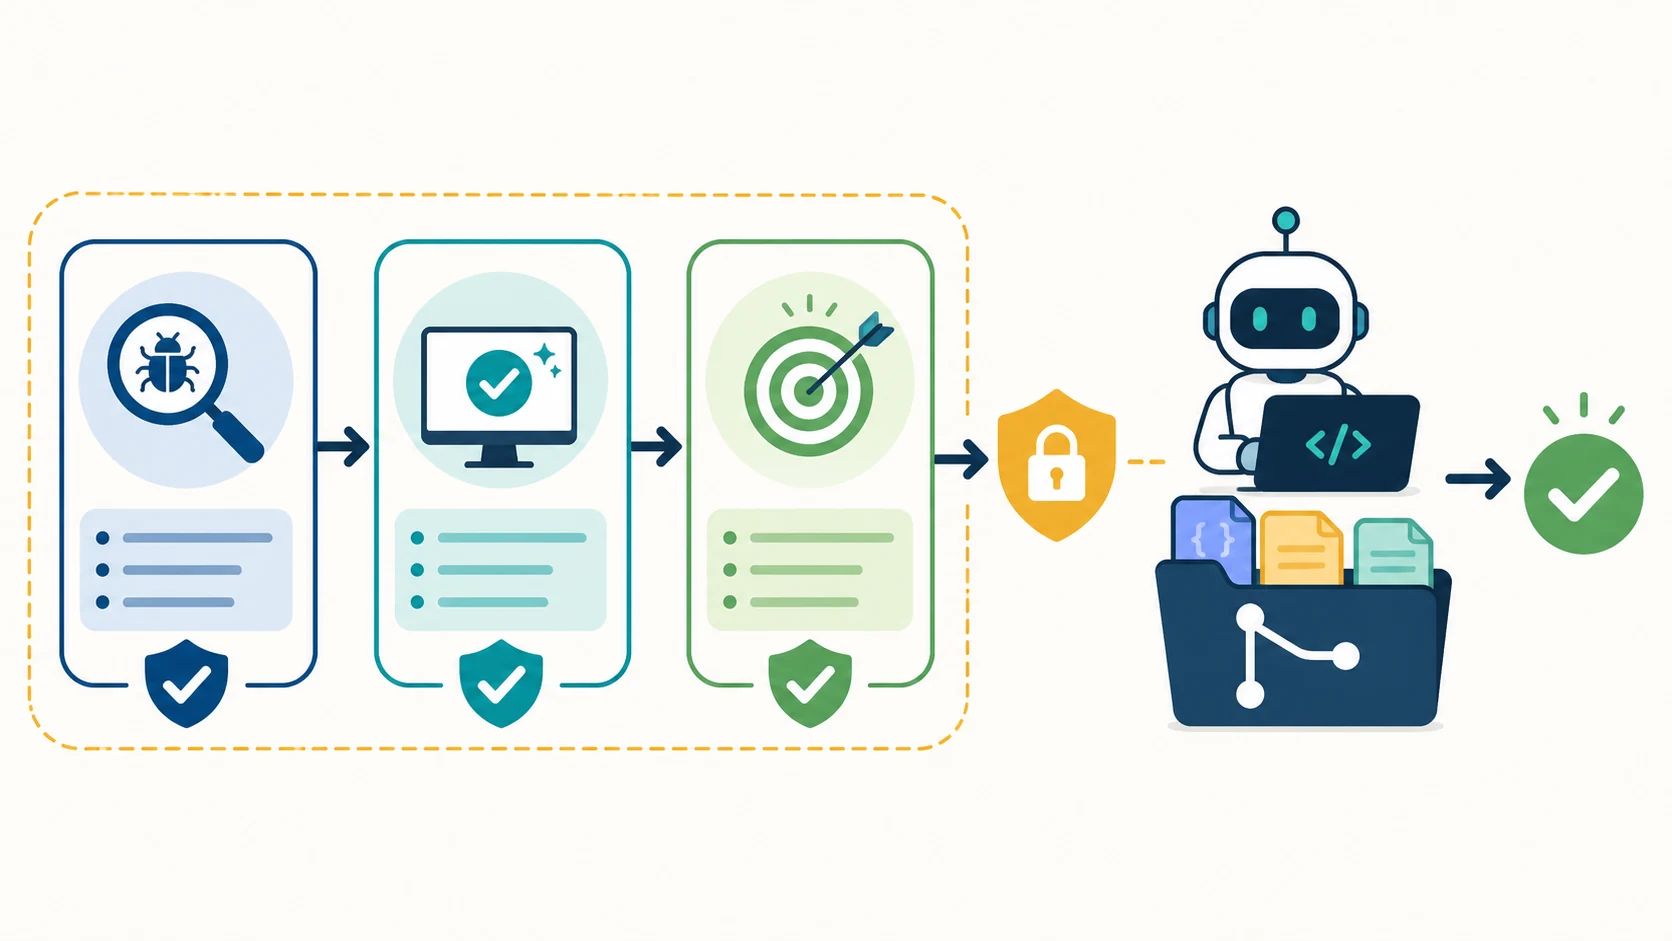
AICompanyでは、実装前に次の3点を短く固定する方法が使えます。
- 現在の問題を一文で書く
- 修正後に観測できる動作を一文で書く
- 新機能なら、その変更が必要な理由を一文で書く
たとえば「CSV読み込みで空行があると落ちる」だけで終わらせず、「空行は無視し、有効な行だけを読み込んで処理を続ける」と足します。
新機能なら「検索結果に日付フィルターを追加する」に加えて、「古い記事を除外して、担当者が直近の更新だけ確認できるようにする」と目的を書きます。
エージェント側にも改善余地があります。期待する動作を安全に推定できなければ、ファイルを編集する前に一つだけ確認する。推定できる場合は、理解した成功条件を短く提示してから進む。この確認ゲートなら、依頼者へ長大なテンプレートを強制せずに情報不足を補えます。
ただし、これはRealSWEの結果から導いたAICompanyの実務提案です。論文自体は、確認質問を行う対話型エージェントを直接評価していません。
まだ証明されていないこと
RealSWEは比較設計が強い一方、限界もあります。
第一に、評価は一回の依頼で完結する単一ターンです。現実の開発では、AIが質問し、人が追加情報を返します。この対話が6.4ポイントの差をどこまで埋めるかは未検証です。
第二に、評価対象にはDeepSeek V4、MiMo V2.5、Claude Haiku 4.5、Qwen3.7 Plus、MiniMax M3が含まれますが、著者自身が挙げるGPT-5.6、Opus 5、Kimi K3などの最上位モデルは含まれません。
第三に、依頼文の分解と書き換えにはGPT-5.4、全候補の品質監査にはGPT-5.6 Terraが使われています。各工程で100件の人手検証を行い、高い一致を確認していますが、完全な人手構築ではありません。
第四に、公開リポジトリは監査時点で固定ベンチマークのtasks.jsonlを確認できましたが、READMEは空で、論文が説明する設定可能なRealSWE-frameworkと評価スクリプトは見当たりませんでした。追試の入口は公開されているものの、論文の全実験をそのまま再実行できる状態かは確認できません。
AICompanyでも全実験は再実行していません。381タスク、7モデル、2条件、各3回だけでも約1万6千回のエージェント実行になり、追加の分解実験もあります。
結論
RealSWEが示したのは、コーディングAIが「長いプロンプト」を必要としているという単純な話ではありません。
必要なのは、正しい情報です。
バグなら、今どう壊れているかに加えて、直した後に何が起きれば成功なのかを書く。新機能なら、何を作るかに加えて、なぜ必要なのかを書く。
文章の丁寧さより、成功条件。情報量より、情報の種類。
コーディングAIの性能を引き出す最短の一手は、プロンプトを長くすることではなく、「直った状態」を一文で決めることかもしれません。