
AIの応答を速くしたいとき、まず思い浮かぶのはGPUやモデルの変更だろう。けれど、文章をモデルに渡すための準備で時間を使っているなら、その手前にも改善の余地がある。
Hugging Faceが2026年9月21日に公開した「tokenizers v1」の技術報告は、この地味で大切な工程を扱っている。文章を整数の列に変える処理を見直し、Apple M4 Maxの一スレッド測定で、旧版に対してモデル別に約3〜30倍のエンコード速度を報告した。

目を引く数字だが、AIの回答が30倍速くなるという意味ではない。今回の面白さは、モデルが読む内容を維持しながら、その内容を用意するまでの無駄を減らしたところにある。何を速くし、どこまで効果が届くのかを順に見ていこう。公式技術報告
文章を数字にする、小さな工場
言語モデルは、入力された文章をそのまま文字として読んでいるわけではない。トークナイザーが文章を細かな単位に分け、それぞれに対応する整数IDへ変換する。
ここでいう単位は、必ずしも人間が考える「単語」と一致しない。ひとつの単語が複数に分かれることもあれば、空白の扱いが区切り方に関わることもある。同じ文章でも、モデルが採用する方式や辞書によって結果は変わる。
一般的な流れは、文字の正規化、粗い区切り、トークンへの変換、特殊トークンなどの後処理だ。GPUでモデルの計算を始める前に、CPU側でこの準備が必要になる。
短い質問を一度送る場面では目立たなくても、長文を大量に前処理したり、多数の要求を同時に受けたりすると話が変わる。厨房が速くても注文票の整理が追いつかなければ、料理は出てこない。今回の改善は、注文票をさばく側の仕事に近い。
同じ答えを出す工程から、繰り返す仕事を取り除く
v1は、辞書を小さくして別のID列を返すことで速度を稼ぐ設計ではない。従来と同じ出力を目標に、処理の内側を組み替えている。中心となる工夫は三つに整理できる。
ひとつ目は、区切りの判定を専用化すること。 対応する分割規則では、汎用の正規表現処理を毎回使う代わりに、複数のバイトをまとめて判定する仕組みを使う。公開実装のbitcannonがこの役割を担う。ただし、対応外のパターンは従来の経路に残る。どんなトークナイザーにも同じ効果が出るわけではない。bitcannonの公開実装
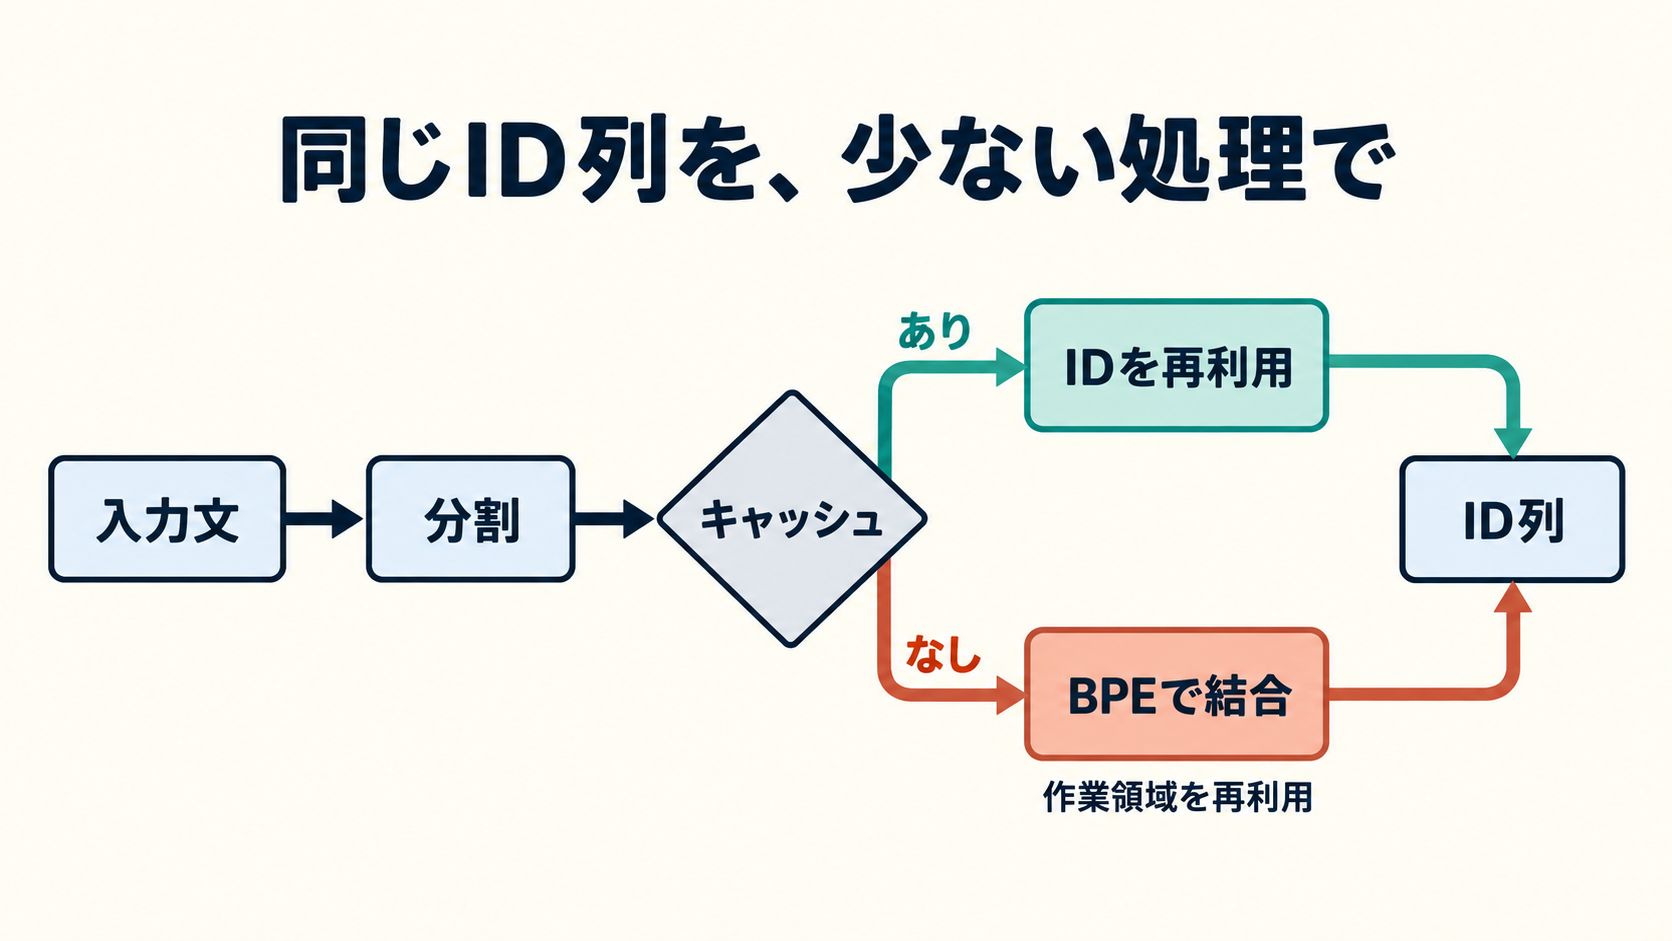
二つ目は、既に変換した断片の結果を再利用すること。 粗く分けた文章の断片をプリトークンという。同じ断片が再登場したら、保存済みのID列を取り出す。これはモデルが会話を覚えるメモリでも、GPU上のKVキャッシュでもない。文章をIDに変換する工程の小さなキャッシュだ。WordCacheの公開実装
三つ目は、細かな結合処理の準備を使い回すこと。 BPEという方式では、隣り合う小片を決められた優先順で結合する。このたびに作業用メモリを確保したり、データを動かしたりする負担を減らす。再利用する作業領域と、配列内の位置を使った管理によって、何度も通る内側の処理を軽くする。BPE結合処理の公開実装
ひとつの魔法で全部が速くなったのではなく、区切る、思い出す、結合する、それぞれの小さな待ち時間を削っている。
「3〜30倍」の中には、大きな幅がある
公式記事に埋め込まれた結果のうち、旧tokenizersとのエンコード比較を抜き出すと、次のようになる。値は各モデルの22コーパスに対する公開集計で、全10モデル・220条件の比較が示されている。
| トークナイザーのモデル | 旧版に対する速度倍率 |
|---|---|
| gpt2 | 29.83倍 |
| llama-3 | 26.58倍 |
| bert-base-uncased | 6.73倍 |
| t5-base | 3.33倍 |
これは提供元がApple M4 Max上で測ったRust経路の結果だ。 Pythonから呼び出す際の追加コストや、GPUで文章を生成する時間は含まない。別のCPUや別の入力でも同じ倍率になるとは言えない。
AICompanyでは、公開ページの表示用JSONを抽出し、モデル数、条件数、最小値・最大値を照合した。ベンチマークそのものを手元で走らせたわけではなく、個々の生の試行から再集計したものでもない。公式の結果ページ
版にも注意したい。確認した結果データはtokenizers-rc0 @ 199d9a13、比較先は0.23.1を指す。一方、9月22日の確認時点で公開されていた候補版は1.0.0-rc.2だった。これらの数字をrc.2の実測値と読み替えることはできないし、正式版1.0の完成報告でもない。公開バージョン
測り方が変わると、速さも変わる
キャッシュのある処理では、同じ文章を何度も変換する測定が有利に働く。ところが実務では、新しい文書が次々に入ってくる。同じ説明文を含んでいても、毎回まったく同じ文章とは限らない。
測定用の公開プロジェクトtokbenchは、準備運転と計測に異なる入力区間を使い、同じ文章を計測中に繰り返し処理しない設計を採っている。また、ID列のハッシュを参照実装と比較し、異なる結果を返す条件はランキングから外す。辞書などの読み込み時間も、変換時間とは分けて扱う。tokbenchの測定設計
この考え方は、読む側にも役立つ。「何MBを何秒で処理したか」だけでなく、同じ仕事をしているか、同じ文章の使い回しではないかを確認する必要がある。
なお、測定範囲での一致は、あらゆる入力に対する数学的な保証とは異なる。確認した現行WordCacheの実装には、15バイトを超える断片ではハッシュによる照合を使い、衝突の可能性は極めて小さいがゼロではないとの注記もある。自分のデータでID列を確認する手順は省きたくない。
キャッシュも常に得とは限らない。再登場する断片が少なければ、保存済みかを調べる負担が先に立つことがある。日本語、コード、定型文の多いエージェント入力では、反復の仕方が違う。自分の入力を使って測る意味はここにある。
10倍速い部品を入れたら、全体は何倍になる?
ここからは、実務での見方を整理するためのAICompanyによる仮定例だ。実測結果ではない。
100秒かかる仕事を考える。トークン化に5秒、残りの処理に95秒かかっていたとしよう。トークン化だけが10倍速くなると、そこは0.5秒になる。合計は95.5秒で、全体の速度は約1.05倍だ。
一方、トークン化に50秒、残りに50秒かかる仕事なら、改善後は5秒+50秒で55秒になる。こちらは約1.82倍。同じ部品の10倍速でも、全体への効き方は大きく変わる。
| 仮定した元の内訳 | トークン化だけ10倍速くした後 | 全体の速度倍率 |
|---|---|---|
| トークン化5秒+その他95秒 | 0.5秒+95秒=95.5秒 | 約1.05倍 |
| トークン化50秒+その他50秒 | 5秒+50秒=55秒 | 約1.82倍 |
計算は「元の全体時間÷改善後の全体時間」。処理が順番に実行され、ほかの工程が変わらないという単純化を置いている。実際のサービスには並列処理や待ち行列があるので、この表をそのまま性能予測には使えない。
それでも、最初にどこを調べるべきかは分かる。モデルを交換する前に、前処理、モデル実行、通信、待ち時間のどこが支配的なのかを見たい。
自分の仕事に持ち込むなら、最初に何を見るか
記事を大量に分類する、検索用の文書をまとめて処理する、長いコードを繰り返し入力する。こうした仕事では、モデル本体の外側にある処理も積み重なる。
AICompanyとしては、まず実際に使う文章の小さな集合を用意し、次の順で比較するのがよいと考える。
- 同じモデルの辞書・設定を固定し、新旧のID列が一致するか確かめる。
- 日本語、コード、定型文を含む入力を分け、異なる文書が流れてくる条件で測る。
- 初回の読み込み、変換だけの時間、仕事全体の時間を別々に記録する。
- スレッド数を変えるときは、メモリ使用量と遅い要求の待ち時間も一緒に見る。
旧版比が大きくても、今使っている別の実装に対して勝つとは限らない。高速化のために方式を替えた結果、特殊トークンや付随する位置情報の扱いが変われば、その影響も調べる必要がある。
今回の報告が示すのは、AIを速くする余地がモデルの中だけにあるわけではない、ということだ。出力を変えずに前処理の仕事量を減らし、その効果を正しい条件で測る。tokenizers v1は、その地道な改善が大きく積み重なる例として読むと価値がある。