
500問のテストで、Aは396問、Bも396問正解。同点なら互角でしょうか。では、Aが1問だけ多く解いたら、Aを選ぶ根拠になるでしょうか。
AIのコーディング能力を比べるとき、正答率の小数点はとても頼もしく見えます。でも、その細かさに見合うだけの証拠があるとは限りません。

2026年9月15日公開の論文「Coding Agents Have Converged」は、SWE-benchの公開評価結果を調べ、順位表の読み方を問い直しました。中心となる発見は、調査対象のSWE-bench Verified上位30件では、隣り合う29組のどれにも統計的な有意差を確認できなかったことです。
ただし、これは「コーディングAIは全部同じ」という話ではありません。論文が分析したのは、著者らが2026年7月30日に取得した、2023〜2025年の投稿を含むデータです。2026年9月現在の最新モデルを一斉に走らせた比較ではない。この範囲を押さえると、むしろ自分の仕事に合うAIを選ぶための、具体的なヒントが見えてきます。
500問あっても、上位同士の違いが見えるのは164問
SWE-bench Verifiedは、実際のGitHubの課題に対して修正を作り、テストを通して解決できたかを調べる評価です。今回の論文は、モデルを新たに実行するのではなく、公開されている課題ごとの成功・失敗を再分析しています。
著者らが集めたのは、4種類の評価セットにまたがる254件の投稿。主な分析対象のVerifiedは500課題、134件の投稿です。
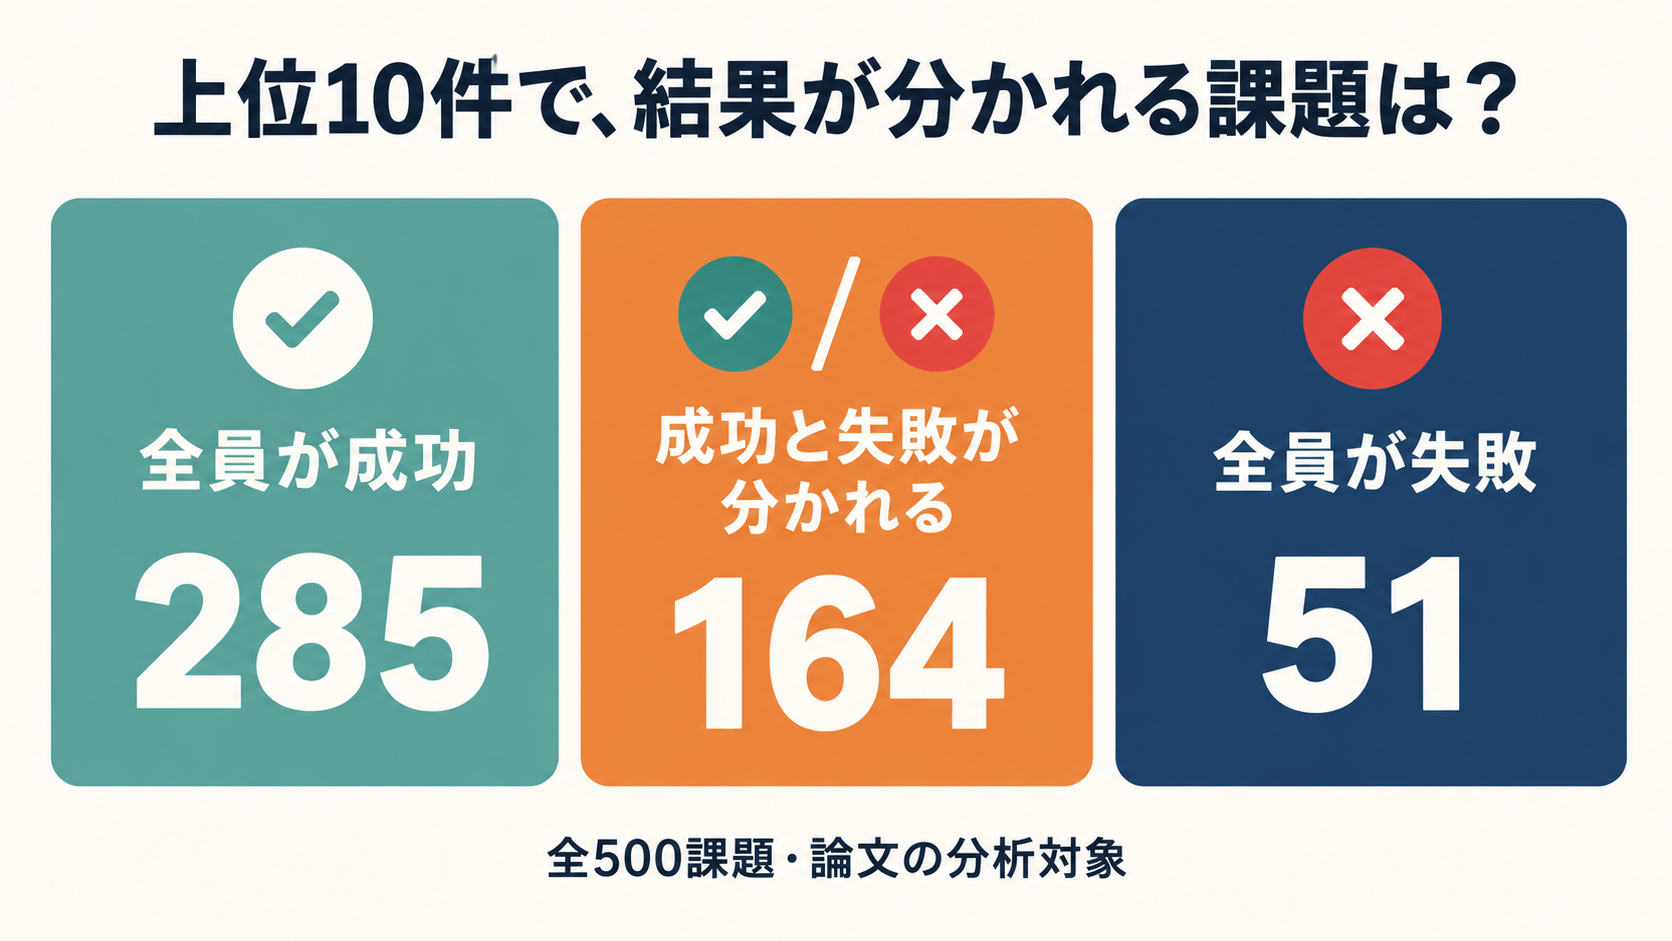
ここで上位10件だけに絞り、500課題を三つに分けます。
- 285課題:10件すべてが解決した。
- 51課題:10件すべてが解決できなかった。
- 164課題:解決できたものと、できなかったものが分かれた。
285課題と51課題も、絶対的な成功率を測るうえでは必要です。ただ、その10件の中で誰を上に置くかという問いには、差をもたらしません。上位同士の違いが現れるのは、残る164課題です。
論文は、このように比較相手によって結果が分かれる課題数に注目します。500問という看板は同じでも、幅広い性能のシステムを比べるときと、よく似た上位システムだけを比べるときでは、違いを見分ける力が変わるわけです。
注意したいのは、164課題を新しい分母にして正答率を計算し直せばよい、という提案ではないことです。元の500課題に対する成功率と、比較対象の間で結果が分かれる課題数は、別々の情報として見る必要があります。
点数差だけでなく「どこで入れ替わったか」を見る
二つのAIを同じ課題で試したなら、比較にもその対応関係を使えます。
両方が成功した課題、両方が失敗した課題に加え、「Aだけ成功」「Bだけ成功」を数える。今回の論文で使われたMcNemar検定は、この食い違いに注目する統計手法です。
たとえば、次は説明用の架空の結果です。
- 500課題のうち、Aだけ成功した課題が20件。
- Bだけ成功した課題が19件。
- 残る461件では、成功・失敗が一致した。
Aは1問分、0.2ポイント上です。しかし39件で勝ち負けが入れ替わった末の20対19を見れば、点数だけから大きな優劣を読み取るのが難しいことは直感的にも分かります。
実際の論文では、Verified上位30件の隣接29組を、有意水準5%の正確なMcNemar検定で比較しました。有意差が出た組はゼロでした。
ここで「差がないと証明された」と言い換えてはいけません。このデータでは差を示しきれなかったのであって、実務上同等だと確かめたわけではありません。同等と主張するなら、許容できる差を先に決め、その問いに合う検証が必要です。
また、隣り合う組で差が出ないことは、離れた順位もすべて同じという意味ではありません。AとB、BとCでそれぞれ差を示せなくても、AとCまで同じ結論になるとは限りません。
AICompanyでも公開結果を数え直した
今回は、論文に対応する公開リポジトリの上位30件の一覧を使い、SWE-bench側の課題別結果30ファイルを取得して再集計しました。取得時のコミットとファイルのハッシュを記録し、分析対象を固定しています。
確認できたのは、次の範囲です。
- 30件すべての成功課題数が、著者の公開一覧と一致した。
- 上位10件の共通成功285件、共通失敗51件、結果が分かれる164件が一致した。
- 隣接29組の検定で有意差が出ない結果が一致した。最小のp値は約0.545だった。
これは、公開結果から主要な集計を再現できたという確認です。30種類のエージェントを動かし直したわけではなく、論文中のすべての統計分析を再現したわけでもありません。また、この30件が現在のランキングの上位30件であることを検証したものではありません。
論文の再現手順には、公開結果をその時点の最新版から取得する箇所があります。将来同じ数字を確認したいなら、「どの版の、どの投稿を使ったか」まで残す必要がある。この点も、評価の再現性では見落とせません。
順位に載っているのは、モデルと使い方の組み合わせ
もう一つの論点は、順位表の数字をモデル単体の能力とみなせるかです。
コーディングエージェントには、モデルのほかに、ファイルを探す方法、ツール、作業の進め方、履歴の扱い方などがあります。論文は、こうした周辺の仕組みをscaffoldと呼び、公開情報からモデルとの組み合わせを整理しました。
その結果、同じモデル名でも、組み合わせた仕組みによって大きな点数差が見られました。ただし、各チームが独自に作って投稿した結果の比較です。開発時期や調整の手間なども違うため、「仕組みを交換すれば、その点数分だけ伸びる」という因果関係までは示していません。
それでも、実務での読み方は変わります。「このモデルは何点か」に加えて、「どんなツールと設定で、どの版の課題を、いくらの予算で解いたのか」を見る必要があります。名前だけ同じモデルを自分の環境で動かしても、掲載スコアがそのまま出るとは限りません。
手元の仕事なら、比較表に何を足すか
ここからは、論文を踏まえたAICompanyの応用案です。
たとえば、既存サイトの小さな不具合修正に使うAIを選ぶとします。ランキング上の0.2ポイント差を追う前に、自分のリポジトリで繰り返し起きる作業を集め、同じ開始状態から比べます。
まず残したいのは、課題ID、成功・失敗、実行時間、費用、モデルの版、ツールと設定です。さらに、結果を「両方成功」「Aだけ成功」「Bだけ成功」「両方失敗」に分けると、単なる平均では隠れた違いが見えます。
両方が成功する課題が多いなら、その範囲では時間や費用が選択材料になるかもしれません。Aだけが直せる課題が特定のモジュールに集中するなら、その種類の仕事に限ってAを使う案を検討できます。逆に、AもBも失敗する課題は、今回の二択を決める材料として弱くても、運用に残る穴を示しています。
課題を増やすときも、結果を見た後で好きなモデルが勝つ問題だけを足すのは避けたいところです。実際の業務の比率に合わせて対象を決め、調整に使う課題と最後に比較する課題を分ける。時間を変えて複数回試し、実行ごとの揺れも記録する。この手順は、今回の論文で十分に扱えていない点を補うための提案です。
小さな評価セットに難しい統計の名前を付ければ、結論が強くなるわけではありません。まずは勝敗の一覧を残し、判断できる範囲と、まだ決めきれない範囲を分ける。それだけでも、選定の根拠はかなり説明しやすくなります。
この論文から言えないこと
今回の結果には、はっきりした限界があります。
第一に、各投稿は一回分の公開結果です。同じシステムを再実行したときの変動を含めた、総合的な不確かさは分かりません。課題を抜き出し直す統計処理と、エージェントをもう一度走らせることは別です。
第二に、一つのベンチマーク群への自主的な投稿を調べた研究です。最新モデル、別の開発言語、長期の保守作業、社内の非公開コードに、その数値をそのまま移せません。学習データとの重なりや、課題・判定の不備も、完全に取り除かれたわけではありません。
第三に、SWE-bench全体が比較に使えないという結論でもありません。論文が調べた、より大きいTestセットでは、隣接23組のうち14組に有意差がありました。何を、どの幅で比べるかによって、見分けられる差は変わります。
研究の価値は、「どのAIも同じ」と結論を急ぐことではなく、数字がどこまでの主張を支えるかを点検する方法にあります。
小数点の前に、課題ごとの結果を見る
新しいAIを選ぶとき、順位は候補を絞る手がかりになります。ただ、細かな差をそのまま確定した序列として扱うと、評価が持つ情報以上の意味を読み込んでしまいます。
自分の仕事で知りたいのは、どの課題を任せられ、どこで失敗し、時間と費用がどれだけかかるかです。順位表に課題ごとの勝敗と実行条件を足す。今回の研究は、その一手間が必要な理由を、公開データから確かめています。
出典
- Fengshuo Liuほか「Coding Agents Have Converged」、2026年9月15日公開、v1。論文はCC BY 4.0。本文の図解はAICompanyが独自に構成。
- 論文全文:対象データは第2節・表1、課題の内訳は第3節・表2、順位差の検定は第5節・表4、限界は第7節。
- 著者の分析コードと投稿一覧。確認時点でリポジトリ直下のライセンスファイルは見当たらず、コードの再利用条件は別途確認が必要。
- SWE-benchの公開評価結果。AICompanyの再集計は論文の一覧に含まれる30件に限定。