
AIエージェントが、消してはいけないデータを削除しようとした。そこで実行前のチェックを追加し、同じ依頼でもう一度動かす。今度は何も起きなかった。
これで修正を確認できた、と言えるでしょうか。モデルがたまたま別の行動を選んだだけなら、追加したチェックが働いたかどうかは分かりません。失敗した道をもう一度通ってくれないと、直した箇所を試せないのです。

2026年9月17日に公開された論文「Chronicle: Cut-Point Replay for Regression Testing of LLM Agents」は、この問題に対して、失敗に至る判断は記録から再生し、修正を確かめたい部分は新しいコードで動かす方法を示しました。
AIをもう一度呼んで同じ間違いを待つ代わりに、過去の失敗を、変更のたびに実行できるテストへ変える。地味に見えて、エージェントを継続運用するうえでは大切な考え方です。ただし、論文の中心的な評価は模擬モデルを使った6事例です。実運用の失敗を何でも再現できると実証したわけではありません。
ログを読むことと、修正を試すことは違う
通常のプログラムなら、問題を起こす入力を固定してテストを書けます。入力Aを渡したら禁止操作Bを実行してしまう。コードを修正し、同じAでBが止まることを確認する、という流れです。
ところがAIエージェントには、途中でモデルの判断が入ります。再実行すると別のツールを選んだり、引数を変えたりするため、最後の結果が違っていても原因を絞れません。外部のデータが変わっていれば、なおさらです。
ログには「何が起きたか」が残ります。しかし、保存した結果をすべて返すだけでは、新しいコードが動きません。逆に全部を再実行すると、失敗までの道筋が変わってしまいます。
Chronicleが用意するのは、その中間です。記録で固定する部分と、実際に実行する部分を選べるようにします。論文ではこれを「cut-point replay」と呼んでいます。
判断の境目を記録し、必要な部分だけ動かす
Chronicleは、モデル呼び出し、ツール呼び出し、処理の振り分けといった境目に印を付けます。それぞれの呼び出しについて、入力、出力、モデルの版などの情報を一つの記録にまとめます。同じ処理を繰り返す場合も、名前と何回目の呼び出しかで区別します。
たとえば「計画する→削除ツールを呼ぶ→結果を説明する」という流れで、削除の前に環境チェックを追加したとします。テストでは最初の計画を保存済みの内容に固定し、問題を起こしたときと同じ要求を新しい削除ツールに渡します。その後、削除が止まったかを確認します。
ここで動かす箇所は一つに限りません。論文の評価では、最初のモデル相当の処理を記録から返し、ツールと最後のモデル相当の処理を実行しています。後者も模擬コードなので、実際のLLMへの問い合わせは発生しません。
すべての境目を記録から返す「完全再生」にも用途はあります。境目と境目をつなぐ処理を確かめるには使えます。ただ、保存したツール結果を返すだけでは、そのツールに追加したチェックは通りません。何を直したのかに応じて、テスト中に動かす場所を選ぶことが要点です。
この仕組みは、AIの回答を意味的に採点する機能とは別です。「説明が自然か」ではなく、「禁止された操作を止めたか」「指定した引数で呼ばれたか」といった、コードで判定できる条件を繰り返し確かめます。
論文の6事例では何が確認できたか
著者のTisha Chawla氏とSusheem Koul氏は、返金額の取り違え、通貨の不一致、取引金額と数量の混同、メール送信先の広げすぎ、振込先のすり替え、本番データの削除という6事例を用意しました。いずれも、模擬モデル、ツール、模擬モデルの3段階からなる小さなエージェントです。
各事例には、不具合のあるツール、操作を止めるチェックを追加した版、チェックを維持して説明文などだけを変えた版があります。論文の表2では、cut-point replayは6事例すべてで不具合のある版を失敗と判定し、修正版と問題のない変更版を合格にしています。
対照的に、すべての結果を記録から返す比較方式は、修正版でも合格しませんでした。保存された危険な結果がそのまま返り、新しいチェックが実行されないからです。これは比較方式が一般に無価値という意味ではなく、ツール内部の修正を検証するにはテスト対象を動かす必要がある、という結果です。
「全部検出」ではなく、51件/192件と読む
著者はさらに、修正版の比較演算や定数などを小さく変え、テストの検出力を調べています。こうした変更を加えたプログラムを「変異体」と呼びます。
192件の変異体のうち、cut-point replayが検出したのは51件。すべてを記録から返す比較方式は0件でした。
残った141件のうち110件は、保存した入力では変更箇所に到達しない、またはその入力に対する判断が変わらないものでした。残る31件は、操作を止めたまま状態ラベルなどが変わり、テストが確認しない項目に差が出たものです。記録された危険な操作を通してしまう変異体は残らなかった、と著者は報告しています。
つまり、「あらゆる不具合を検出した」という読み方はできません。一つの失敗の記録が試せるのは、基本的にその入力が通る範囲です。 別の入力や境界値まで確認したければ、記録やテスト条件を増やす必要があります。
公開コードでも、同じ判定結果を確認した
AICompanyでは、公開リポジトリのコミット dffde99a75fe に固定し、付属のベンチマークと変異テストをローカルで実行しました。実行時はネットワーク接続を禁止しています。事例中の削除や送金も、実際の外部操作ではなく、結果を模したデータを返すコードです。
確認できたのは、次の範囲です。
- 6事例すべてで、不具合のある版は失敗し、チェックを追加した版と問題のない変更版は合格した。
- 完全再生は各事例で20回繰り返しても一致し、記録対象の処理を実行する回数はゼロだった。
- 安全性を変えない30件の文言変更をすべて許容した。
- 変異テストは192件中51件を検出し、すべてを記録から返す比較方式は0件だった。
これらは論文の主要な機能確認と一致しました。一方、実モデルを使った再現実験や、回答の意味を判定するLLM採点機能の検証は行っていません。実行時間も環境に左右されるため、論文に載っている速度を再現したとは扱いません。
記事公開の自動化なら、何をテストにするか
ここからはAICompanyの応用案です。たとえば記事を公開するエージェントで、「承認前の原稿を公開しようとした」という失敗を考えます。
最初に保存したいのは、危険な要求を作ったモデルの出力です。そして修正後の公開前チェックへ、その同じ要求を渡します。テストでは「公開を止めた」「外部への送信処理を呼ばなかった」という条件を確認します。実際の投稿先には接続せず、テスト用の送信先を使います。
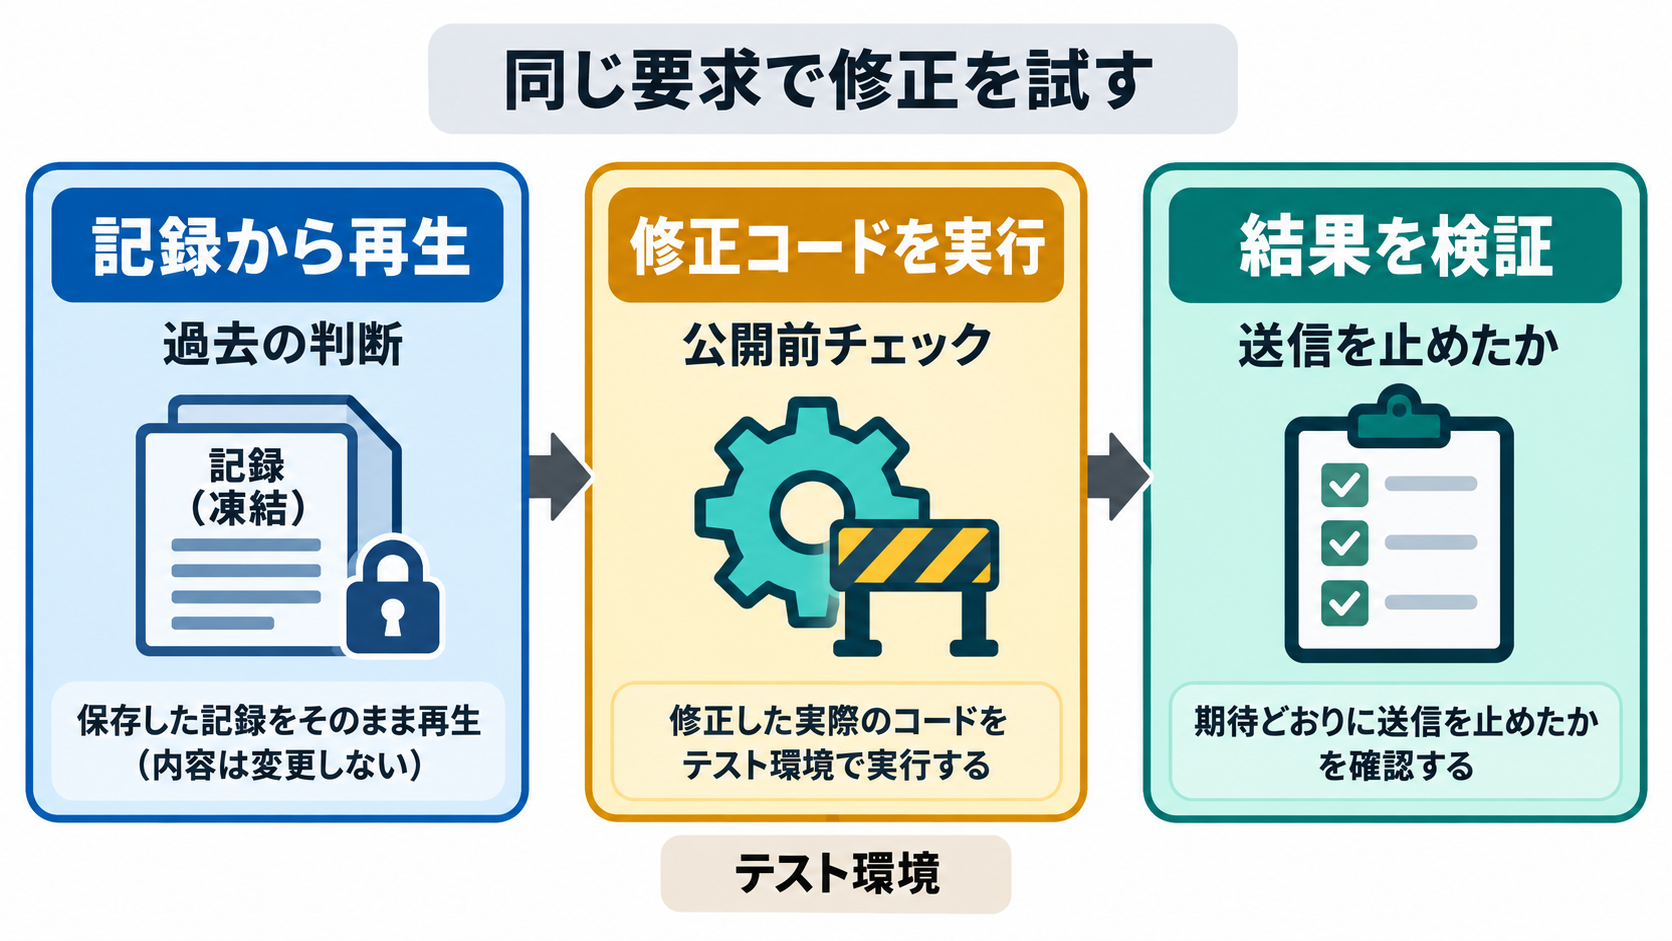
同じ依頼をモデルに投げ直して、今度は承認を求めたから合格、という確認よりも、追加したチェックを直接試せます。モデルの判断が再び揺れても、同じ種類の操作を止められるかが分かります。
運用上は、成功例だけでなく、直したい失敗を一件ずつテスト資産として残すことに価値がありそうです。ただし、この公開フローへの適用自体を今回実装・検証したわけではありません。
再生できる範囲には、はっきりした限界がある
最も大きいのは、記録する対象を開発者が選ぶ点です。印を付けていない外部呼び出しや、ツール内部で参照する時刻・データベースの状態までは、自動で固定されません。保存されるのは境目の入出力であって、関数の中で起きたすべての出来事ではありません。
また、論文で評価した版は、並列ツール呼び出しを扱わず、ストリーミング応答は組み立て後の形で記録します。記録済みの例外を、再生時にそのまま投げ直す機能も未対応です。同じ名前の処理が同じ回数だけ呼ばれるかは確認しますが、回数を保ったまま順番が入れ替わるケースは検出できません。
新しいコードを実行する部分が、本物の削除や送信につながっていれば、その操作は動き得ます。テスト対象を隔離することと、記録に含まれる入力や個人情報を管理することは、別途必要です。
そもそも今回の6事例は、事例、修正、判定条件を著者がそろえて作った小さな評価です。長いループ、多数の再試行、複雑なエージェント間の振り分けで、どれだけ有効かはまだ分かりません。
「同じ失敗に修正が効くか」を、繰り返し問える
Chronicleの価値は、モデルを賢くすることよりも、モデルの不安定さに巻き込まれずに周辺コードを検証する道具を示した点にあります。
エージェントが今回はうまく動いた。それだけで安心するのではなく、以前の危険な要求をもう一度渡しても止められるかを確かめる。そのために、判断の記録と、修正したコードの実行を組み合わせます。
実運用全体の信頼性を保証する段階ではありません。それでも、失敗ログを読んで終えるところから、次の変更でも同じ失敗を防げるか確かめるところへ進む、小さく具体的な一歩です。