
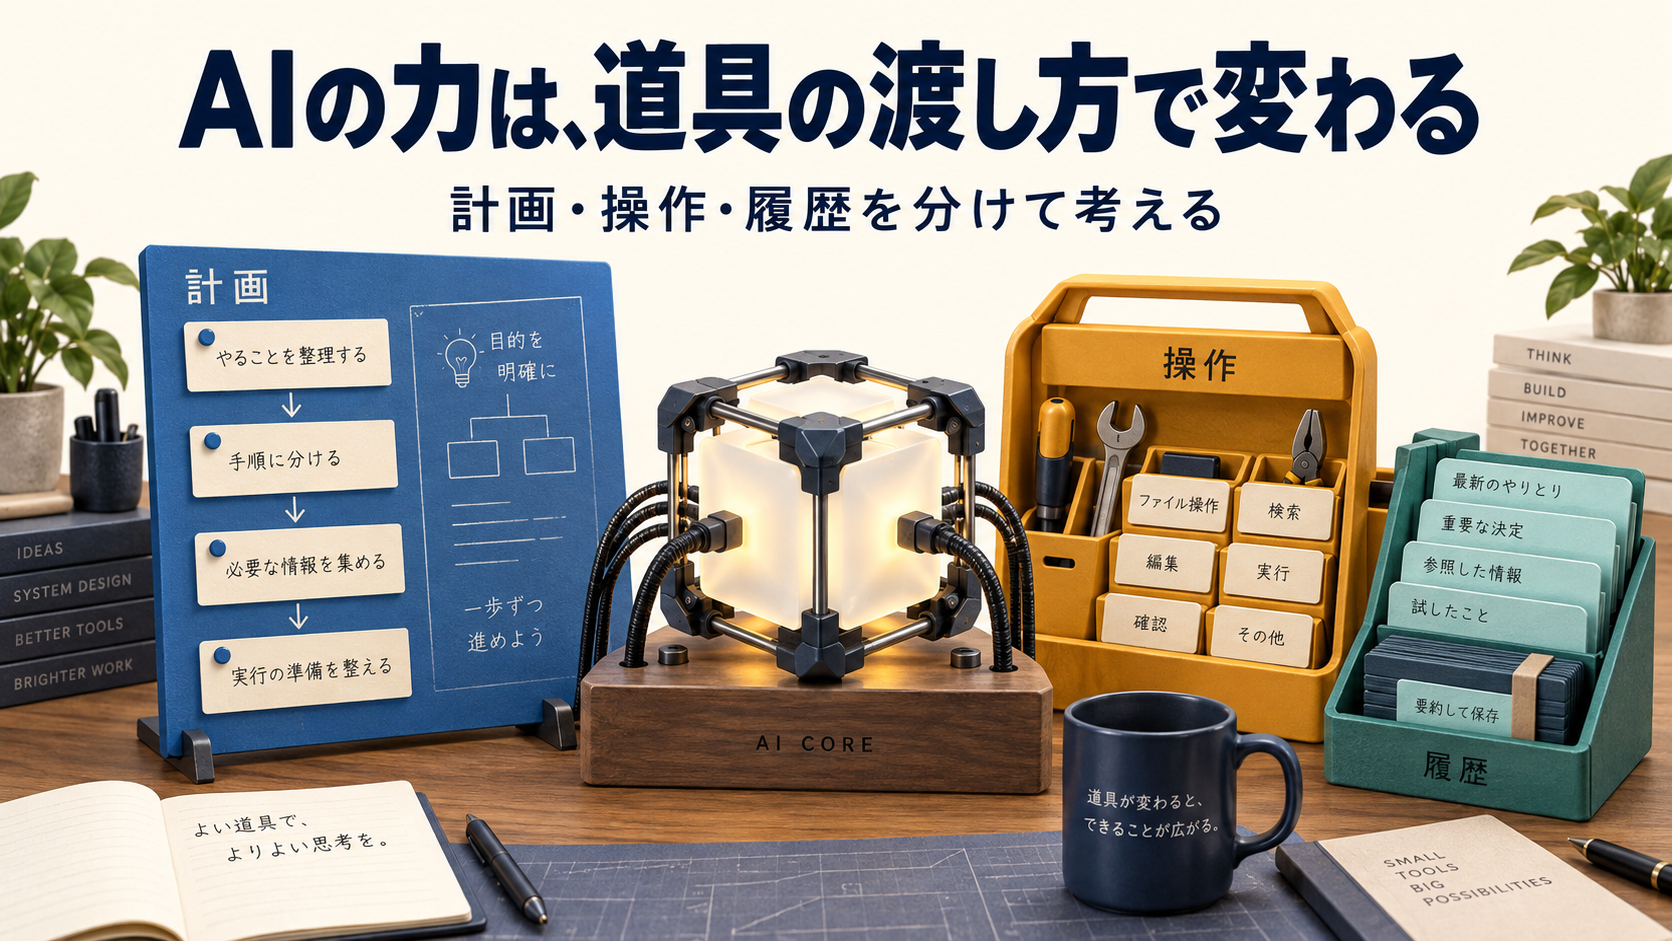
ファイルを読む専用ツールも、編集する専用ツールも外す。コーディングAIには、コマンドを実行するbashを中心に仕事をしてもらう。それだけで成績が上がり、計算上の費用が半分近くになるモデルがありました。
ところが、同じ変更で成功率が68.6%から45.4%へ落ちるモデルもあります。便利な道具を片づけたら仕事が速くなる人もいれば、道具箱ごと持っていかれて困る人もいる。AIでも、この違いは無視できません。

2026年9月17日公開の論文「An Empirical Study of Harness Design for Coding Agents」は、モデルを取り巻く仕組みを部品ごとに変え、どの条件で役立つかを調べています。結論を先に言えば、エージェントの機能は、増やすほど優秀になるわけでも、減らすほど効率的になるわけでもありません。どこで失敗しているかと、モデルが使いこなせる操作に合わせる必要があります。
モデルの外側にある「仕事の進め方」を比べた
ここでいうハーネスは、モデルに作業環境を与えるソフトウェアです。何を入力として渡し、どのツールを使わせ、長くなった履歴をどう整理し、いつ次の操作へ進むかを決めます。
たとえば、同じ人に同じ修理を頼んでも、手順書、工具、作業記録の置き方が違えば進み方は変わります。AIモデルの能力だけを見ても、実際の作業結果は決まりません。
この研究の面白さは、完成したエージェント同士の順位を比べる代わりに、共通の実行ループの上で三つの部品を変えたことです。比較対象は、計画を保持する仕組み、ファイル編集などの操作インターフェース、会話履歴を整理するコンテキスト管理でした。
対象はNemotron-3の30B、120B、550Bと、Mistral-Medium-3.5-128Bの4モデル。評価には、実際のリポジトリの問題を直すSWE-Bench Verifiedの500課題と、コマンドライン上の作業を行うTerminal-Bench 2.1の89課題を使っています。
履歴管理は5方式、入力できる履歴の予算は32K、64K、96K、128Kの4段階です。これに計画と操作インターフェースを切り替える比較を加え、全体で176設定になりました。176件の仕事という意味ではありません。また、計画と操作の比較はT4という履歴管理方式と128Kの予算に固定されており、すべての組み合わせを試した実験でもありません。
専用ツールを外すと、結果が逆転する
まず注目したいのが、SWE-Bench Verifiedでの操作インターフェースの比較です。計画あり、履歴管理T4、128Kという共通条件で、論文の表3には次の結果が載っています。
| モデル | 操作インターフェース | 成功率 | 1課題あたりの換算費用 |
|---|---|---|---|
| Nemotron-3 550B | 専用ツールあり | 65.8% | 2.33ドル |
| Nemotron-3 550B | bash中心 | 69.4% | 1.11ドル |
| Mistral-Medium-3.5-128B | 専用ツールあり | 68.6% | 3.14ドル |
| Mistral-Medium-3.5-128B | bash中心 | 45.4% | 1.72ドル |
出典:論文表3、T4・128K・計画ありの比較。費用は使用トークンに2026年8月時点の単価を当てた計算値です。ローカルGPUの実費や、現在のサービス料金ではありません。
Nemotron-3 550Bでは成功率が3.6ポイント上がり、費用は下がりました。一方、Mistralでは費用こそ下がりましたが、成功率は23.2ポイント低下しています。失敗して早く終わっても、費用は安く見えます。費用だけを眺めると、仕事ができなくなった変更まで「改善」に見えてしまうのです。
著者らの軌跡分析では、bashを使いこなすモデルは、複数の編集を一度の操作にまとめられます。反対に、期待するツールが存在しないために操作が通らなかったり、修正に入る前の探索でつまずいたりするモデルもありました。
ただし、この比較を「ツールの数を減らした効果」とだけ読むのは正確ではありません。専用ツールを外すと、操作の説明、ファイル状態の追跡、編集後の自動診断なども変わります。また論文のbash-only条件でも、計画更新や履歴の再取得に使う補助ツールは残っています。あらゆる機能をbash一つに統一した実験ではない点も押さえておきたいところです。
履歴は、いきなり全部要約しない
もう一つの柱は、作業が長引いたときの履歴整理です。AIに渡せる情報量には上限があり、検索結果やテスト出力を積み続けると、修正に必要な情報を扱いきれなくなります。
論文でT4と呼ばれる方式は、この整理を段階的に行います。最初の指示と直近のやり取りを残し、その間にある古い大きなツール出力を先に短い参照情報へ置き換える。元の出力は外部に保存し、必要なら取り出せるようにする。それでも履歴が大きければ、さらに古い部分を要約します。
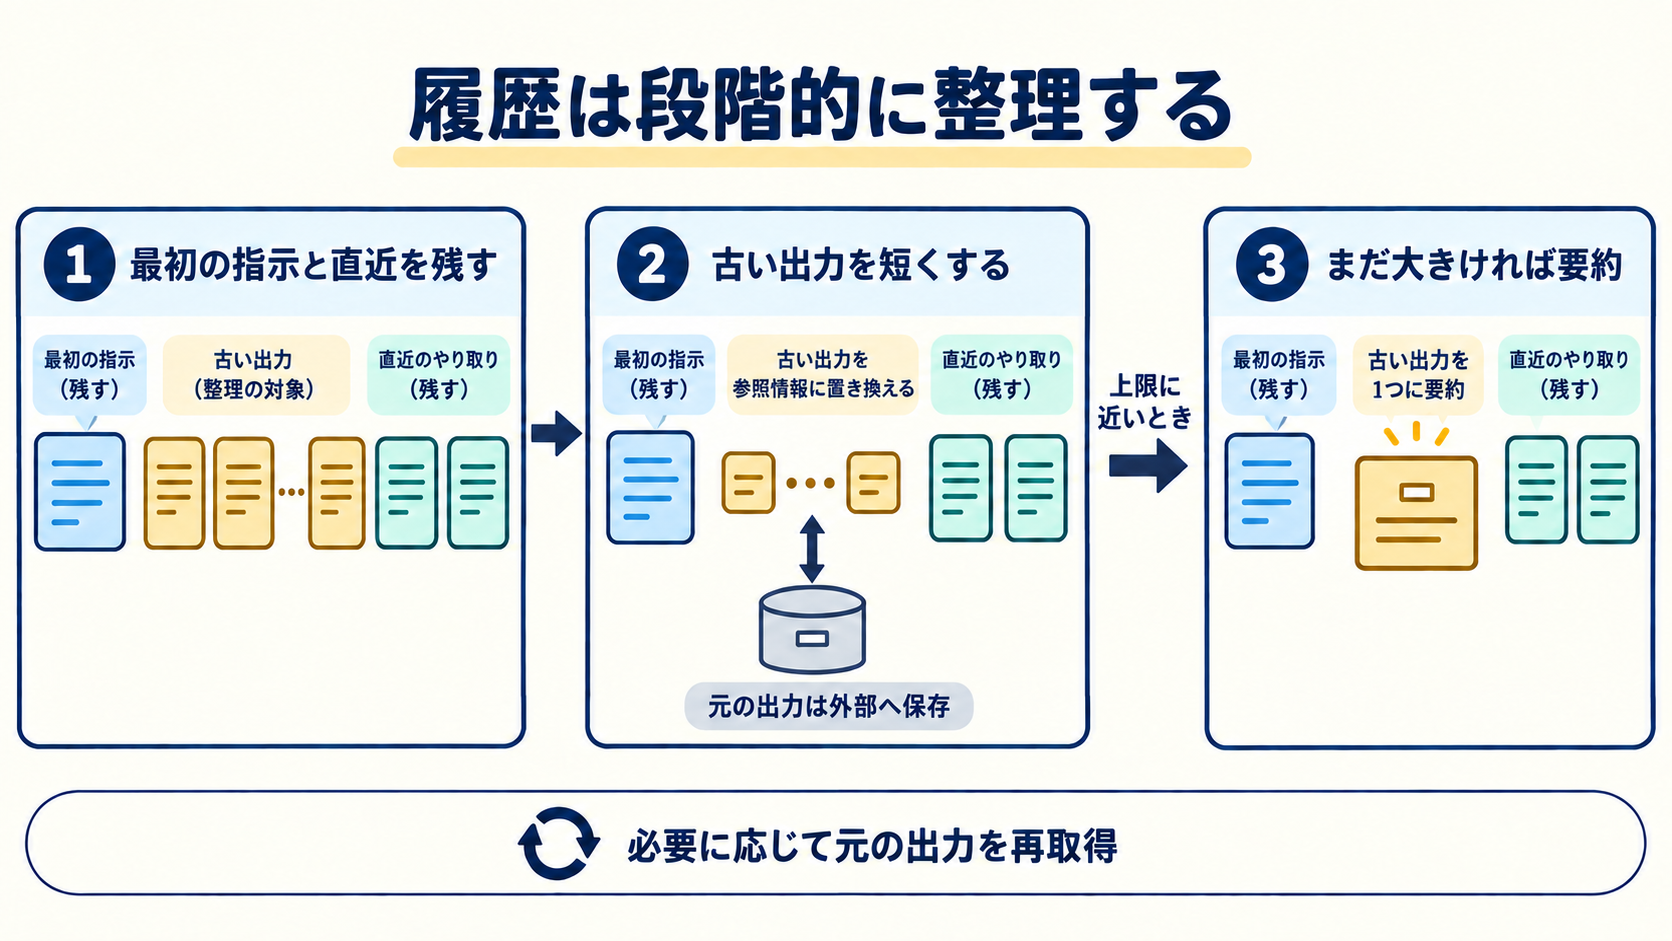
ポイントは、要約にもモデルの計算が必要だということです。古い出力の本文を機械的に置き換えて済むなら、先にそれを行う。要約は、その後でも足りないときに使います。論文では、T4が評価した方式の中で全体として良い費用効率を示しましたが、すべての条件で最高の成功率や最小費用だったわけではありません。
履歴管理が特に役立ったのは、入力予算が小さい条件です。著者らは、その効果の大部分を、履歴の上限に達して作業が途中終了する失敗を防いだためと説明しています。これは「圧縮すると推論そのものが賢くなる」とは違う話です。まず最後まで作業する余地を作った、と読む方が実態に近いでしょう。
なお、保存した出力を取り出す仕組みは、多くの条件であまり使われませんでした。ただし利用が増える条件もあり、この実験だけで履歴検索や外部記憶全般を不要とすることはできません。必要なときに呼べる設計と、実際に呼んで役立てる能力は別々に確かめる必要があります。
計画は、正答率を上げることも、仕事を早く切り上げることもある
計画機能も万能ではありません。この研究で試したのは、最初に計画を作らせ、作業中に更新できるようにし、その計画を後続の入力へ渡す具体的な仕組みです。「考えてから行動する」こと全般の検証ではありません。
SWE-Bench VerifiedでNemotron-3 30Bを使った場合、計画なしの成功率13.6%に対して、計画ありは25.2%でした。ただし換算費用も0.02ドルから0.09ドルへ増えています。途中で終わっていた作業を続けられるようにした分、計算も必要になったわけです。
一方、Nemotron-3 550Bでは、計画を加えると費用が3.31ドルから2.33ドルへ下がる一方、成功率は67.8%から65.8%へ少し下がりました。著者らは、強いモデルで見られた費用削減を、修正後に繰り返していた検証が減ることと関連づけています。
ここから「テストを減らそう」と飛躍するのは危険です。成功率との交換条件があり、仕事の種類も限られています。実務で見直すべきなのは、必要な確認まで省くことではなく、同じ証拠を得るための操作を無意味に繰り返していないか、という点です。
自分のエージェントなら、失敗した場所から一つずつ試す
ここからはAICompanyの応用案です。論文の成績を再現した結果ではありません。
最初に、普段の作業から小さな課題セットを用意します。たとえば修正対象と合格条件が明確な10件を選び、開始時点のファイル、モデル、入力予算、実行上限、合格判定を固定します。10件は最初の診断用の例であり、一般的な性能差を証明する規模ではありません。
各課題について、成功したかだけでなく、「履歴上限で止まった」「編集前に終わった」「編集後のテストに失敗した」「同じ確認を繰り返した」を分けて記録します。その上で、目立つ失敗に対応する部品を一つ変えます。
| 目立つ症状 | 最初に比較したい変更 | 一緒に見る指標 |
|---|---|---|
| 長いログの後で途中終了する | 古い出力の置き換えや段階的な要約 | 上限到達件数、成功件数、整理の費用 |
| 調査だけで終わり、編集に進まない | 計画を後続の入力へ渡す仕組み | 編集に進んだ件数、成功件数、総費用 |
| ツール名や引数の扱いで失敗する | モデルに合う専用操作の用意 | 操作エラー件数、成功件数 |
| 修正後に同じ確認を繰り返す | 完了条件と計画の更新方法 | 重複確認、必要な検証の実施、成功件数 |
「圧縮を入れる」と「ツールを減らす」を同時に変えると、何が効いたかが分かりにくくなります。同じ課題を使い、変更前後を対応させ、できれば複数回試す。成功件数と費用を並べ、失敗が増えたのに安くなっただけではないかを確認します。
この記録があると、モデルを乗り換えたときにも、以前の設定をそのまま信じずに済みます。モデルが変われば、得意な操作や途中終了の癖も変わり得るからです。
この結果を、そのまま全モデルへ広げない
この研究には、はっきりした限界があります。各課題・各設定の実行は1回で、モデルは二つの系列、評価も二つのベンチマークです。SWE-Bench VerifiedはPythonの課題であり、Terminal-Bench側は89課題なので、個々の比較で統計的な差が確認できないものもあります。
さらに、計画やbash中心の構成はT4・128Kでしか比べていません。別の履歴管理方式や小さい予算でも同じ結果になるとは限りません。作業軌跡の分類にはLLMによる判定が使われ、人手での照合も行われていますが、「なぜ変わったか」の説明には、その分類の不確かさも残ります。
AICompanyでは論文の本文、表、実験条件を確認しましたが、全モデルの実験は再実行していません。論文中から、この実験用ハーネスそのものの公開実装リンクも確認できませんでした。既存の開発ツールへの言及を、研究用コードの公開と取り違えないようにする必要があります。
それでも、この研究は設計の良い出発点になります。エージェントが失敗したとき、モデルを大きくする前に、どの段階で止まり、どの情報や操作が足りなかったかを見直す。機能の多さではなく、失敗の原因に合う助け方を選ぶ。 そのための比較方法まで示しているところに、この論文の実務的な価値があります。
参考文献
- Run-Ze Fanほか「An Empirical Study of Harness Design for Coding Agents」、arXiv:2609.20804v1、2026年9月17日公開。
- 論文本文:第2節(仕組み)、第3.1節(条件)、表3・4(結果)、第4節と付録9.2(軌跡分析)、Limitations(限界)。