
「コンテナのビルドが通りました」。それでも、利用者がアクセスすると画面は開かない。サービスが起動してもデータベースにつながらず、監視も異常を知らせない。開発中の確認と、実際に使える状態には距離がある。
2026年9月23日に公開されたFDE-Benchの論文は、この距離をAIエージェントの評価対象にした。Docker、Compose、Kubernetesを使う136の配備課題を用意し、AIが書いた設定をまっさらな環境に適用して検査する。7モデルを同じ操作環境で比べると、最良のモデルでも全条件を満たしたのは75.0%だった。

数字だけで「AIはデプロイを任せられない」と決めるのは早い。面白いのは、何をもって配備完了と呼ぶかを、段階ごとに見える形にしたことだ。
コードのテストと、動くサービスの検査は違う
従来のソフトウェア開発ベンチマークは、リポジトリのコードを修正してテストに通す能力を測るものが多い。しかし配備には、依存関係を入れたイメージの作成、サービス間の接続、起動後の安定性、監視、権限や秘密情報の扱いまで必要になる。
FDE-Benchの課題では、エージェントは依頼文、配備仕様、アプリケーションのソースと不完全な設定を受け取り、宣言的な設定ファイルを作成または修正する。課題は新規構築66件と修復70件。アプリ自体はベンチマーク用に作られたもので、一般の企業システムをそのまま持ち込んだものではない。論文の課題定義
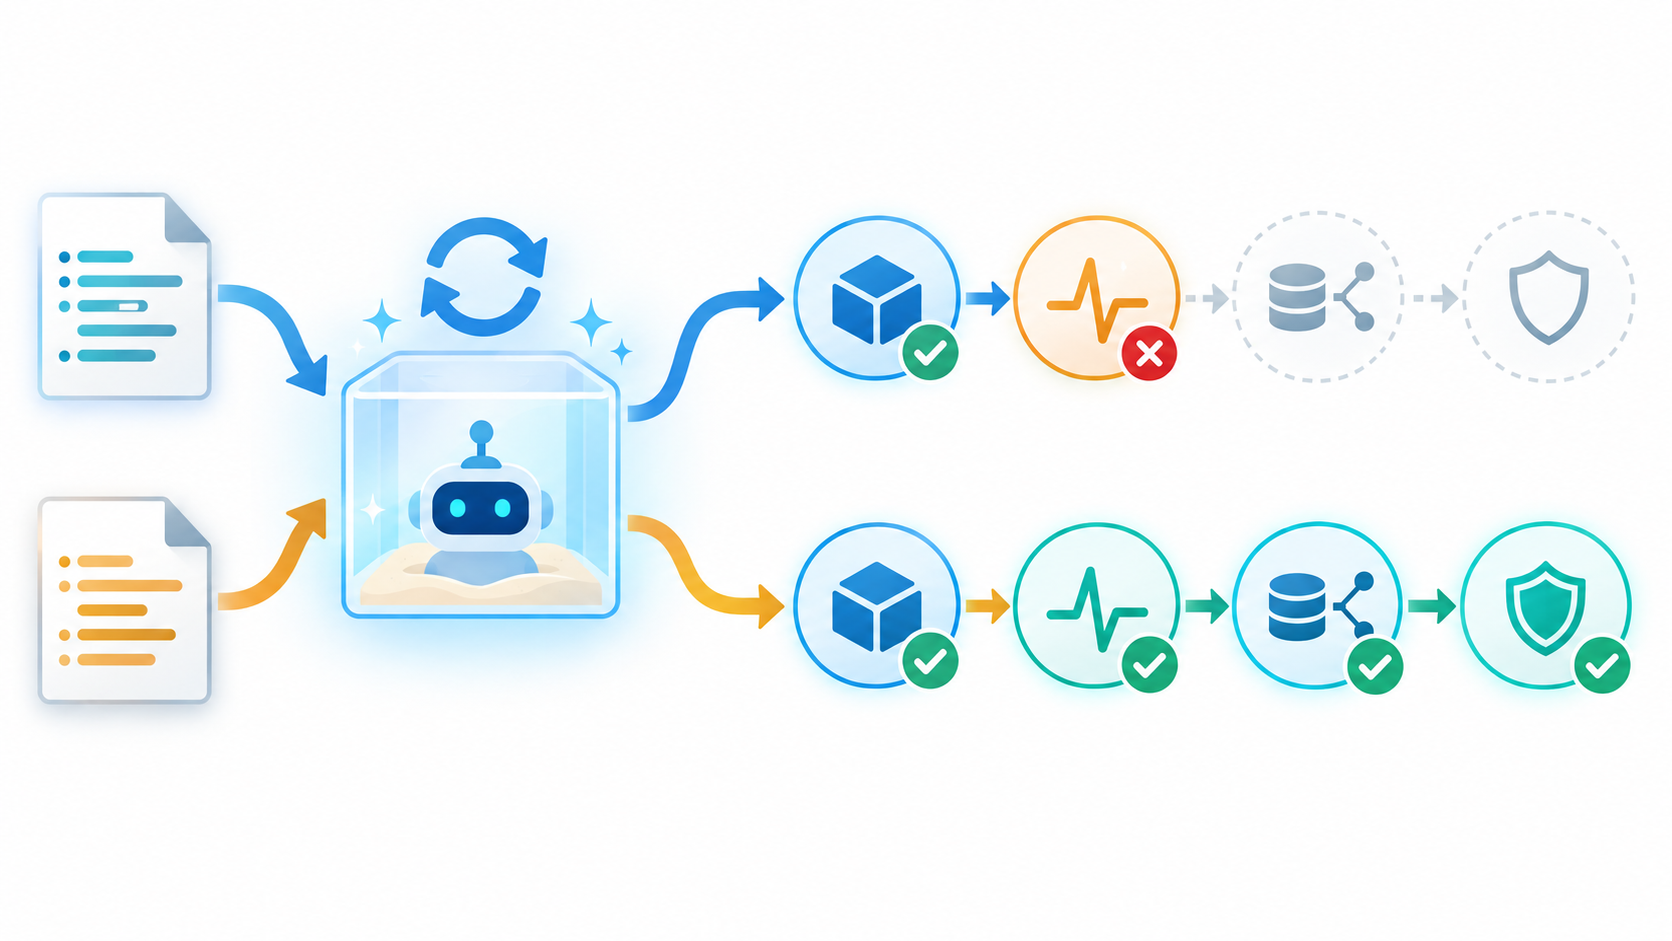
ここで重要なのは、作業中の環境がたまたま動いていても点を与えないこと。提出時には評価対象のDockerfileや設定ファイルなどだけを回収し、稼働中の環境を破棄する。そのファイルを初期状態の環境に重ね、改めてビルドと配備を行う。手元で一時的に起動したコンテナや、後から注入した秘密情報は採点に残らない。
4つの関門を通って、初めて「配備できた」
検査は4層に分かれる。
- ビルド:設定からイメージが作れ、指定された制約も守る。
- 起動の安定:サービスがReadyになり、定めた観察時間のあいだ状態を維持する。
- 実際の動作:APIの応答、サービス間の往復、監視指標、異常時のアラートまで確認する。
- 仕様への適合:レプリカ数、イメージ容量、非root実行、平文の秘密情報を置かないことなどを調べる。
ビルドと起動が通らなければ、後段の点は付かない。動作と仕様適合は、起動を前提に並行した要件として評価される。4層すべてが通って初めて「解決」だ。判定はプログラムによる検査で、AIがAIの答案を採点する方式ではない。評価手順と採点式
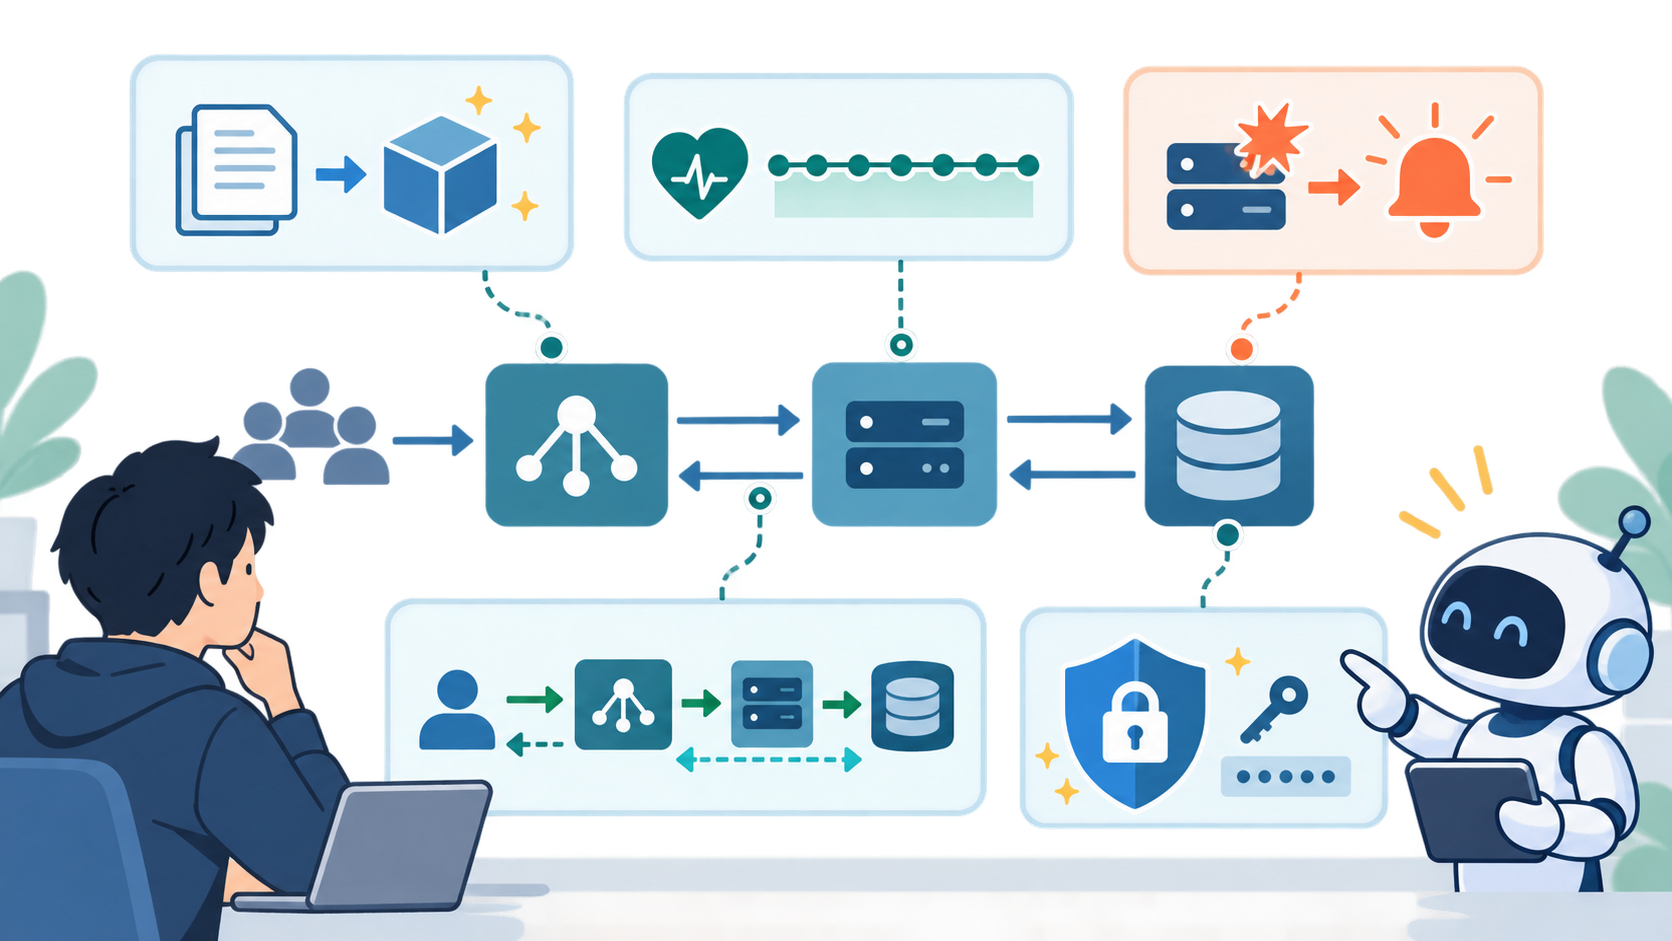
たとえばAPI、ワーカー、データベースを使う配備なら、コンテナが作れても、ワーカーからデータベースへ届かなければ利用者の仕事は進まない。ヘルスチェックが常に「正常」と返すだけでも、本当の故障は見逃す。論文の検査は、異常を注入したときにアラートが出て、正常時には鳴らないところまで見る。
失敗が最も集まったのは「起動した後、安定しない」段階
論文のv1.1評価では、7モデルがそれぞれ136課題に1回ずつ挑戦した。最良のGemini-3.6-Flashは75.0%、次のClaude-Sonnet-5は72.8%。ただし、この2モデルの差は論文のペア比較で有意とは認められていない。順位表の小さな差を一般的な能力差と読まないほうがよい。表1と比較の説明
未解決の313回を失敗段階に振り分けると、ビルド52、起動の安定110、動作97、仕様適合54。最大は、作れたものが安定してReadyにならない段階だった。ここにはイメージ取得やサービスの立ち上がり、接続やヘルスチェックの条件が絡む。見栄えのよい設定ファイルだけでは、動くかどうかは分からない。失敗段階の内訳
修復課題の平均解決率は82.0%、新規構築は51.3%で、差は30.7ポイント。もっとも、この2群は同じ課題を「設定あり」「設定なし」で解き直した比較ではなく、別々の課題群だ。既存設定がヒントになる可能性はあるが、この数字だけでその因果効果を測ったとは言えない。
別の25課題では、実務者1人がClaude Codeを操作した場合に23件を解決し、自律動作のClaude-Sonnet-5は同じ課題で18件だった。人の判断が助けになる可能性を示す一方、操作画面の豊かさも異なり、対象者は1人だけ。統計的な比較結果も慎重に読む必要がある。人間支援の比較
実務で試すなら、合格条件を先に書く
ここからはAICompanyの応用提案で、論文が企業の本番運用で実証した手順ではない。
AIにデプロイ設定を書かせるなら、最初に「設定ファイルを作る」より一歩先の合格条件を小さく定義したい。たとえば、自分たちの検証環境で次の順に確かめる。
- 提出物だけを新しい環境へ持っていき、手作業で作った状態がなくても再配備できるか。
- 起動直後だけでなく、一定時間Readyが保たれるか。遅いウォームアップも想定する。
- 外側の入口から一件の要求を送り、必要な別サービスまで通って結果が返るか。
- 故障を意図的に起こし、監視が検知するか。正常時に誤報しないか。
- 権限、秘密情報、レプリカ数など、その現場で欠かせない条件を別に検査する。
これなら、失敗したときに「AIの設定が悪い」で片づけず、どの段階で止まったかを追える。記事を自動公開する仕組みでも同じ発想が使える。ファイルの生成、下書き保存、公開ページの表示、画像の読み込みは別々の確認項目だ。
この結果を持ち出す前に知っておきたいこと
FDE-Benchのアプリは課題用に新しく作られ、実務でありそうな構成を模している。企業固有の権限、ネットワーク、運用者の承認まで再現した評価ではない。また、各モデルと課題の組み合わせは1回の実行なので、同じ条件をやり直したときの成否の揺れは分からない。起動時刻やネットワークに関わる検査は、評価側の負荷にも左右される。
論文は、自分たちの初期評価で仕様書から隠し検査の条件が推測できてしまった問題や、採点環境の欠陥を見つけ、修正した経緯も記している。v1.1でも、仕様の文言と対応しない検査が7件残ると開示した。評価器を疑い、直した履歴まで読むことが、このベンチマークを評価するうえで大切だ。限界と再現性声明
AICompanyは論文と公開説明の数値、条件を照合した。136課題の配備実験そのものは再実行していない。したがって、ここで紹介した成功率は著者らの測定値だ。
FDE-Benchが示す実務的な教訓は、AIの作業を「設定を書いた」「ローカルで動いた」で終わらせないこと。提出物を新しい環境に置き直し、起動、動作、仕様をそれぞれ確かめる。完了の条件を具体的にすると、AIを使う場所と、人が確認すべき場所も見えやすくなる。