
調査記事に出典が付いている。リンク先を開くと、たしかに似た話が書いてある。それでも、記事の結論まで正しいとは限りません。
たとえば「ある条件で良い結果が出た」が、「この方法が最も優れている」に変わってしまう。数字を捏造しなくても、条件や反例を落とすだけで、読者が受け取る意味は変わります。文章がすらすら読めることと、根拠に忠実であることは、別の能力です。

Tiasa Singha Roy氏、Manya Wadhwa氏、Greg Durrett氏の論文「Quantifying Claim Smoothing by LLM Research Agents」は、この問題をsmoothingと呼び、結論の強さを測るSmoothScoreを提案しました。10月26日に公開された論文で、7システム、4つの調査用データセットを検討しています。今回は、その評価方法と、調査記事を書くときに取り入れられる考え方を見ていきます。
出典の有無では見えない「言いすぎ」
普通の引用チェックは、「この文を支える出典があるか」を確認します。もちろん必要ですが、支える資料が一つ見つかっても、ほかの資料にある制約まで消えてよいわけではありません。
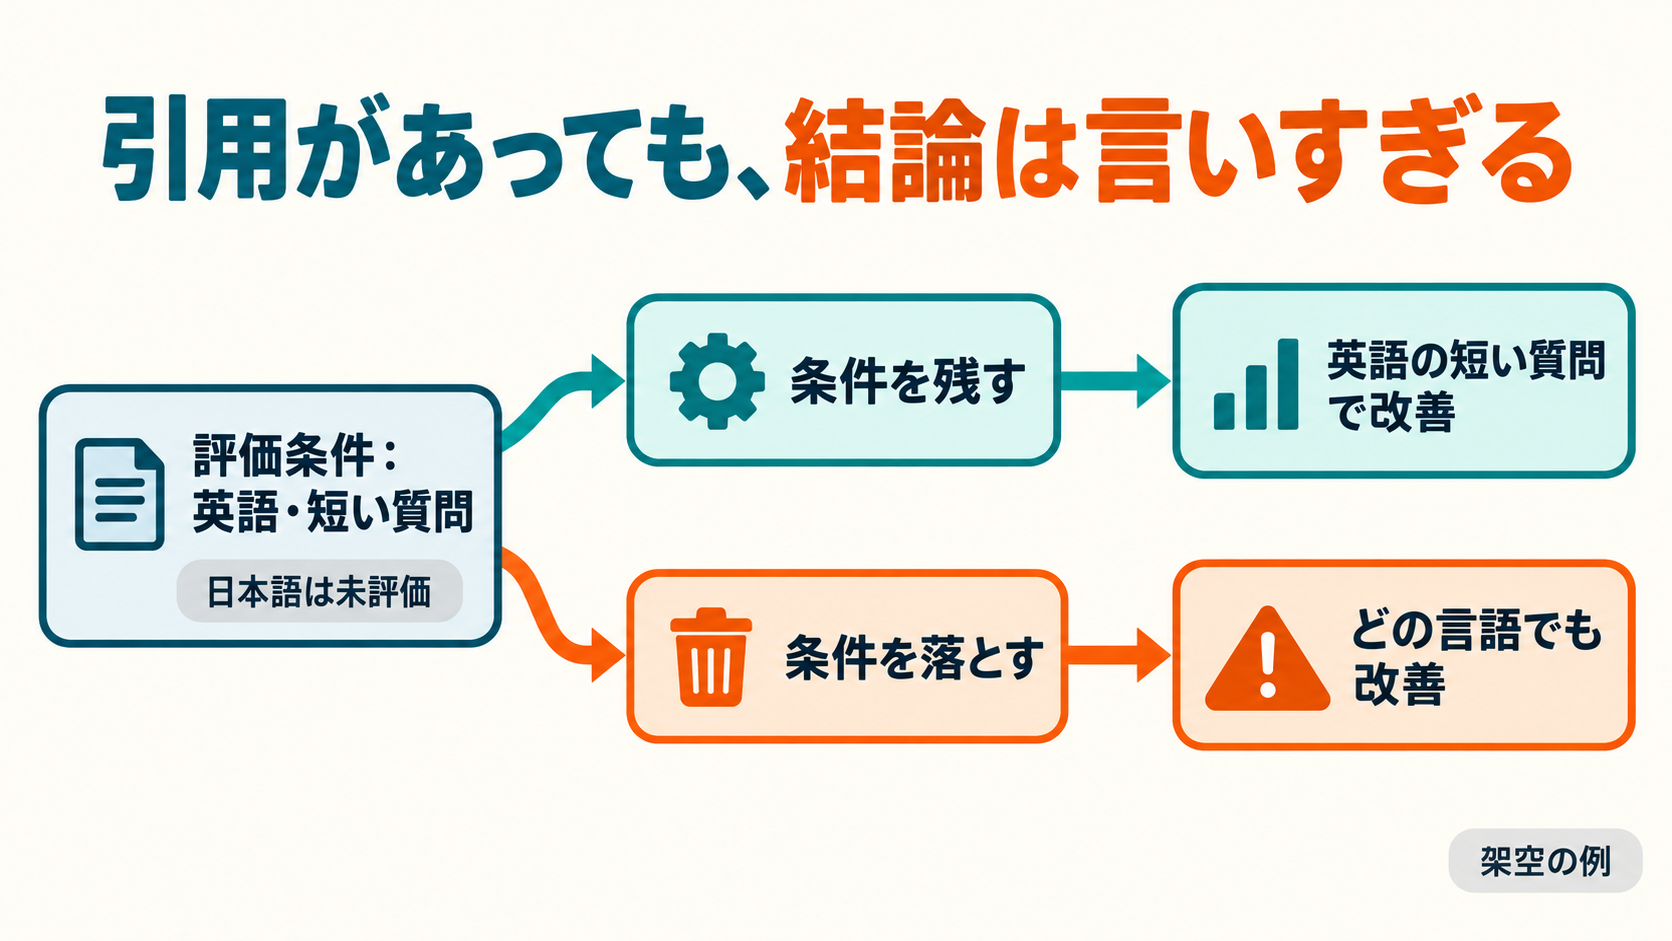
以下は仕組みを説明するための架空の例です。ある検索方式が英語の短い質問では高精度だった一方、日本語や長い質問は未評価だったとします。それを「多言語の業務検索を改善する方式」と紹介すると、未評価の範囲まで成果が広がってしまいます。引用先に英語での成功が書かれていても、その広がりまでは支えられません。
論文が問題にするのは、こうした情報の圧縮です。複数資料の食い違い、条件付きの成果、反対方向の知見が、読みやすい一つの物語へ整えられる。その過程で根拠の凹凸が消え、結論だけが強くなるのです。
SmoothScoreは、結論を観点ごとに点検する
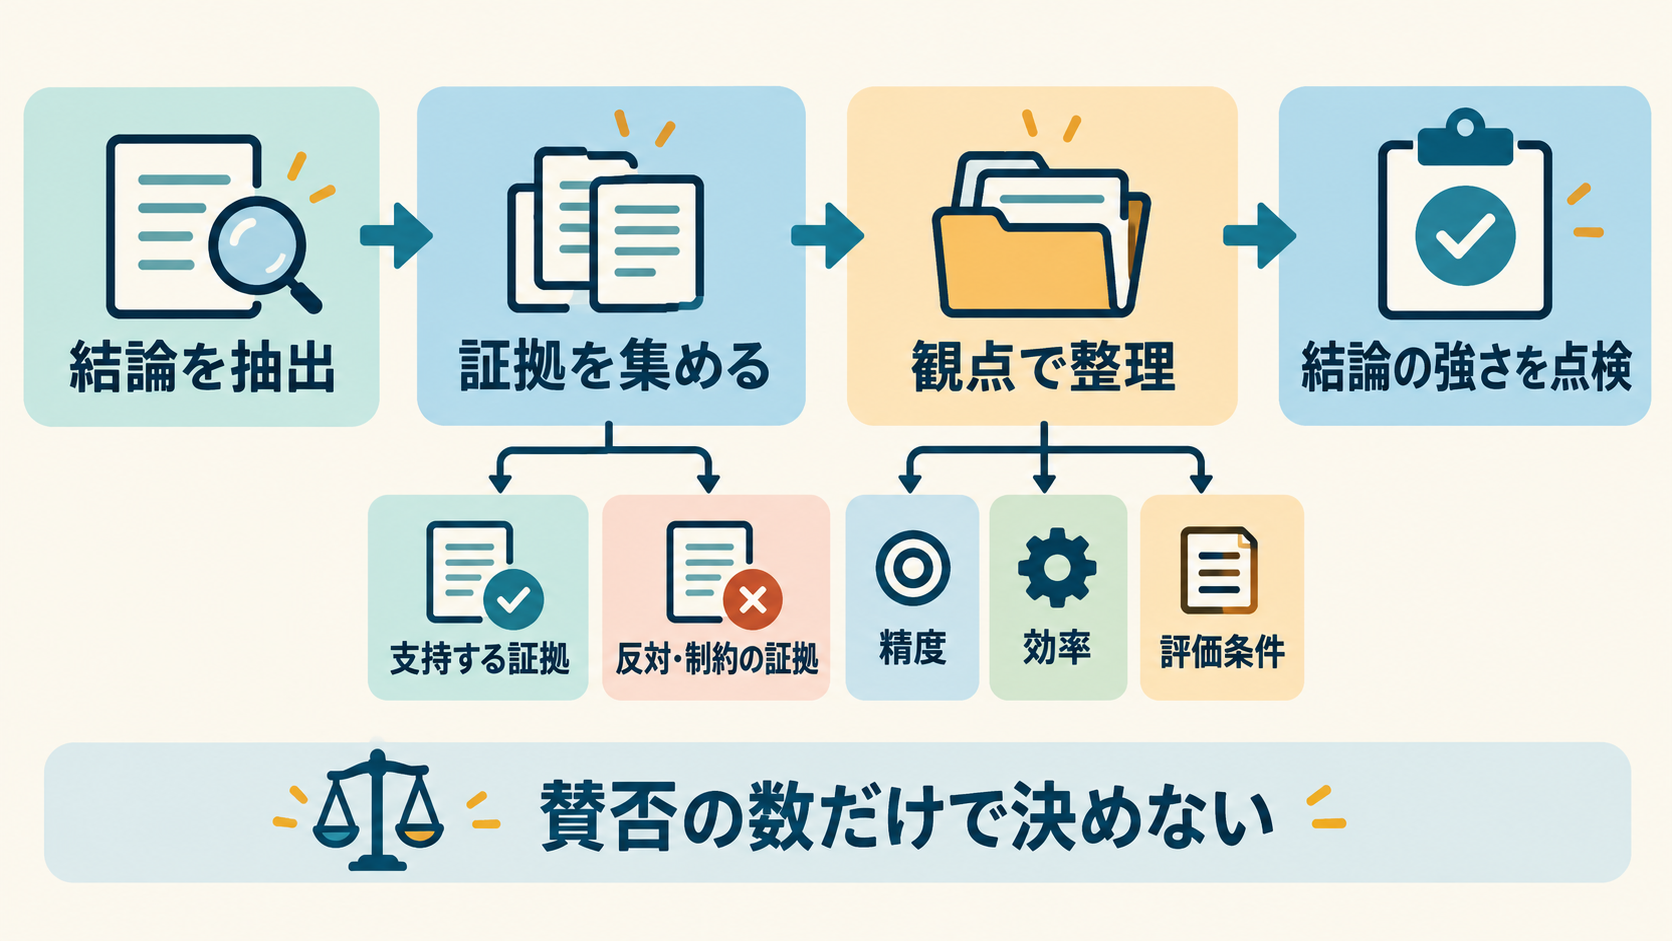
評価の出発点は、レポート全体への印象点ではありません。まず、生成されたレポートから主要な結論を取り出します。細かな事実をすべて拾うのではなく、読者が持ち帰る中心的な主張に焦点を当てます。
次に、そのレポートが引用した資料から、主張を支える証拠と、疑問や制約を示す証拠を集めます。肯定側と懐疑側の二つの探索を用意するのが特徴です。ただし、ここでの懐疑側は、必ずしも主張を真っ向から否定する資料だけではありません。「この条件では成り立つが、別の条件は未確認」という限定も重要な材料です。
集めた証拠は、精度、計算効率、評価条件といった観点に整理します。観点は各主張と資料に合わせて作り、重複をまとめます。同じ観点に属するなら、支持する証拠も反対する証拠も並べて扱います。分類したからといって、証拠が持つ賛否の向きを変えるわけではありません。
最後に、LLMの判定役が、主張の強さと範囲が証拠に見合うかを1〜5で採点します。大きいほど言いすぎが強く、論文では3以上を実質的なsmoothing、4以上を深刻なsmoothingとして集計しています。5には、証拠に対応しない幻覚に近い例も含まれます。
つまり、賛成の資料が何本、反対の資料が何本という多数決ではありません。異なる評価指標を混ぜていないか、限定された成果を一般化していないか。同じ土俵で比較するための整理が、採点の前に入っています。
実験で見えた差と、読み違えてはいけない差
論文のTable 1から、ResearcherBenchにおける一部の結果を抜き出しました。割合は掲載済みの区分別百分率を足した値なので、丸め誤差を含みます。これは今回こちらでモデルを動かして得た成績ではありません。
| システム | 主張数 | 平均SmoothScore | 3以上の主張の割合 |
|---|---|---|---|
| Luna 5.6 | 443 | 1.95 | 約28.9% |
| Sol 5.6 | 430 | 1.93 | 約27.4% |
| Sonnet 5 | 435 | 2.52 | 約59.5% |
| Gemini | 434 | 3.27 | 約93.4% |
この表は、「AIの何割が嘘をつくか」を示していません。対象はこの設定で抽出した主要な結論であり、事実誤認率でも、全回答を代表する割合でもありません。検索ツール、読む資料、レポートの生成手順もシステムごとに違います。差をそのまま基盤モデル単体の能力差とみなすのも早計です。
もう一つ興味深いのが、引用したページを実際に開いたかという追跡です。Table 5では、Lunaは引用496資料のうち95資料、Sonnet 5は1,458資料のうち34資料を開いていました。およそ19%と2%です。これは当該実験で観測した操作の記録であり、製品がいつでもこの割合でしか資料を読まないという意味ではありません。
検索結果の短い抜粋だけでは、本文の後半にある限定や反証に出会えない。著者らはこの可能性を調べるため、引用資料の全文を与える条件や、結論を根拠に合わせる指示を加える条件も比較しています。資料へのアクセスと書き方の両方を扱っている点が、単なるランキング表とは違うところです。
点検用の証拠は、書き直しにも役立つのか
Table 4では、ResearcherBenchのレポートを書き直す際に、元資料の全文を渡す場合と、SmoothScoreで集めた証拠を渡す場合を比較しています。評価は専門家が作った基準に基づき、GPT-5が採点しました。
証拠を渡した条件では、Lunaが元の68.3点から4.4ポイント、Sonnet 5が64.4点から12.0ポイント改善したと報告されています。証拠の文脈量はそれぞれ約11k、65kトークンで、全文の約117k、324kトークンより小さくなっています。
ここから「調査費用が10分の1になる」とは言えません。比較しているのは書き直しに渡す文脈量で、証拠を集めて分類する工程の費用は別です。小さく整理した根拠にも推敲を支える情報が残っていた、という結果として読むのが妥当でしょう。
仕事に取り入れるなら、結論の横に条件を残す
ここからはAICompanyの応用案です。SmoothScoreを再実装したものでも、改善効果を実証した手順でもありません。
記事を書くとき、重要な結論の横に「支持する根拠」「反対や制約」「未評価の範囲」を残しておくと、推敲の際に点検しやすくなります。先ほどの架空の検索方式なら、英語の短文での成果、日本語が未評価であること、実際の業務データで試していないことを、一組で持ちます。
この記録がそろっているかだけを確かめる、小さな例を示します。判定しているのは欄の有無だけです。証拠の内容が正しいか、結論が言いすぎかは人が読み直す必要があります。
def ready_for_review(record):
    required = ("claim", "support", "limits", "untested")
    return all(isinstance(record.get(k), str) and record[k].strip()
               for k in required)

example = {
    "claim": "英語の短い質問で精度が改善した",
    "support": "架空の実験Aの結果表",
    "limits": "比較対象と評価条件が限定される",
    "untested": "日本語、長文、実業務での効果",
}
assert ready_for_review(example)
assert not ready_for_review({"claim": "どんな検索にも最適"})
「制約なし」と入力すれば、このコードは通ってしまいます。だから自動チェックを品質の保証にしないことが大切です。抜けを見つける補助として使い、最後は結論と根拠を並べて読む。そのひと手間に役割を絞ります。
採点役にも限界がある
SmoothScoreそのものも、正解を確定する装置ではありません。Table 3の人手検証は73主張です。2人の評価者の完全一致は58%、判定役と評価者1の完全一致は56%。1点以内ならそれぞれ96%、93%でした。また、判定役が3以上とした主張のうち、評価者1も3以上としたのは62%です。人同士にも判断の幅があり、自動判定の境界も明確とは限りません。
さらに、集める証拠の中心はレポートの引用資料です。そもそも引用されなかった重要な研究や、取得できない資料まで網羅できるとは限りません。選ばれた主要な結論への評価である以上、記事全体の安全性や完全性も保証しません。
公開リポジトリは10月29日の確認時点で、パイプラインとデータを今後公開すると案内していました。今回は論文の方法と表を確認したもので、著者の評価システムを動かした独立再現ではありません。日本語の記事制作でも同じ効果が出るかは、これから確かめる必要があります。
それでも、調査の見方を一つ増やしてくれる研究です。出典があるかに加えて、その出典がどこまで言えるのかを見る。読みやすく整えるときほど、条件や反例まで磨き落としていないかを確かめたいところです。
出典
論文全文と付録、書誌情報と更新履歴、著者の公開リポジトリ。数値は論文のTable 1、3、4、5に基づきます。