
請求書を作るようAIに頼んだところ、ツールがタイムアウトした。もう一度実行してよいでしょうか。
答えは、エラーの表示だけでは決まりません。請求書はまだ作られていないかもしれないし、作成済みで返事だけが失われたのかもしれません。処理が裏で続いている可能性もあります。「失敗しました」と「何が起きたか分かりません」は、運用では別の状態です。

Genliang Zhu氏らの論文「Evidence-Guided Recovery for AI Agents with Ambiguous Tool Outcomes and Partial Execution」は、この分からない状態から、証拠を集めながら仕事を再開する方法を扱います。面白いのは、再試行の賢さだけでなく、完了と言ってよい条件まで決めている点です。
もう一度押す前に、何を確かめるか
人間でも、決済画面が止まると再読み込みをためらいます。AIエージェントにも同じ問題があります。ただし、請求書の作成、台帳の更新、通知の送信がつながると、途中まで終わった仕事を丸ごとやり直す危険が加わります。
論文の復旧器は、承認された仕事の残り、サービス側が約束している動作、手元の観測を受け取ります。たとえば、同じ識別子の再送を重複処理しない保証がいつまで有効か、照会結果が反映されるまで何時間かかるか、権限を実行受付時と確定時のどちらで検査するか。こうした条件によって、同じタイムアウトでも安全な次の手は変わります。
ここで重要な制約があります。研究の実装は、サービスの一般的な説明だけで動くわけではありません。起こり得る確定時刻や、その後の実行系列、重みを含む有限の遷移モデルも与えられます。現実の未知のサービスを、そのまま理解できる仕組みではありません。
「あり得る状態」を残したまま判断する
復旧器は、公開された証拠と両立する状態を複数残します。未作成、作成済み、処理中という候補が残っているなら、都合のよい一つに決めつけません。どの候補でも禁止事項を増やさない行動だけを、共通の検査で通します。
その内側で、照会する、待つ、重複排除の保証が有効なうちに再送する、独立した別の仕事を進める、許された取り消しをする、人へ引き継ぐ、といった選択を比較します。確率が小さいから危険な行動を許す、という設計ではありません。
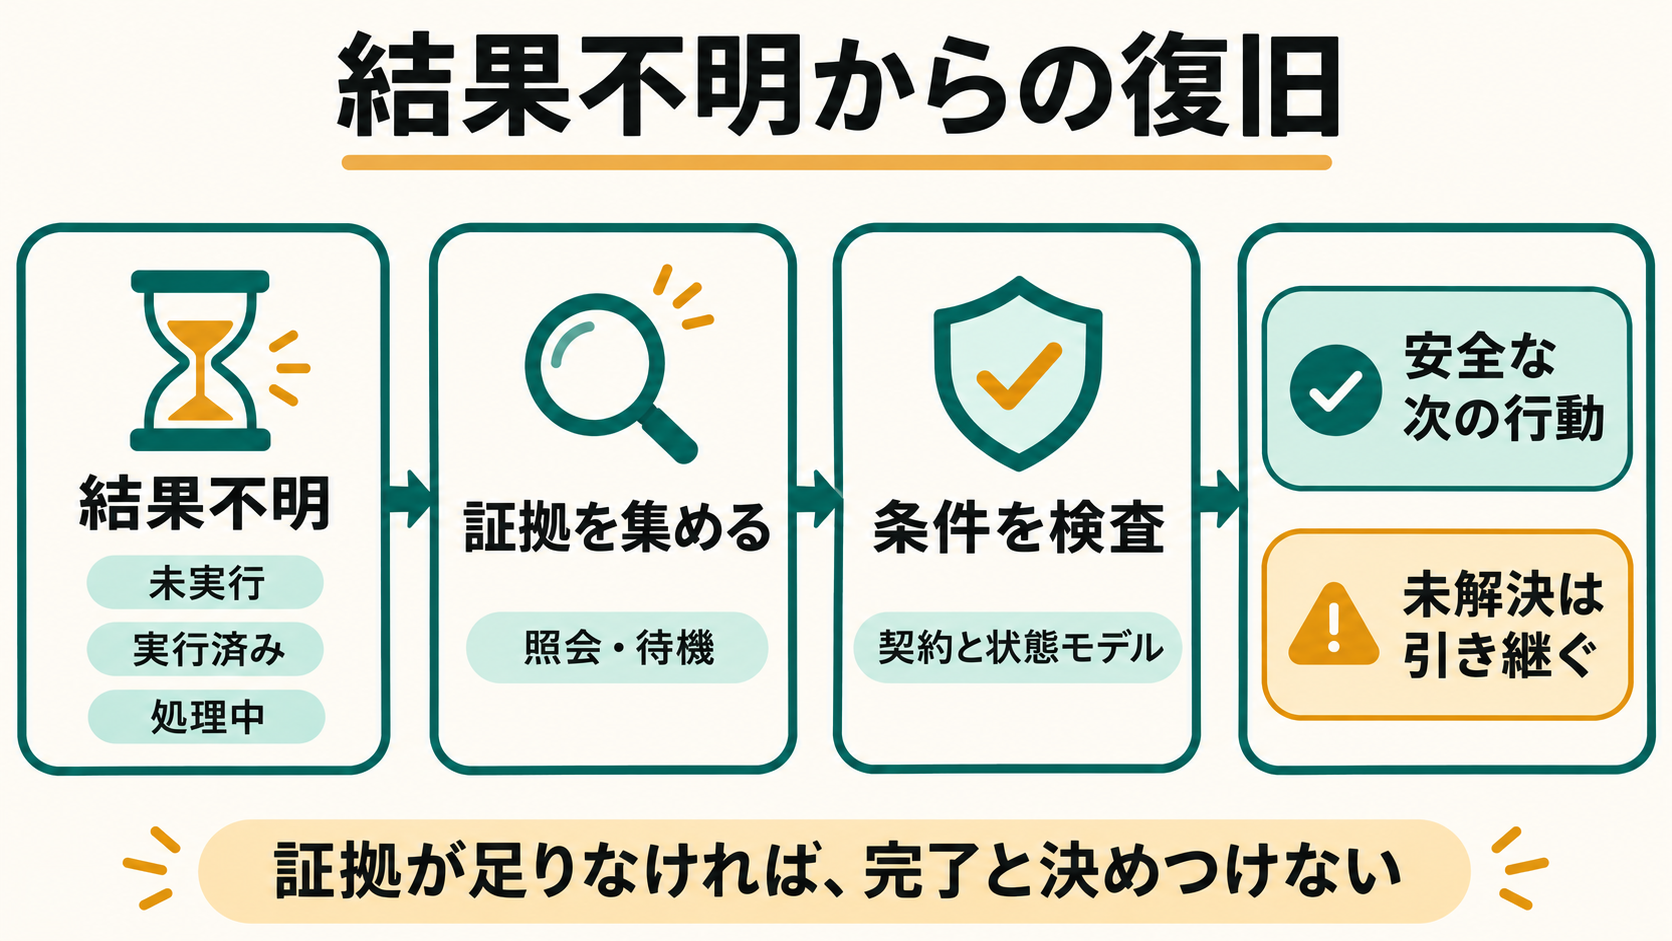
完了判定も二段階です。実際の裏側では仕事が終わっていても、手元の証拠が「まだ処理中かもしれない」を排除できなければ、完了を証明できません。また、締切時点の画面だけが正しくても、その後に遅れて届く書き込みが状態を壊すなら不十分です。論文は、宣言した有限の将来系列の途中も検査します。
確定時刻が分からない処理は、待ったからという理由だけで消しません。分からないものは、未解決として残す。この地味な扱いが、根拠のない「完了しました」を防ぎます。
実験では何が改善したのか
著者らは、まず20の公開テンプレートから37通りの内部状態を作り、5方式で評価しました。これは企業の実障害を無作為に集めた標本ではなく、仕組みを調べるために設計した有限の課題です。
| 比較 | 結果 | 読み方 |
|---|---|---|
| 決定的な復旧方式の比較 | 4つの能動方式はいずれも28/37件を安全な完了と認定 | 探索が強いルールより多く完了した結果ではない |
| ローカルモデルへの助言 | 証拠だけ9/58件、計画の助言あり30/58件 | 共通の安全検査の下で助言インターフェースを比較 |
| モデルが提案した行動数 | 399回から272回 | 実際の外部API呼び出し数とは異なる |
最初の比較では、計画方式の合成料金は188単位、能力に基づくルール方式は192単位でした。一方、現在の記録で行動選択に使った測定時間の合計は約9.53秒と約0.14秒です。共有ホスト上の記述的な計測であり、サービス応答時間でも請求額でもありません。4単位の節約だけを見て「安くなった」とは言えません(表3、表4、7.4節)。
もう一つの比較では、gpt-oss-20bとGLM-4.7-Flashの2モデルに、証拠だけを渡す場合と、計画器の次の行動の助言も渡す場合を比べています。モデルごとに29の内部状態を使うため、比較単位は58組、両条件を合わせた実行は116本です。
安全な完了の認定は9件から30件へ増え、差は36.2パーセントポイントでした。著者らの事前登録された課題群単位の検定はp=0.0078です。ただし、未使用だったのは内部状態の割り当てであり、19の課題群自体は開発中に使われています。未知の業務への汎化を確認した試験とは区別する必要があります(6.5節、表6)。
さらに、助言ありでも4件は人への引き継ぎです。これを完了に足してはいけません。安全検査は両条件に共通なので、効果を「探索のおかげで安全になった」と一括りにもできません。示されたのは、この設定で計画の助言を見せることの効果です。探索の助言とルールの助言の優劣は、別の比較が必要です。
自分の自動化なら、どこから取り入れるか
ここからはAICompanyの応用案です。論文の計画器をそのまま組み込む前に、作業記録を「予定」「実行要求」「返答」「外部で確認できた結果」に分けるだけでも、再開判断は整理しやすくなります。
たとえば記事投稿がタイムアウトしたなら、同じ記事をもう一つ作る前に、記録済みの投稿IDを読み直します。投稿があれば内容と状態を照合する。照会にも失敗したなら未解決として保存する。サービスが保証していない重複排除を、手元の管理番号だけで保証したつもりにならないことが大切です。
次は、その考え方を説明するための最小の疑似コードです。論文の探索や安全証明を再現したコードではありません。
if verified_receipt_matches_request:
    record_verified_result()
elif remote_outcome_is_unknown:
    preserve_pending_record()
    request_readback_or_handoff()
else:
    evaluate_next_action_under_provider_contract()
肝は、最後の分岐を「再実行する」にしないことです。何が分かったか、何が未確定か、どの条件で再送できるかを確認してから次を決めます。取り消しにも副作用があり、その返事まで失われることがあります。「元に戻せば全部解決」とも限りません。
まだ保証されていないこと
この研究の安全性は、宣言した状態が実際のサービスの挙動を覆い、サービスが契約に従うという条件付きです。モデルに含めなかった失敗が見えないまま起きれば、判断の前提が崩れます。現実の外部サービスすべてで、一度だけの実行を保証するものではありません。
公開資料にも境界があります。論文8.4節によれば、新しい復旧研究のソースとデータは公開審査用にローカル保管され、公開識別子はまだ付いていません。参照されるOpenPortの公開リポジトリは既存の実行器で、今回の研究用データそのものではありません。AICompanyは一次論文の方法と数表、既存リポジトリの説明を確認しましたが、ベンチマークや生の実行記録の独立再現は行っていません。
論文を読む価値は、再試行を増やす技法より、証拠が足りない仕事を、完了と呼ばずに扱う設計にあります。自動化を進めるほど、止まった後に何を知っているのかが問われます。再開ボタンを賢くするには、その前に記録と照会の道を用意する必要があります。
出典:原論文と版情報、本文(3~8節、表3~8)、別系統の既存実行器OpenPort。