
1兆パラメータのモデルなのに、1トークンで動くのは約490億。その数字だけを見ると「意外と軽いのでは」と感じるかもしれません。しかし、動かす計算が少ないことと、保存しておく重みが少ないことは別です。
Mistral AIは10月29日、Mistral Large 4、通称Le Chonkの改良版の重みを公開しました。月初の公開プレビューから追加の強化学習を進めたモデルです。今回の価値は、コードを書く能力の更新に加え、そのモデルを自分の管理下で評価し、配置できる選択肢が増えたことにあります。

今回公開されたものは何か
Mistralの公式発表によると、今回の対象は公開プレビュー後に改良されたMistral Large 4です。テキストと画像を入力し、テキストを出力するモデルで、コード生成やツールを使う作業にも対応します。推論の考える量にはlow、medium、highの3段階があり、highが既定です。
ここで区別したいのが、APIを通じて使えることと、重みを入手できることです。重みがあれば、自組織の環境に配置する、独自の評価を行う、必要に応じて追加学習する、といった選択ができます。ただし、ダウンロードしただけで実務に適した運用が完成するわけではありません。
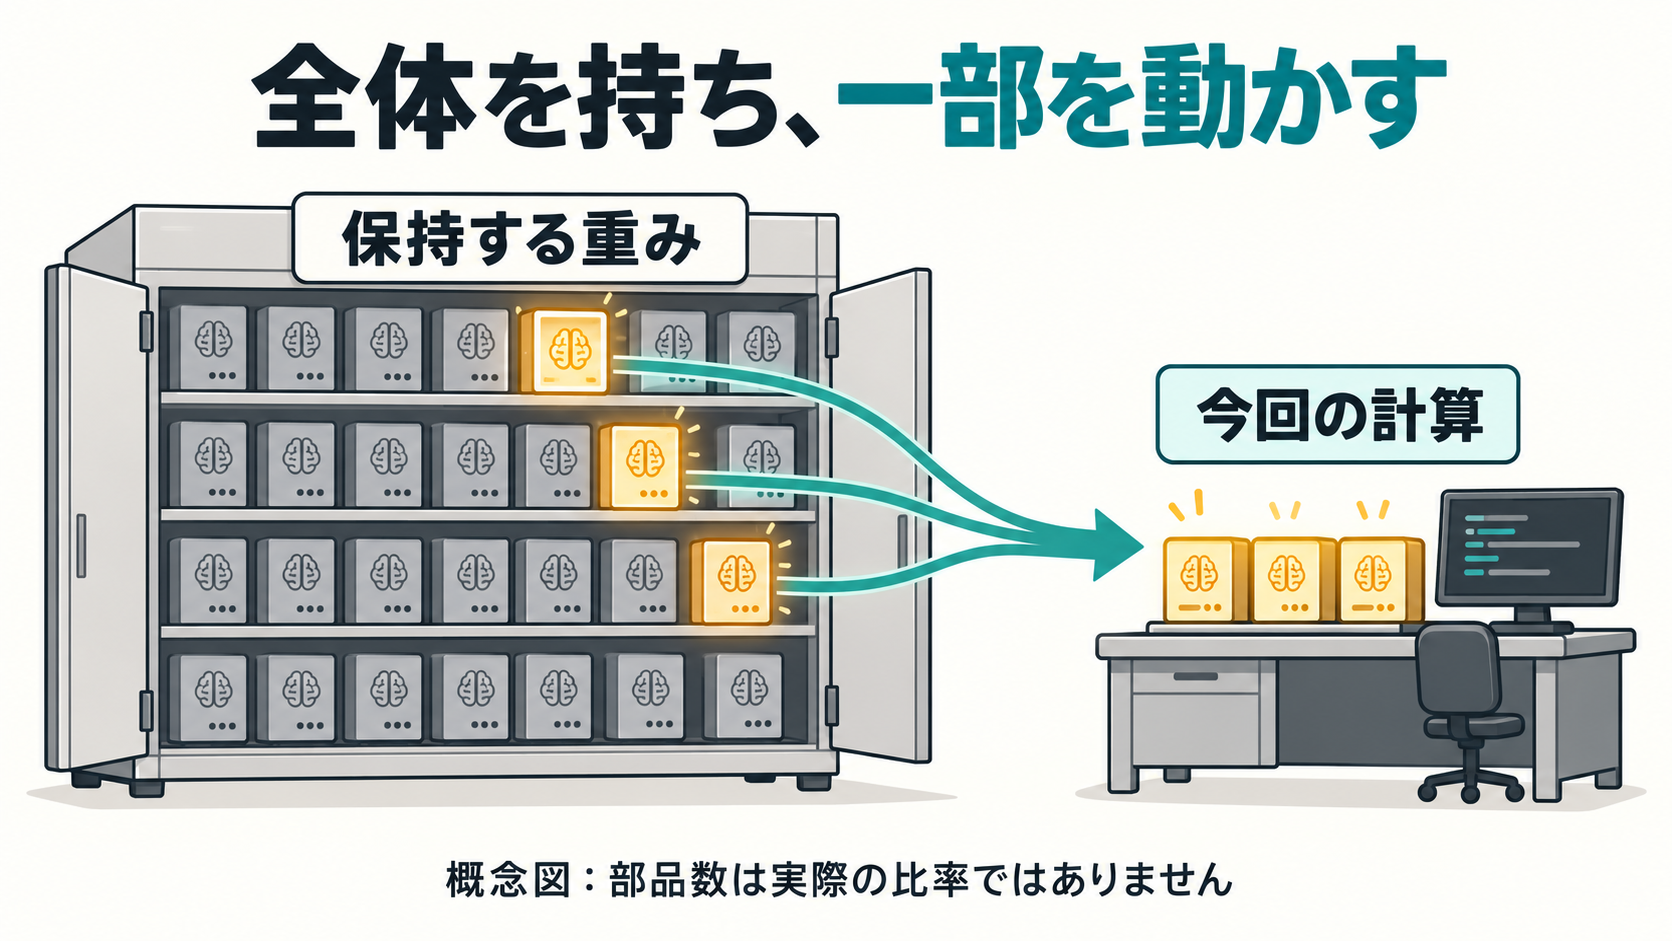
490億が動いても、1兆の重みは消えない
公式モデルカードでは、総パラメータ数は約1兆、トークンごとの有効パラメータ数は約490億とされています。埋め込み層と出力層を含めると約520億となり、モデル名のA52Bにつながります。数字の食い違いというより、数える範囲の違いです。
仕組みの中心はMixture-of-Experts、MoEです。多くの専門部品を用意し、各トークンではその一部を選んで処理します。モデルカードは128個の選択対象から4個を使い、別に共有の専門部品を1個使う構成を記載しています。毎回すべての専門部品で計算する必要を減らせる一方、選ばれなかった部品の重みもモデルの一部として保持する必要があります。
Hugging Faceの実装解説は、もう一つの選別として疎なattentionを説明しています。MoEは「どの専門部品で計算するか」、疎なattentionは「過去のどの位置を見るか」を選びます。二つを混同すると、計算量、長い文脈の扱い、必要メモリの話が一緒になってしまいます。
最大100万トークンの文脈に対応するという仕様も、すべての長さで同じ正確さや速度が出る保証ではありません。重みに加え、文脈を保持するキャッシュや実行時の領域も必要です。有効パラメータ数だけから、手元のPCで快適に動くと判断することはできません。
発表された成績は、どの版の数字なのか
公式発表は、Artificial Analysis Coding Agent Indexで48%、比較対象のGLM-5.3に対しタスク当たりの平均トークン使用量が47%少ないと報告しています。またTerminal-Bench 4.0では、プレビューの28%から公開版の41%へ13ポイント改善し、出力トークンを30%減らしたとしています。
| 公式発表の比較 | 報告値 | 読み取れないこと |
|---|---|---|
| Coding Agent Index | 48% | 自社リポジトリの成功率 |
| GLM-5.3との平均トークン比較 | 47%少ない | システム全体の費用が47%下がること |
| Terminal-Bench 4.0 | 28%から41% | あらゆる開発作業で13ポイント改善すること |
これらは提供元が示した評価結果であり、AICompanyが独立に再実行した結果ではありません。Hugging Faceの実装解説には異なる評価値も掲載されていますが、評価時点や版、集計条件をそろえた照合ができないため、この記事では公式公開発表の数字と混ぜて順位を作りません。
トークン数が減っても、同じ割合で待ち時間や請求額が減るとは限りません。ハードウェア、並列数、入力の長さ、ツール待ち、再試行まで含めて初めて実際の負担が分かります。さらに、公式発表時点で完全な技術報告書は今後公開予定です。訓練や評価の詳細には、まだ確認できない部分があります。
実務では、同じ小さな仕事で比べる
ここからはAICompanyの評価案です。既存コードの不具合修正なら、まず小さな課題を固定し、修正前に失敗する確認手順と、修正後に通る条件を用意します。モデル名だけを入れ替え、道具、権限、時間上限、入力資料をそろえて比較します。
例えば、期待どおりに直ったかに加え、無関係なファイルを変えていないか、何回やり直したか、人が確認する時間はどれくらいかを記録します。highで成功してもmediumで同じ結果が出るなら、そちらが運用に向く可能性があります。これは実験の設計案で、Large 4を実際に動かした報告ではありません。
課題と修正前の失敗を固定する
同じ入力・道具・上限で各設定を試す
修正後の確認と変更差分を読む
成功、再試行、時間、トークン、人の確認時間を記録する
失敗例を残して採用条件を決める
公開された重みは、このような評価を自分の管理下で行う余地を広げます。一方、コードの修正や外部への操作を伴うエージェントでは、モデルの評価と、実行権限や承認の設計を別々に確認する必要があります。高い評価値は、操作を無条件で任せる根拠にはなりません。
重み公開と利用条件は、両方読む
ライセンスは通常のMITそのものではなく、Mistral Ecosystem Open-Weight Licenseです。ライセンス本文には、Model-as-a-Service事業者の商用利用に別契約を求める条件があり、内部利用などの例外も定義されています。自分のサービスがどの範囲に当たるかは、本文の定義を含めて確認する必要があります。
今回の公開は、強力なモデルを自分で扱うための選択肢を増やしました。その価値を引き出す近道は、ランキングを眺めることより、手元の一つの課題を固定して測ることです。1兆という大きな数字の前でも、最初の評価は小さく始められます。