
同じ調査を三人に頼んだのに、三人とも同じ袋小路に入る。AIエージェントを並列に動かすときも、似た無駄は起きます。一方、発見をすべて共有すると、読む量が増え、全員が同じ方向へ引っ張られるかもしれません。
そこで考えたいのが、情報を配るタイミングです。発見した側が先回りして要約を送るだけでなく、困った側が「いま必要なこと」を質問する。論文「Ask on Demand」は、この相談の出し方と、相談してよいかを判断する小さなモデルを組み合わせます。面白いのは、相談を増やすこと自体を目標にしていない点です。

共有する内容を、未来のために決めすぎない
たとえば商品調査を分担する場面で、ある担当が返品条件を見つけたとします。その時点では重要でなくても、別の担当が候補を絞る段階では決め手になるかもしれません。先に作った短い要約からその条件が抜けると、あとから必要になっても拾えません。
Ask on Demand(AOD)は、情報を必要とする側の判断に合わせて、他のエージェントの作業記録を探します。ただし、論文の設定では同じ課題を別々の環境で解く並列チームです。一つの共有画面を全員で操作する仕組みとして検証した研究ではありません。
質問は「不足情報・既知の事実・次の判断」の三点セット
質問するエージェントは、何が足りないか、何をすでに把握しているか、回答によって次の行動をどう決めるかを書きます。単に「何かわかった?」と聞くより、相手の記録を絞りやすい形です。
質問が出ると、まず承認か却下かを判断するゲートを通ります。通過した質問について、BM25という語の一致を使う検索で仲間の記録を調べ、関連する記録を持つ一人を選びます。回答には根拠の引用を付け、記録だけで答えられない場合は不足を示します。
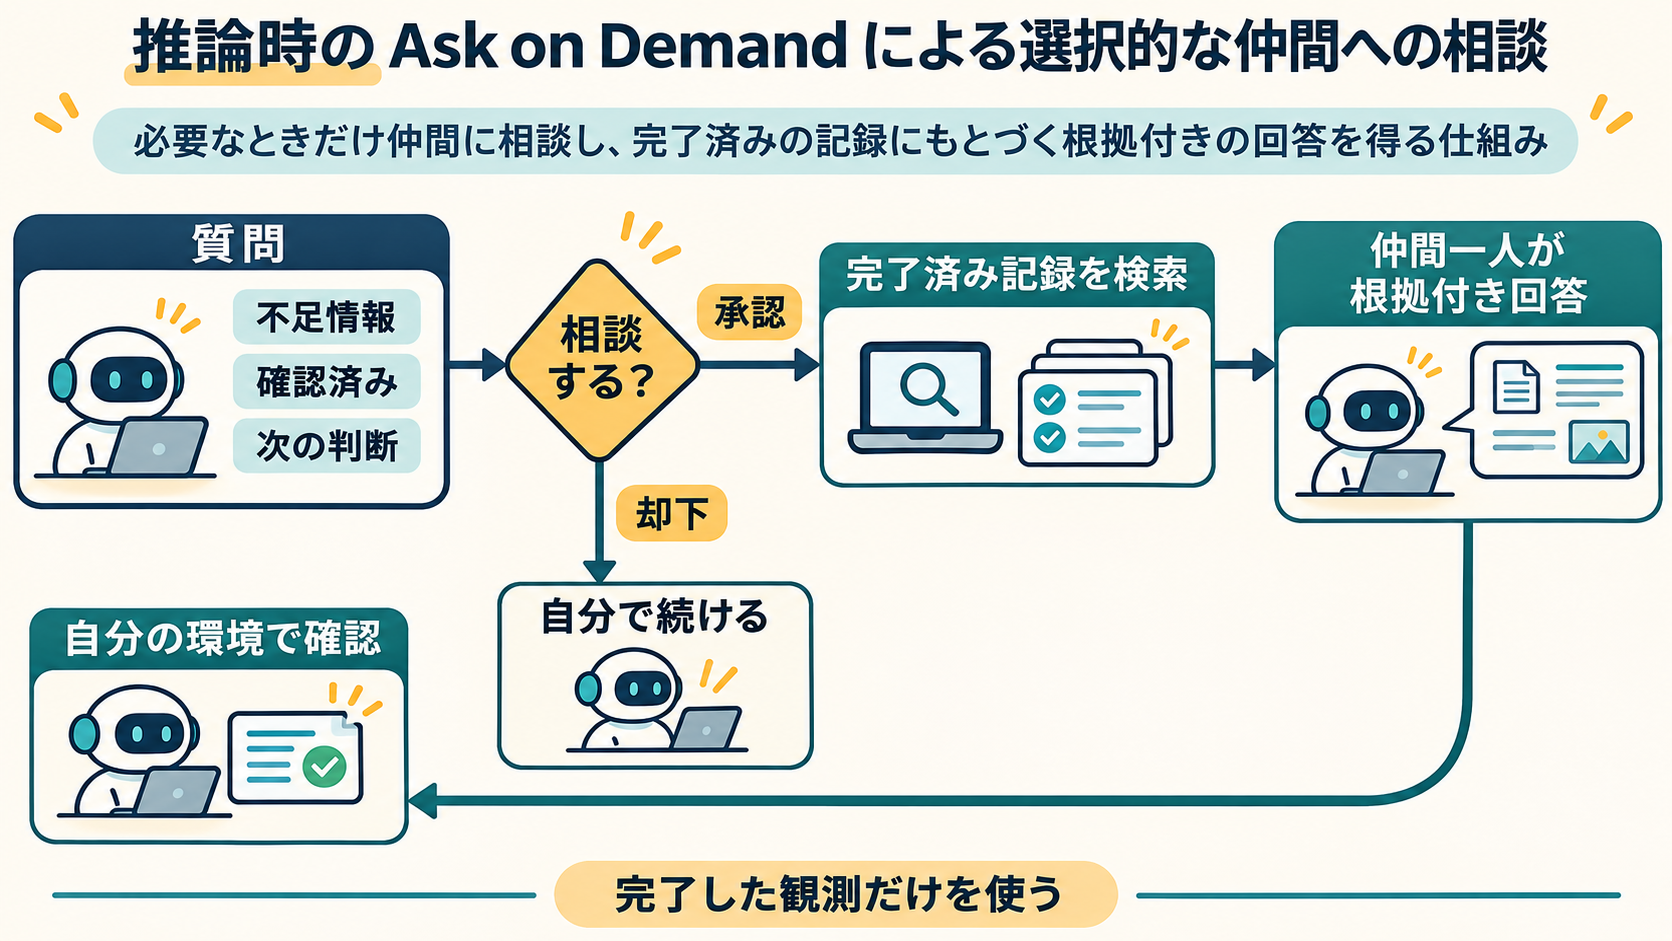
ここで見られるのは、その時点で完了した記録だけです。実行中の操作や未来の観測は含めず、仲間から受け取った回答も検索対象の記録から除きます。回答のために新しい環境操作を始めることもありません。これは「相談すると、別の誰かが勝手に追加作業を始める」仕組みではなく、すでに得た観測を使う相談です。
相談の価値を、相談後の結果から学ぶ
ゲートはQwen3-0.6Bを学習したものです。質問を作るモデルと回答するモデルは固定し、相談を実行するかだけを学習します。
学習では同じチーム状態から、同じ質問を承認した場合と却下した場合へ分岐し、その後のチーム全体の結果を比べます。課題の成績が上がるなら、トークンが増えても承認の教師ラベルになります。成績が同じ場合は、残りの推論トークンが減る相談を承認します。つまり、最初から費用の最小化だけを追う設計ではありません。
この分岐比較は学習時の処理です。実行時に毎回二つの未来を最後まで試すわけではなく、質問と質問者の手元の文脈から判断します。学習用の分岐生成には別の計算が必要なので、実行時のトークン比較だけで導入全体の安さは決まりません。
成績は改善。ただし、トークンは増える条件もある
著者らは、アプリをまたいだ操作課題のAppWorldから120課題、商品探索のWebShopから200課題を使い、主に三体のエージェントで評価しています。課題用モデルはQwen3.5-35B-A3BとQwen3.5-4B、生成シードは三つです。以下は35Bモデルの著者報告値を抜粋したもので、当サイトによる追試結果ではありません。
| 条件 | 独立実行 | AOD |
|---|---|---|
| AppWorldのTGC | 53.89 | 62.78 |
| WebShopの成功率(%) | 42.50 | 45.50 |
| AppWorldの全体トークン比 | 1.00 | 1.09 |
| WebShopの全体トークン比 | 1.00 | 0.92 |
TGCは論文のTask Goal Completion指標です。成績は表1、トークン比は表2に基づきます。AppWorldではTGCが8.89ポイント上がる一方、全体トークンは約9%増えます。WebShopでは成功率が3.00ポイント上がり、全体トークンは約8%減ります。「相談すれば必ず節約になる」という読み方はできません。
トークン数にはチーム全体の入出力と補助モデル呼び出しを含みますが、モデル以外の保存・検索処理は含みません。入力と出力の単価やモデル単価を反映した請求金額でも、待ち時間の実測でもありません。
また、すべての比較相手に勝つわけでもありません。4BモデルのAppWorldでは、最終的に選んだ回答のTGCはAODの31.11より、適応版LTSの31.39が高い値です。成績を知ってから三候補の最良を選ぶOracle評価と、自己申告の確信度で一つを選ぶ評価も区別が必要です。良い候補を作る力と、それを選び取る力には差があります。
自分の作業に移すなら、まず質問の形を変える
ここからはAICompanyの応用案です。記事制作なら、「出典を調べて」よりも、「発表日が不明。リポジトリ作成日は確認済み。期間内の新規発表かを決めたい」と聞く方が、相手の調査記録から必要な根拠を探しやすくなります。
次の例は、この質問形式を確認するための小さな架空例です。学習済みゲートでも、AODの性能再現でもありません。
request = {
    "need": "公式発表の日時と根拠の場所",
    "known": "リポジトリの作成日は確認した",
    "decision": "今回の調査期間に含めるか判断する"
}
assert all(request[k].strip() for k in ("need", "known", "decision"))
運用では、この質問を他の担当の完了済み記録へ向け、回答にURLだけでなく確認した箇所も添えてもらう。記録が足りなければ「未確認」で返す。さらに、回答を採用して重複調査が減ったか、かえって読む量が増えたかを記録すれば、自分たちの作業で相談が役立つ条件を探せます。ただし、これは設計案であり、論文と同じ改善幅を約束するものではありません。
相談の上手さを、通信量だけで評価しない
比較には注意点もあります。適応版の手法には固定したコントローラーを使う一方、AODではゲートを学習しています。また、適応版Agentfugueは完了部分の文脈を圧縮するため、文脈管理の条件がそろっていません。トークン差をすべて通信方式だけの効果とみなすのは早計です。
今回確認した範囲は論文の本文、手法、表と考察です。補足資料の課題分割や生ログの照合、独立したベンチマーク実行はしていません。三つのシードの平均値から、実業務での改善の確実性まで広げることもできません。
それでも、実務で試す価値がある着眼点は明確です。共有メモを増やす前に、誰が何を知りたくて、その答えで何を決めるのかをはっきりさせる。エージェントの人数を増やすだけでなく、相談の入口を整える。会議を増やすより、質問を一つ具体的にする方が効く場面は、人間の仕事にもありそうです。
出典:Ask on Demand: Targeted Peer Communication for Parallel Agentic Systems(Haofu Yangほか、arXiv:2610.41378v1)。本文の3節、4節、表1・表2・表4。図は仕組みを説明するためにAICompanyが独自に制作した概念図です。