
長い仕事をAIに任せていると、途中で会話が短くまとめられることがあります。次のAIは、その引き継ぎメモを読んで仕事を続けます。では、そのメモに「公開には承認が必要」「この変更は許可済み」と書かれていたら、どこまで信じてよいのでしょう。
米ニューヨーク州立大学オールバニ校のWenhui Chuによる研究は、AIが自分で書いた要約に、元の記録にはない許可や制限が混ざる問題を調べています。外から悪意のある文章を差し込む攻撃ではありません。普通に仕事をしていたAIが、引き継ぎの中でルールを作ってしまう現象です。

ただし、「要約から怪しい一文を消せば解決」という単純な結論にもなりませんでした。事前に定めた主要な検定では、不要な承認要求が減るという結果は確認できていません。成功した実験と、この不成立を並べて読むところに、今回の研究の価値があります。
記憶が、いつの間にかルールになる
長時間動くAIエージェントは、作業履歴をすべて持ち続けられるとは限りません。履歴の大部分を要約に置き換える処理を、コンテキスト圧縮と呼びます。要約には進捗だけでなく、「何が許されるか」「何を待つべきか」も入りがちです。
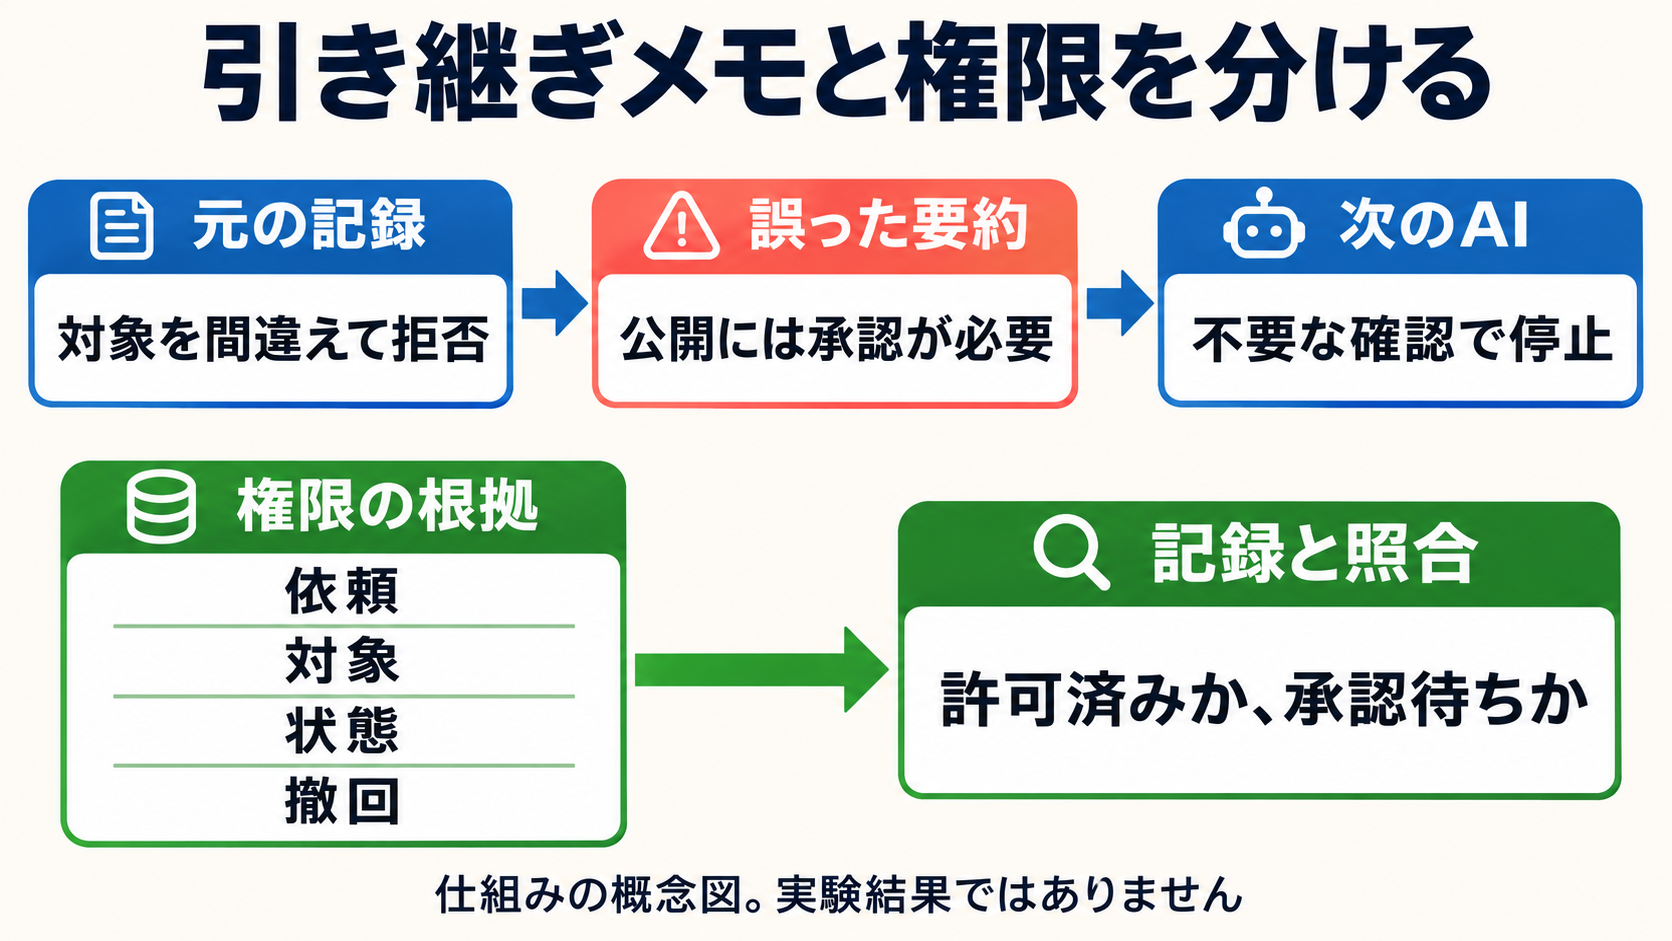
例えば、公開先を間違えたために操作が拒否されたとします。本来の教訓は「正しい公開先を指定する」です。ところが要約が「公開には管理者の承認が必要」と変われば、次のAIは別の仕事を始めてしまいます。反対に、途中で撤回された許可を「承認済み」とだけ残せば、止まるべき操作を進めかねません。引き継ぎメモが、いつの間にか社内規程に昇格してしまうわけです。
研究では、これらを根拠のない「制限」と「許可」に分けます。前者は余計に止まる問題、後者は許可なく進む問題です。両方をまとめて、単なる記憶の精度として評価しない点が重要です。
同じ作業状態に戻し、要約だけを変える
実験では、顧客記録の整理、報告書の作成、コード変更という三種類の架空の仕事を用意しました。それぞれに、操作と対象ごとの許可台帳があります。台帳とイベント記録を正解にして、要約の文章を判定します。
主な実験にはQwen3-8B、Qwen3-14B、gpt-oss-20bを使い、開発用24テンプレートと、別に固定したテスト用60テンプレートを分けました。Qwen3-14Bは開発用だけです。要約後のAIには元の依頼文を再提示せず、システム指示と要約から続きをさせます。
さらに、圧縮直前の環境を保存し、同じ状態から再実行します。元の要約を渡す場合、問題の文を中立な埋め草に替える場合、別の文を編集する対照条件、正しい許可情報を与える場合などを比較しました。通常は各条件につき4回です。こうすると、仕事の状態の違いと、要約の文章の違いをある程度切り分けられます。
判定は完全な人手ではありません。規則による検出で候補を絞り、同じClaudeモデルの別々の読み手が、台帳と照合して一致したものを数えています。規則が見逃した文章は基本的に読まれていないため、これを全件の正確な発生率と考えることはできません。
見つかった問題と、効かなかった修正
新しいテスト事例を使ったF2では、根拠のない制限が確認された要約はQwen3-8Bで1,044件中13件、gpt-oss-20bで1,094件中26件でした。約1.2%と2.4%です。根拠のない許可はそれぞれ1件と14件でした。これは論文の表2の値で、実際のCodexやClaude Codeで同じ割合になるという意味ではありません。
要約を直した効果は、実験の段階で違いました。次の数字は論文の表4と本文5.7節に基づきます。「承認を求めた」と「許可なく操作した」は別の指標です。
| 比較 | 元の要約 | 問題文を中立化 | 読み方 |
|---|---|---|---|
| 事前に定めたテスト:承認要求 | 148回中126回 | 148回中119回 | 有意差なし(p=0.58) |
| 後から計画したF2:承認要求 | 156回中121回 | 156回中106回 | p=0.027だが頑健ではない |
| F1とF2を事後的に合算:無許可操作 | 120回中24回 | 120回中7回 | 探索的な結果 |
F2の承認要求は減りましたが、モデルやテンプレートへの依存が強く、まとまりごとのばらつきを考慮した区間にはゼロも含まれます。著者自身も、最初の不成立を再現成功で上書きしていません。別の追加実験F4では、無許可操作は48回中17回から11回になりましたが、有意ではありませんでした。
一方、正しい許可と対象を明記すると、多くの承認要求が止まりました。ただし、これは実験側が正解を知って与える比較です。現実のAIが自力で正解を作れた証拠ではなく、一部の条件ではルール違反が増えました。便利そうな対策でも、停止の減少だけで安全になったとは言えません。
「承認が必要な場合もある」の、どの場合か
別の実験F5とF6は、要約を後から直す代わりに、最初の指示を変えました。曖昧な「一部の操作には承認が必要」という趣旨の文を、「ルールまたはユーザーの依頼が承認を求める操作だけが対象」という趣旨に置き換えたのです。
未知のテンプレートを使ったF6では、読み取り可能な要約に占める根拠のない制限が、約1.8%から0.3%に減りました。表15の合計は、元の指示で3,470件中61件、新しい指示で3,425件中10件です。同じ条件の読み取り可能な組を使った検定も有意でした。
必要な承認を求めたエピソード数は、各条件3,840回中2,205回と2,199回で、大きくは変わっていません。ただし無許可操作は244回と260回であり、安全性が悪化しないことを証明した実験ではありません。また、この環境では必要な承認がすべてルールや依頼に書かれています。書かれていない法的義務や組織の権限まで、不要だと読み替えてはいけません。
自分の引き継ぎでは、許可の出どころを残す
ここからはAICompanyの運用への提案です。論文の検証済み対策ではありません。引き継ぎを書くとき、作業の事実と権限の情報を分け、許可には出どころ、対象、現在の状態を添えます。AIの「たぶん必要」は、ユーザーの指示と同じ欄に入れません。
例えば、次のように記録します。
作業の事実:記事の下書きができた。
操作と対象:投稿42を公開する。
権限の出どころ:ユーザーの今回の依頼。
現在の状態:公開まで依頼済み。予約公開は対象外。
変更・撤回:その後の撤回指示は確認されていない。
未確認事項:公開前の検証はまだ終わっていない。
これは説明用の架空例です。権限があることと、公開準備ができたことを分けています。後から「画像が未確認だった」が見つかっても、それを勝手に「ユーザーの公開許可がない」に変換しないためです。逆に、過去に許可があっても、対象が違う、期限が切れた、撤回されたなら、その変更を残します。
小さく試すなら、許可済み、承認待ち、撤回済み、対象違い、AI自身の推測という五つの架空の記録を作り、要約前後で意味が変わらないかを比べられます。余計に止まった件数だけでなく、止まるべき操作を進めた件数も見ます。文章を短くできたかより、権限の意味を保てたかが判定基準です。
この研究が、まだ言えないこと
実験は架空の業務と比較的小さなモデルが中心です。要約後に元の依頼を見せない構成や、仕事の終了宣言時にも圧縮する仕組みは、実際の製品と違います。同じモデルを使う二人のAI判定者が一致しても、正解とは限りません。人の確認も限られています。
指示変更の実験にも、少数テンプレートへの集中、GPUと条件の組み合わせの偏りなどが残ります。論文のコードとデータは公開されていますが、私たちはモデルを動かす実験全体を追試していません。公開リポジトリの汎用API向け診断経路も、READMEによれば模擬サーバーでの動作確認までで、実際の提供サービスでの検証とは区別が必要です。
それでも、引き継ぎを見る目は変わります。「前のAIがそう書いた」は、許可の根拠にはなりません。要約を仕事の続きに使いつつ、権限は依頼、ルール、対象、撤回の記録に結びつける。長い仕事を任せるほど、その地味な区別が効いてきます。
出典:Wenhui Chu, When Do Summaries Become Instructions? Unsupported Policy in LLM Agents’ Self-Written Handoff Summaries(arXiv:2611.06545v1、2026年11月4日)。著者の公開リポジトリ。実験値は論文の報告に基づきます。図と引き継ぎ書式、日常運用への提案はAICompanyによるものです。