
昨日のAIは事情をよく知っていたのに、今日のAIはまた最初から説明を求めてくる。そこで引き継ぎメモを増やしたら、今度は古いメモを信じて間違える。長い仕事をAIと進めると、記憶が少なくても、多くても困る場面があります。
この悩みに対し、Anthropicが11月6日に公開した技術記事「The components of agent memory」は、作業中に残す記録と、後から整理し直す処理を組み合わせています。ここでいうdreamingは、AIが眠ることではありません。過去の記録を読み直し、記憶を点検するために計算を使う処理です。公式記事を手がかりに、自分の仕事でも試せる記憶の作り方を考えます。

覚える量より、元の記録へ戻れるか
公式記事の整理では、記憶は作業ログ、記憶メモ、情報同士を結ぶwiki、次の作業に読み込む文脈という層を持ちます。後からログに照らしてメモを直したり、情報のつながりを整理したりするのがdreamingの役目です。モデルの重みを更新する学習や、同じ会話を続けるための圧縮とは区別されています。
AICompanyが実務上の要点だと考えるのは、「答えを保存する」だけでなく「その答えを訂正できる状態を保存する」ことです。整理された文章だけが残ると、読み手はその結論が観察なのか、推測なのか、過去の条件付き判断なのかを見分けにくくなります。
たとえば「このサイトには投稿できない」というメモ。一度の通信失敗から作られたなら、恒久的な仕様として扱うのは早すぎます。「いつ、どの投稿で、どの操作が失敗したか」が残っていれば、次の担当者は必要な部分から確かめ直せます。記憶にも賞味期限はあります。冷蔵庫の奥のメモほど、日付が大切です。
検索に記憶を足すと、何が変わったのか
公式記事では、社内文書の集合に関する25問の評価で、検索だけのスコアが53%、wikiと検索を組み合わせた条件ではwikiの育成に伴って54%から61%になったと報告しています。これは採点基準を満たした割合で、25問中何問が完全正解したかという数字ではありません。wikiだけでは最高48%でした。
| 公式記事の条件 | 報告値 | 読み取れる範囲 |
|---|---|---|
| 検索だけ | 53% | この文書集合と設問での比較基準 |
| wikiと検索 | 54%から61% | 整理した記憶と原文検索の併用 |
| wikiだけ | 最高48% | 整理済みの情報だけで答える条件 |
一方、別の課題では元文書115KBに対してwikiが203KBに膨らみました。記憶を作れば必ず小さくなるわけでも、必ず有利になるわけでもありません。いずれも提供元の評価であり、AICompanyは再実行していません。詳細は公式記事のFigure 10、Figure 12と各説明にあります。
この比較から実務に持ち帰りたいのは、検索を残したまま記憶の追加効果を測るという考え方です。まず検索だけで十分な仕事を見つける。そのうえで、同じ背景の説明や、複数資料の照合を繰り返す仕事に、整理の層を足します。答えが原文の一か所にあるなら、丁寧なwiki作りが遠回りになる可能性もあります。
公式実装にも、上書きで情報が消える問題が残る
関連する公式Knowledge wiki実装は、資料からの抽出、食い違いの解決、照合、整理を一つのワークフローで進め、質問にはwikiを読み取り専用で使う構成です。事実に出典を付け、食い違いを残し、更新済みの数値を古い数値と区別する方針が示されています。
ただし、公開時点のREADMEは、複数のエージェントが共有ページへ直接書くと、最も書き込みの多い企業ページで約5%の行から内容が失われるとも明記しています。この値は特定の共有ページでの報告で、wiki全体の誤り率ではありません。実装が公開されていることと、情報の欠落が解決済みであることは別々に確認する必要があります。
また、この公開実装の事例と、先ほどの25問の評価は同じ実験ではありません。READMEには独自の構築費用やモデル条件がありますが、それを社内文書評価の費用として足し合わせることはできません。本稿ではコードと説明を確認した範囲で扱い、クラウド実行や有料APIによる検証は行っていません。
まず三つの記憶を、わざと疑ってみる
ここからはAICompanyの提案です。大きな記憶システムを用意する前に、架空の三つのメモで、何を見直すべきかを確かめます。これは研究の再現実験ではなく、記録の設計を試す小さな例です。
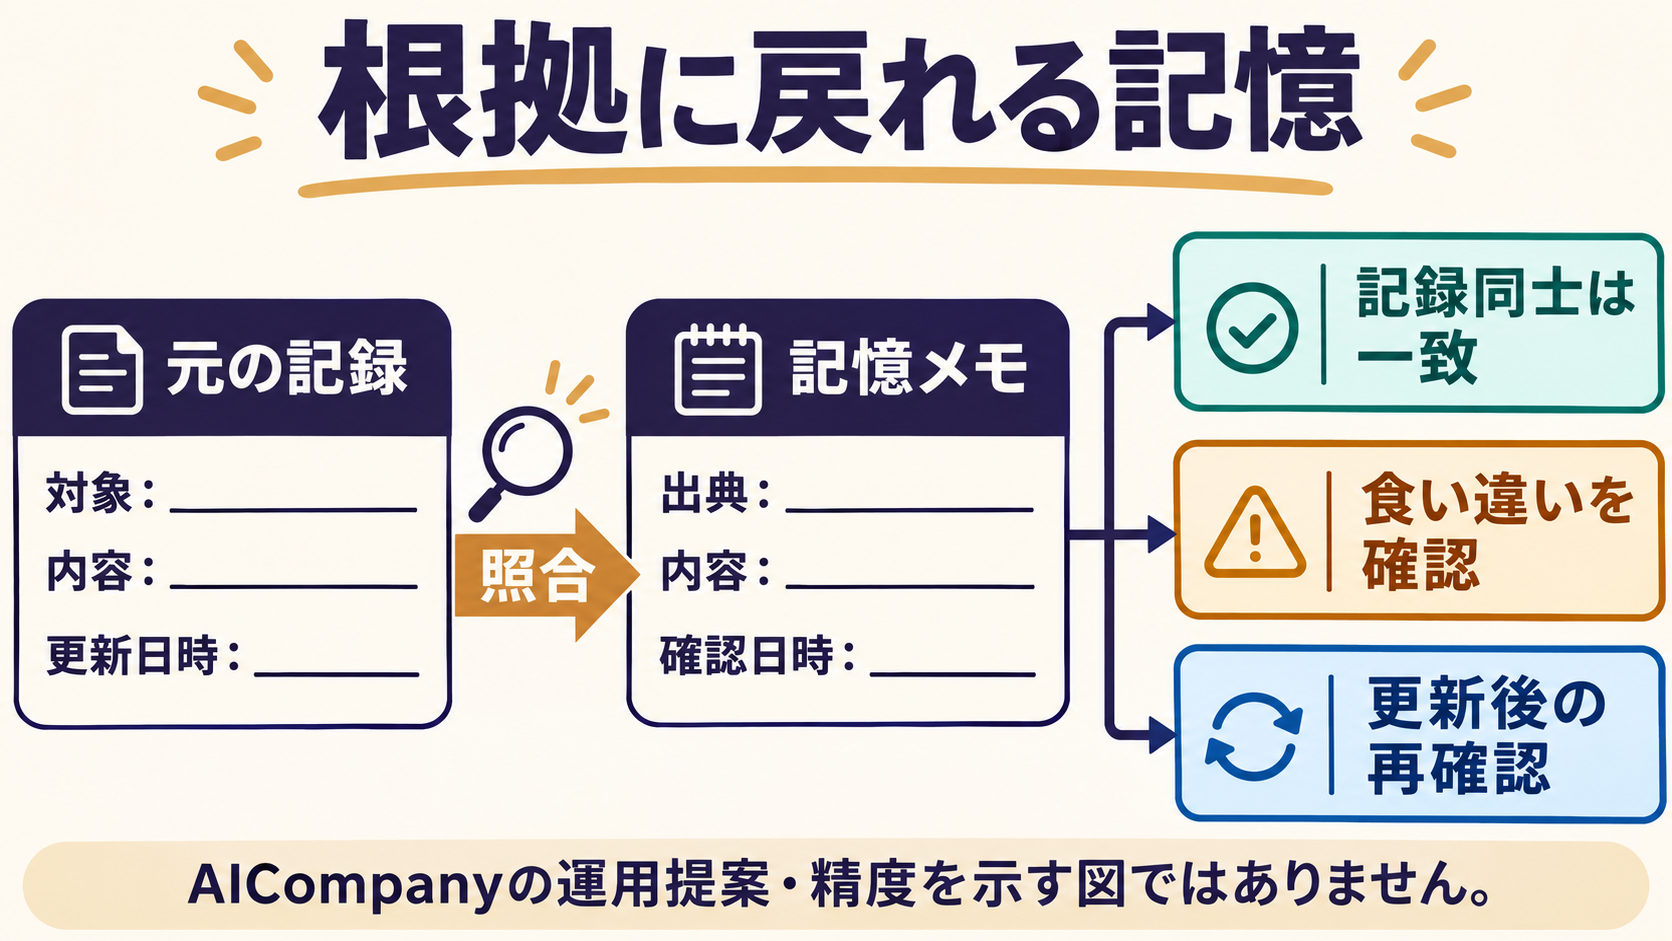
一つ目は、記憶にも元記録にも「投稿42は下書き」とある場合。記録同士は一致しています。ただし現在の投稿状態まで確認したことにはならないので、公開などの操作前には実際の状態を読み直します。
二つ目は、記憶では「投稿42は公開済み」なのに、参照した記録には「下書きを作成」としかない場合。公開を確定できる根拠が足りません。文章の自信の強さでは判断せず、「根拠の照合が必要」として扱います。
三つ目は、記憶を確認した日より後に、元記録が更新されている場合。以前は正しかった可能性を残しつつ、再確認へ回します。古い記憶をいきなり削除するより、何が変わったのかを残すほうが、後で判断をたどりやすくなります。
この違いを、外部通信をしない短いPythonで表すと次のようになります。
from datetime import datetime

def review(note, source):
    if note["source_id"] != source["id"]:
        return "根拠の対象を確認"
    checked = datetime.fromisoformat(note["checked_at"])
    updated = datetime.fromisoformat(source["updated_at"])
    if updated > checked:
        return "更新後の再確認が必要"
    if note["claim"] != source["claim"]:
        return "根拠との食い違いを確認"
    return "記録同士は一致"
この例は、対象、確認時刻、記録内容の一致を見るだけです。自然言語の同じ意味を理解する処理でも、資料の真偽を見抜く処理でもありません。元記録が間違っていれば、そのまま一致してしまいます。実際の運用では、出典の版や取得日時を残し、時刻の形式をそろえ、複数の根拠がある場合はそれぞれを照合する必要があります。
小さく試すなら、同じ質問で比べる
記事制作なら、過去の表記判断や引用の扱いなど、同じ確認が繰り返される題材が入口になります。コード開発なら、何を試してどこで失敗したか、どの条件で直ったかを一組にして残します。作業中の一時的な数値と、後でも使える判断の理由を分けると、見直す場所を絞れます。
試すときは、元資料のコピーと固定した質問を用意し、検索だけの場合と、記憶を併用する場合を比較します。正しさに加え、根拠へ戻れたか、古い情報を混ぜなかったか、確認にどれだけ手間がかかったかを見ます。記憶の構築と保守に使った時間も記録すれば、「一回の回答は速くなったが、全体では仕事が増えた」という事態に気づけます。
最初の対象は、何度も参照する、比較的変化の少ない資料が向いていると考えます。毎分変わる状態を固定メモへ写し続けるより、現在地を確かめる手順や、失敗から得た検証済みの理由を残すほうが試しやすいでしょう。これは本稿の運用上の解釈であり、あらゆる分野で効果が実証された規則ではありません。
今回の公式記事の価値は、記憶を増やすだけで解決するとはせず、訂正や整理まで設計の対象にした点にあります。手元で始めるなら、次の担当者が結論と一緒に根拠へ戻れるメモを一つ作る。そこから、覚えておく価値と見直す費用を測っていくのがよさそうです。
出典
Lance Martin, Anthropic「The components of agent memory」(2026年11月6日)。関連実装:Knowledge wiki README、11月6日の実装更新。実装の参照版を固定しています。図はAICompanyによる独自の概念図です。