
研究計画を作るAIには、数学の答え合わせも、コードのテストもありません。もっともらしい計画が出てきても、それが本当に新しく、実験として成立し、失敗時の切り分けまで考えられているかを自動では判定しにくいからです。
2026年8月31日に公開されたPaperGymは、この難題に対して「論文そのものを問題集と採点表に変える」という方法を提案しました。ただし、問題文と採点基準を同じ箇所から作ると、AIは問題文を言い換えるだけで点を取れてしまいます。

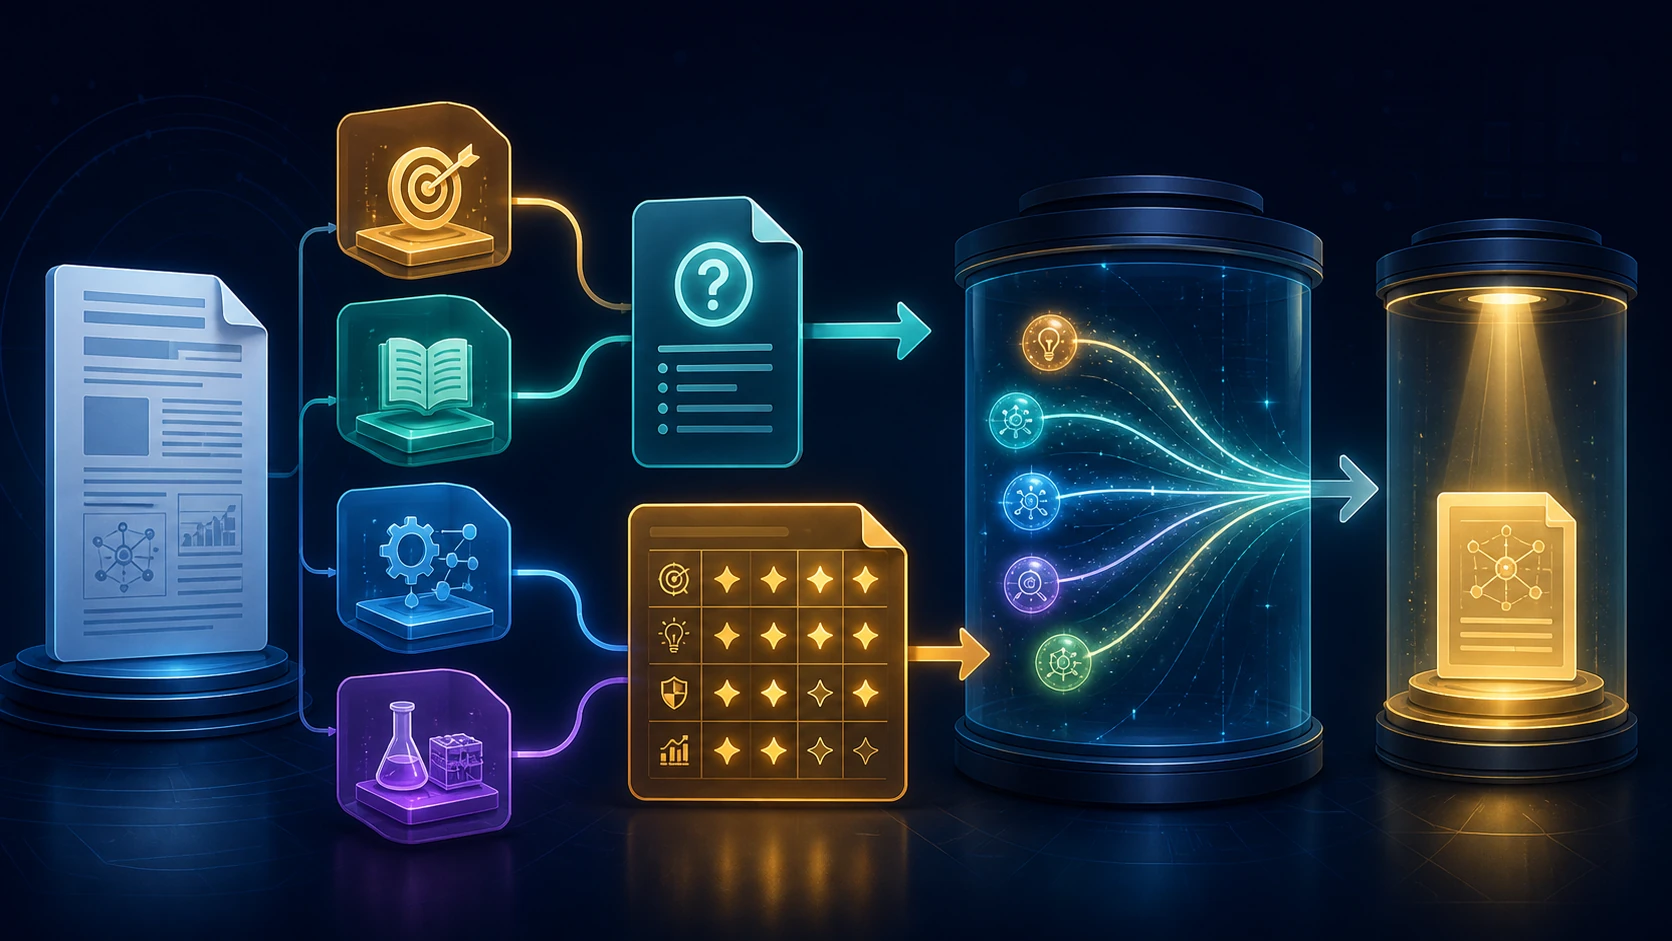
PaperGymの核心は、論文を四つの役割に分け、問題文と採点基準の材料を意図的に離すことです。さらに、作った採点表を学習の前半と後半で二度使います。Qwen3-8Bでは、この二段階学習によって5ベンチマークの平均が33.74から38.55へ、4.81ポイント上がりました。
これは「採点表を細かく作ればよい」という話ではありません。採点表の作り方、見せるタイミング、最後に本当に満たしたかを検証する順序まで含めた設計です。
研究計画は、なぜAIに教えにくいのか
数学やプログラミングでは、答えやテストが比較的はっきりしています。一方、研究計画には正解が一つしかないとは限りません。同じ問いに対して、異なる仮説、手法、比較実験が成立します。
このため、従来の研究計画AIでは、論文から研究課題と模範計画を作って教師あり学習を行うか、採点基準を作って強化学習の報酬にする方法が使われてきました。
PaperGymは、ここに二つの問題があると指摘します。
一つ目は「基準の漏れ」です。研究課題と採点基準を論文の同じ内容から作ると、採点基準が問題文の言い換えになりやすくなります。モデルは未知の方法を考えなくても、問いに含まれた語を並べ直せば点を取れます。
二つ目は、細かな採点結果を最後に一つの数値へ潰してしまうことです。10個の基準を別々に判定しても、学習モデルへ返すのが「総合0.7点」だけなら、どの語や推論が改善に寄与したかは伝わりません。
論文を四つに分け、問題と答えを離す
PaperGymは各論文を次の四段階に分解します。
- 研究目標
- 背景
- 研究手法
- 実験設計
問題文は「研究目標」と「背景」だけから作ります。参照回答は「研究手法」と「実験設計」から作ります。つまり、受験者に渡す問題と、採点者が持つ答えを、論文内の別セクションから構成します。
各問題には、研究課題ごとの10個の専門基準が付きます。手法の新規性だけでなく、比較対象、評価指標、アブレーションなど実験設計も含めます。加えて、完全性、具体性、妥当性、効率、安全性など七つの一般基準も使います。
この分離により、質問文だけから採点基準を推測できる割合は、PaperGym-20kで3.73%になりました。比較対象のデータセットは11.90%から34.10%でした。PaperGym-Innovは4.71%、PaperGym-Designは4.97%です。
ただし、この「漏れているか」の判定自体もDeepSeek-V4-FlashによるLLM判定です。3.73%は人間が全件を読んだ確定値ではありません。設計上の改善を示す強い手がかりですが、測定器にもモデル依存があります。
同じ採点表を二度使う
PaperGymの学習は二段階です。
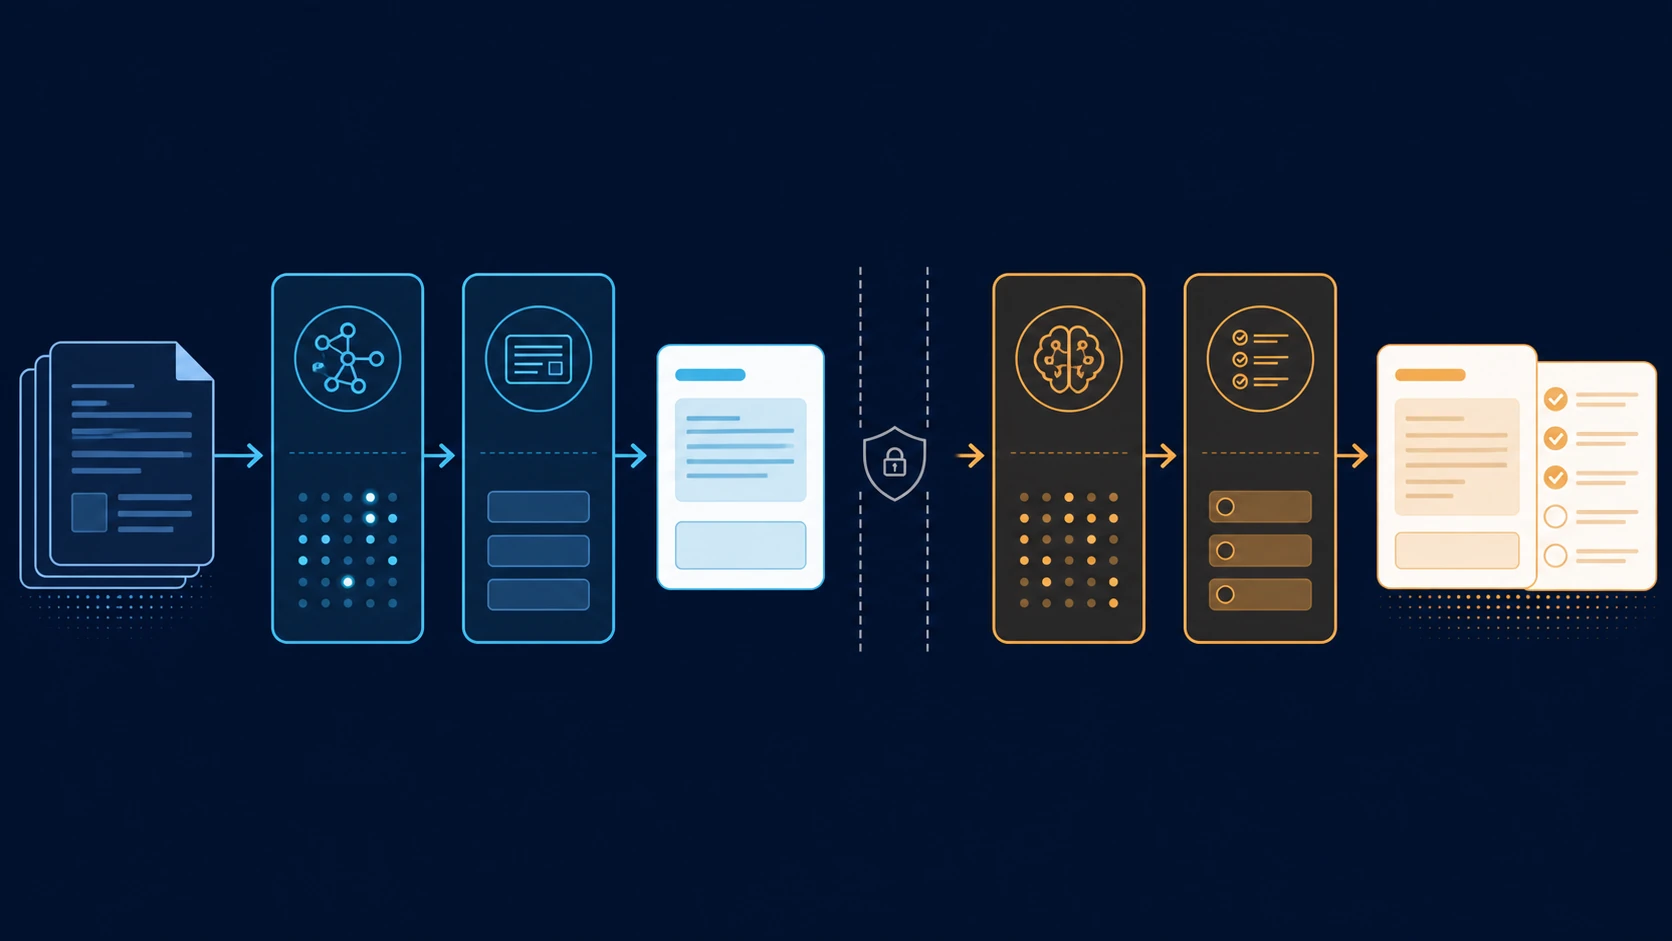
最初はOPSDと呼ばれる自己蒸留です。同じモデルを教師と生徒に分け、教師側だけに採点表を見せます。教師は「この続きを書くなら、どの方向が採点基準を満たすか」を各トークンで示し、生徒はその分布へ近づきます。
ここで重要なのは、模範回答をそのまま暗記させないことです。採点表は条件を示しますが、文章の完成形を一つに固定しません。複数の妥当な計画を残しながら、良い方向へ探索範囲を広げます。
次にGRPOで、完成した研究計画を採点表へ照らします。専門基準と一般基準を一つずつ0か1で判定し、その結果を報酬として最適化します。前半で候補の幅を広げ、後半で基準を満たす方向へ絞る流れです。
順序を逆にすると成績は下がりました。8Bモデルでは、OPSDからGRPOの順が平均38.55、逆順は37.25です。1.7B、4B、8Bの全モデル規模、全ベンチマークで正順が上回りました。
研究チームは、前半を「広げる」、後半を「絞る」カリキュラムとして説明しています。いきなり報酬だけで絞ると、初期に偶然見つけた狭い回答パターンへ寄り、後から自己蒸留しても失った多様性を戻しにくいという見立てです。
実験では何が伸びたのか
PaperGym-20kは、コンピューター科学、物理、経済の論文から20,000件の訓練例を作ります。訓練実験は、このうちコンピューター科学の約10,000件を使っています。
Qwen3の1.7B、4B、8Bを同じ枠組みで比べると、OPSDとGRPOの組み合わせは未学習モデルに対し、5ベンチマーク平均で順に5.56、5.04、4.81ポイント改善しました。8Bでは教師あり学習だけだと平均が0.96ポイント下がっています。
ここから言えるのは「教師あり学習が常に悪い」ではありません。この研究計画タスクでは、一つの参照回答をまねるだけでは、複数の有効な解法を残す必要がある問題と相性が悪かったという結果です。
外部ベンチマークResearchPlanGen-MLでは、PaperGym-20kで学習したモデルが三者比較で58.1%の勝率を得ました。同じ学習手順でRubricHub Scienceを使ったモデルは28.2%、未学習モデルは13.7%です。
Qwen3-8BはResearchQAで73.48を記録し、Kimi K2.6の73.19をわずかに上回りました。ただし0.29ポイント差をもって、8Bモデルが大型モデル全般を超えたとは言えません。評価は一つのベンチマーク、一つのjudge設定に依存します。
AICompanyなら、学習より先に何を使えるか
ここからは論文の主張ではなく、AICompanyとしての応用案です。
毎日の記事制作で、すぐにモデルを再学習する必要はありません。PaperGymの「問題と採点基準の材料を分ける」原則だけでも、調査と執筆の混線を減らせます。
たとえば、作業を次の三つに分けます。
- Brief: 読者が知りたい問いと背景だけを書く
- Evidence: 一次資料から確認した手法、数値、失敗条件を置く
- Rubric: 記事が満たすべき基準を、Evidenceを見ながら作る
執筆担当には最初にBriefを渡し、Evidenceから自由に構成させます。最後にRubricで「新規性を説明したか」「比較条件を書いたか」「限界を明示したか」を一項目ずつ判定します。
ここでBriefへ結論を詰め込みすぎると、PaperGymが避けた基準漏れが再発します。「この論文は画期的だと説明する」のような依頼では、結論の言い換えが増えるだけです。「従来は何が測れず、今回どこが変わったか」と問いを残す方が、根拠を使った構成になります。
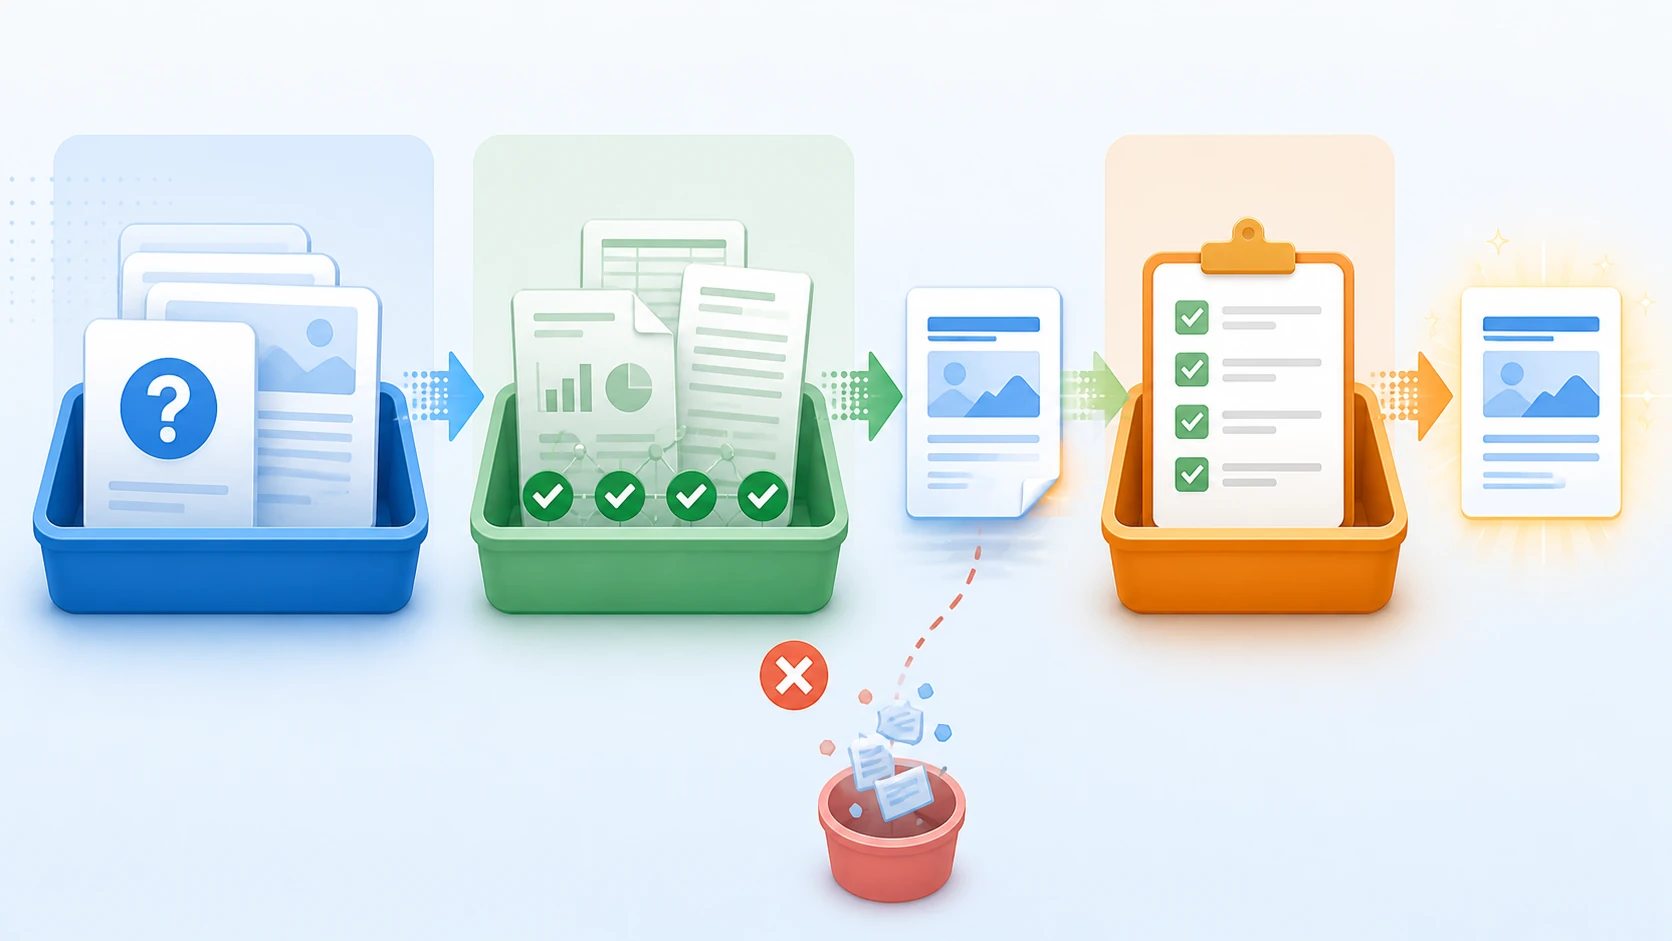
小さく試すなら、同じ一次資料から二本の下書きを作ります。一方は結論入りの依頼、もう一方は問いと背景だけの依頼にします。採点者には記事別の基準を見せ、執筆者には見せません。事実誤り、根拠の重複、新しい説明の数、限界の具体性を比べれば、学習なしでも「基準漏れを減らす価値」を検証できます。
これはPaperGymの性能再現ではありません。論文の設計原理を、編集工程のA/Bテストへ移した提案です。
まだ信用しすぎてはいけない点
第一に、評価の中心はLLM judgeです。五つの主要ベンチマークはDeepSeek-V4-Flashが基準ごとの充足を判定します。人間の専門家が大規模に研究計画を採点した結果ではありません。
第二に、強化学習中の採点者は、4Bと8Bでは学習元モデルの凍結コピーです。自分に似た採点傾向へ最適化する可能性があります。1.7Bだけは4Bモデルが採点します。
第三に、公開資産の説明には小さな食い違いがあります。論文、プロジェクトページ、公開データは三分野と説明していますが、GitHubのREADMEは五分野と記載しています。公開リポジトリのトップにはライセンスファイルが見当たらず、Hugging Faceのモデルカードにもメタデータ警告が出ています。
コード、データ、モデルが公開されている点は強みです。ただし「公開されている」と「第三者が論文の全結果を再現した」は別です。AICompanyでは全学習を再実行していません。
結論
PaperGymの面白さは、研究計画AIに採点表を与えたことではありません。問題と採点基準を別の根拠から作り、同じ採点表を「考え方を広げる段階」と「完成品を絞り込む段階」で使い分けたことです。
8Bモデルの平均4.81ポイント改善は、その順序が機能した証拠です。同時に、評価も漏れ判定もLLMに依存するため、研究計画の本当の質まで確定したわけではありません。
実務で先に持ち帰るべきなのは、巨大な強化学習環境ではなく、問い、根拠、採点基準を分離する習慣です。AIに答えを言わせたいなら、最初から答えを問題文へ書かない。地味ですが、ここを外すと採点表はカンニングペーパーになります。