
AIに「このアプリを完成させて」と頼み、長く動かせば、そのぶん良いものができるのでしょうか。
答えは、単純ではありません。作業時間を延ばすだけでは、同じ修正を繰り返したり、直した機能を別の変更で壊したり、目の前のエラー対応だけで一日が終わったりします。人間の開発現場でも見覚えのある光景です。AIになっても、堂々巡りはしっかり堂々と巡ります。

2026年9月1日に公開されたHarness-of-Harnessは、この問題をモデルの賢さではなく、仕事の受け渡し方から解こうとした研究です。計画、実装、独立テストを一つのループにし、毎回の成果物と検証証拠を次の周回へ残します。
CodexとGPT-5.5を使ったGameCraft-Benchでは、通常の一回実行が49.58点だったのに対し、3回のHoHループは71.52点でした。単に3回続けて開発させた場合は58.24点です。反復回数だけでなく、次の一手を決める証拠の質が効いた結果です。
長い一回より、検証できる短い周回
一般的なコーディングエージェントは、要求を受け取り、コードを読み、変更し、テストします。小さな修正なら、この一続きの流れで十分です。
ところが、ゼロから製品を作る仕事では事情が変わります。認証、画面、データ保存、エラー処理などが互いに影響し、途中で得た発見によって優先順位も変わります。長い会話へ全部を詰め込むと、過去の設計判断が埋もれます。逆に毎回まっさらから始めると、同じ調査と実装を何度もやり直します。
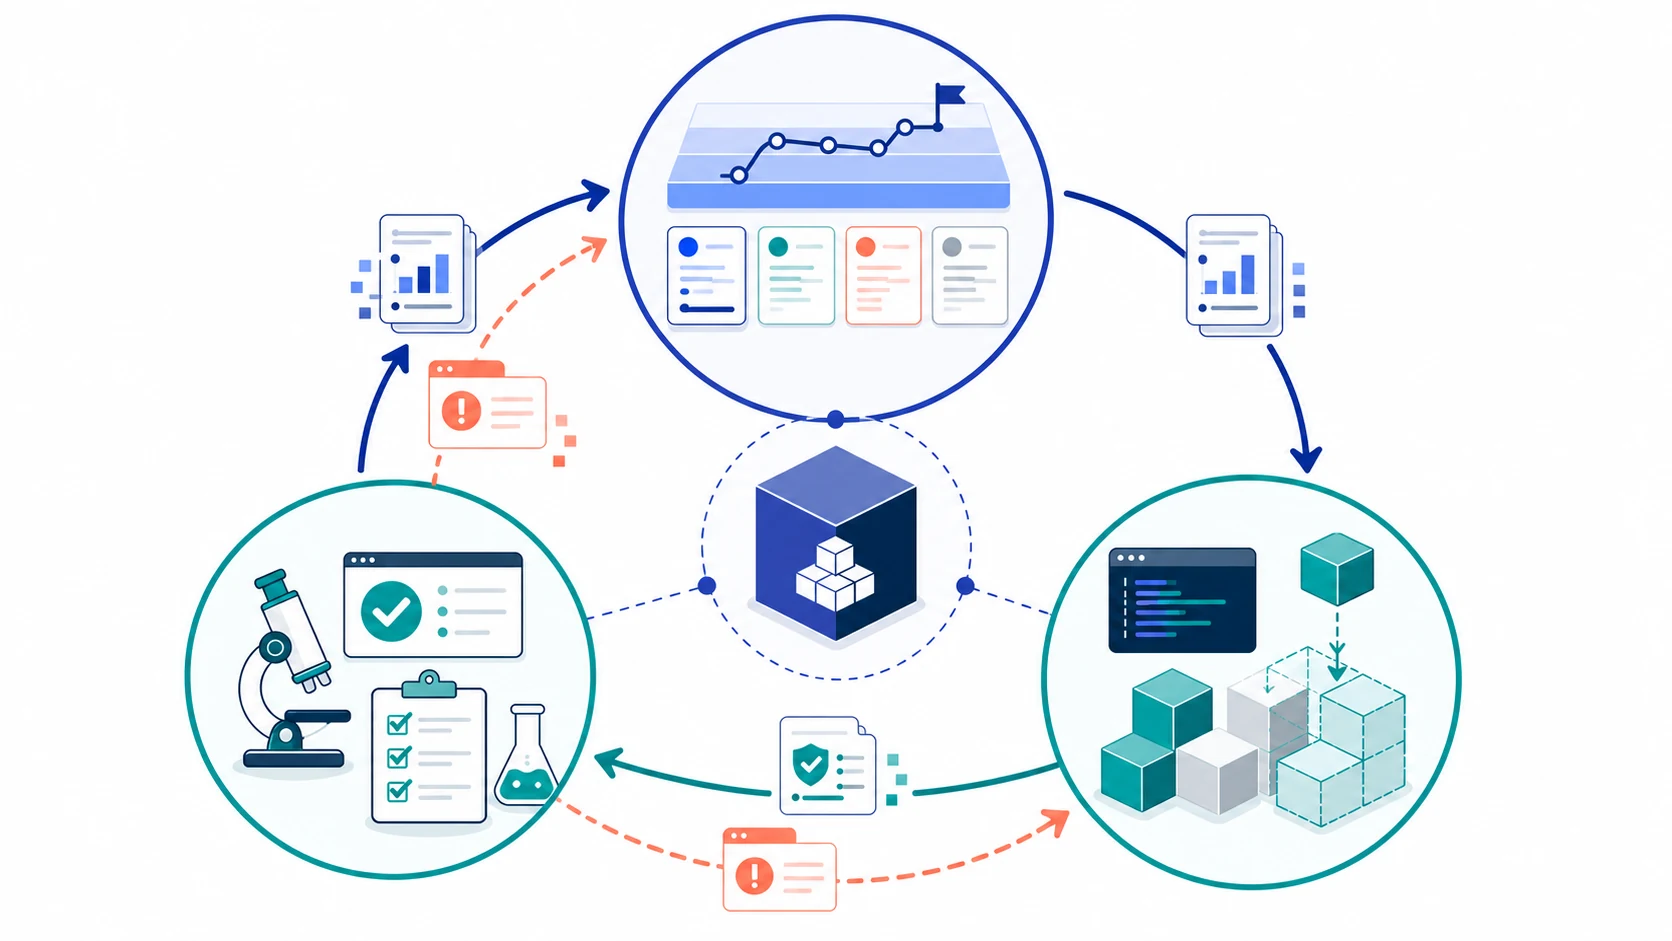
HoHは、一回の巨大な指示を三つの役割へ分けます。
- Project Plannerは、要求、前回の計画、テスト証拠、未解決問題を読み、次の小さな開発単位を決めます。
- Developerは、その計画だけを実装し、作業中のテストも行います。
- QA Testerは、実装とは別の立場で完成物を動かし、要求と今回の計画を満たしたかを記録します。
重要なのは、三つのAIを置いたこと自体ではありません。各役割が返す成果物を固定し、計画書、更新済みソフトウェア、テスト報告、問題一覧を次のループへ渡すことです。
出力の形式が崩れたら再試行します。一方、役割の中でどの道具を使い、どう考えるかまでは細かく縛りません。結果は検証可能にしつつ、手段には余地を残す設計です。
修理だけでも、新機能だけでも足りない
長期開発では、目についた不具合だけを追うと製品が前へ進みません。逆に新機能ばかり足すと、壊れた土台の上へ建て増すことになります。
HoHのPlannerは、各周回で未解決問題の修理と、小さいながら具体的な能力追加を両方含む計画を作ります。Developerは前回までの動く成果物を引き継ぎ、QA Testerは白箱と黒箱の両方から確認します。
記憶についても、すべてを会話へ戻す専用メモリは使いません。まず短い索引だけを見せ、必要な計画や証拠をファイルから取り出す段階的な開示を使います。長い履歴を丸ごと毎回読ませるのではなく、必要な記録を必要な役割へ届ける考え方です。
これは派手な自己改良より、よくできた引き継ぎに近い仕組みです。モデルが突然賢くなるのではありません。前回の失敗を、次回が使える形へ変換しています。
三つの環境で何が変わったか
研究チームは、次の三つの組み合わせを比較しました。
- Codex CLI 0.142.5とGPT-5.5(High)
- OpenCode 1.14.30とDeepSeek-V4-Pro
- Pi Coding Agent 0.80.10とMiniMax-M3
評価先も一種類ではありません。ゲームを最初から作るGameCraft-Bench、リポジトリ単位の開発を扱うFrontierSWE、隠れた挙動テストでプログラム再構築を測るProgramBenchを使っています。
3回のHoHループ後、主要な集計値はすべて通常実行を上回りました。
- GameCraft-Benchは、Codexで49.58から71.52、OpenCodeで26.90から48.98、Piで42.16から58.78へ上昇しました。
- FrontierSWEの平均報酬は、0.31から0.54、0.23から0.31、0.26から0.55へ上昇しました。
- ProgramBenchの平均テスト通過率は、60.41から66.50、45.27から57.56、35.83から52.68へ上昇しました。
論文は、3回後の平均相対改善を52.25%、最大を82.86%と報告しています。ただし、相対値は出発点が低いほど大きく見えます。実務で判断するときは、上の絶対値と一緒に読む方が安全です。
「たくさん使ったから伸びた」だけではないのか
HoHにはPlannerとTesterの呼び出しが増えるため、当然ながら一回実行より多くのトークンを使います。CodexのGameCraft-Benchでは、一回の通常実行が平均2.59Mトークン、HoHの3回が8.41Mトークンでした。
そこで研究チームは、通常のDeveloperだけを2回、3回と続ける比較も行いました。
- 通常1回は49.58点、2.59Mトークン
- 通常3回継続は58.24点、6.33Mトークン
- HoH 2回は64.84点、5.67Mトークン
- HoH 3回は71.52点、8.41Mトークン
特にHoH 2回は、通常3回より少ないトークンで高い点を取りました。追加計算だけでなく、計画と証拠の受け渡しが改善へ寄与したことを示す比較です。
それでも、HoH 3回の絶対コストが軽いわけではありません。品質と費用の両方を測り、どの段階で止めるかを決める必要があります。
どの部品が効いたのか
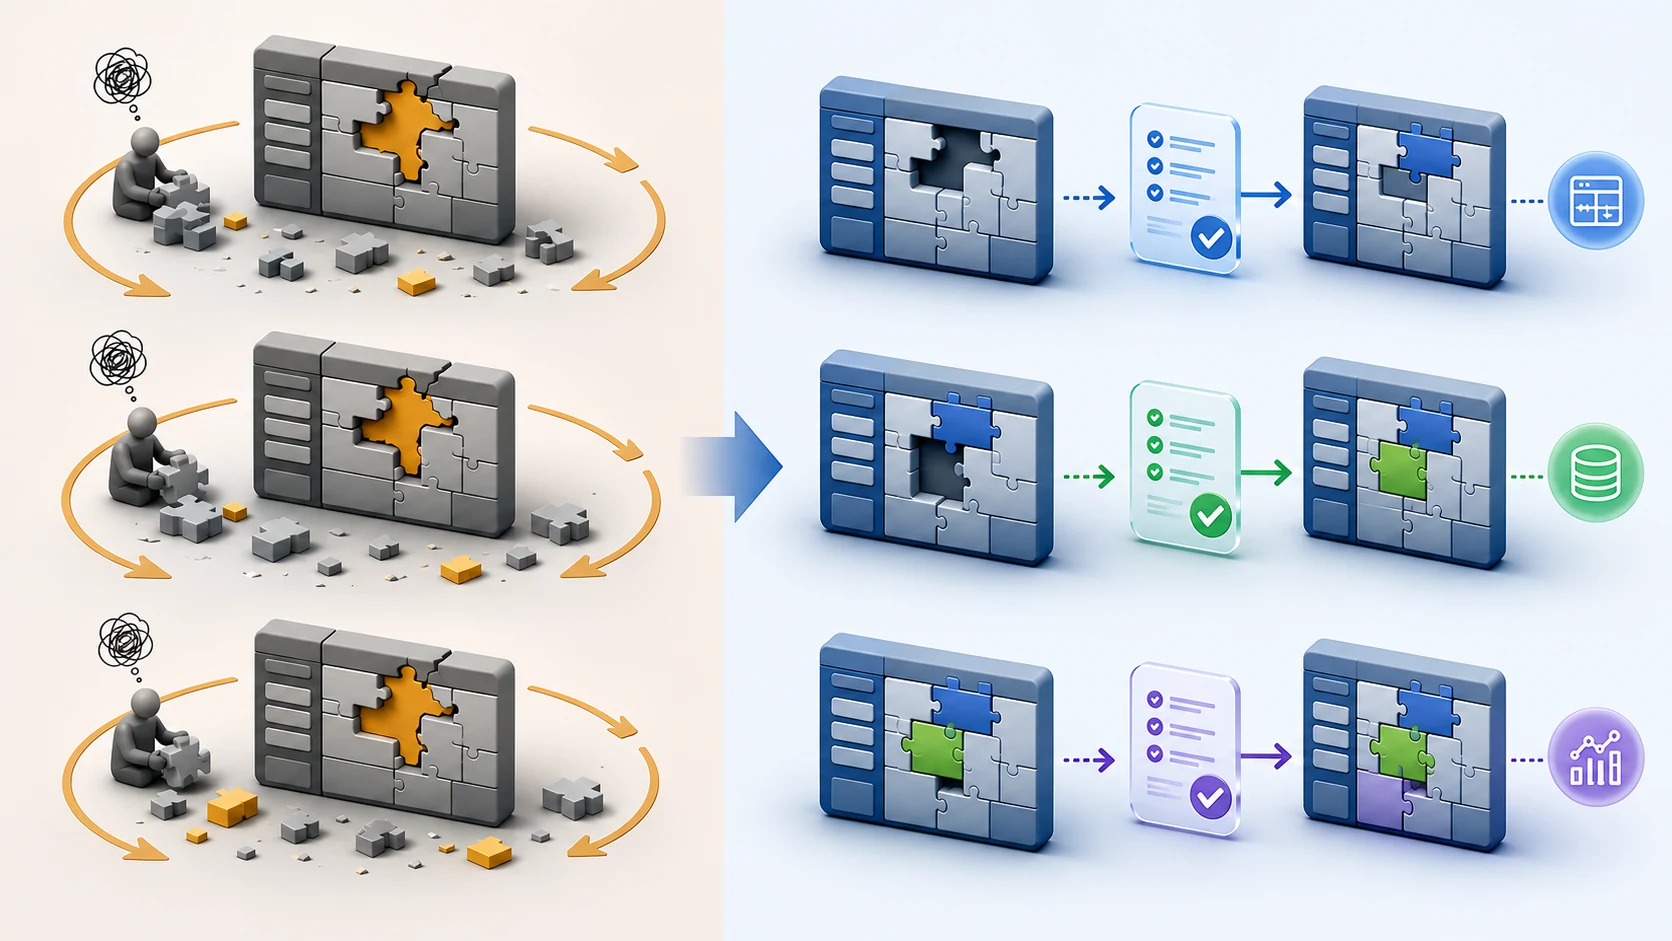
45件すべてのGameCraft-Benchタスクで、三つの部品を一つずつ外す実験も行われました。
- 次の周回で計画を更新しないと、71.52点から63.39点へ低下
- 前回のテスト証拠をPlannerへ渡さないと、65.23点へ低下
- 前回の成果物を引き継がず毎回作り直すと、63.67点へ低下
作り直す条件では、平均トークンも8.41Mから11.12Mへ増えました。過去の成果物を残すだけでは足りず、検証証拠を使って計画を更新することが重要です。
この結果から言えるのは、長期エージェントに必要なのが無限の会話履歴ではないということです。必要なのは、動く成果物、未解決問題、確認済みの挙動、次の小さな約束です。
70周したゲームは、本当に完成したのか
研究チームは、空の作業場所と製品要求書だけから、Godot 4.7の一人用FPS「Fusepoint」を作るケースも公開しました。使用したのはCodex CLIとGPT-5.6-SolのHigh設定です。
70ループの間に、基本マップ、武器、敵、HUD、音声、ミッション進行などが積み上がりました。公開されたFusepointリポジトリには、ゲーム本体、コミット履歴、開発記録が含まれています。
ただし、論文の時点で記録された81件の問題のうち、閉じたのは65件です。16件は未解決で、いったん閉じた後に再発して開き直した問題も17件ありました。
ここがむしろ現実的です。70回動かせば無傷の完成品になるのではなく、機能追加によって新しい不具合が見え、修正後にも回帰が起きます。HoHの価値は失敗を消すことではなく、失敗の履歴を次の仕事へ戻せることにあります。
人間の関与はネットワークやAPIの復旧に限定され、計画、実装、デバッグ、テスト、受け入れ判断には入らなかったと論文は説明しています。ただし、これは一つのゲーム開発事例です。一般の業務システムでも同じ自律性が続くとは、まだ証明されていません。
AICompanyなら小さくどう試すか
ここからは論文の主張ではなく、AICompanyとしての応用案です。
いきなり70ループを回す必要はありません。既存の小さなツール改善で、次の3回だけ試せます。
- Plannerは、要求、未解決問題、前回のQAだけを読み、「一つ直す、一つ増やす」という計画を作る。
- Developerは、既存の動作を壊さない条件を添えて実装し、自分の確認結果を残す。
- QAはコードを変更せず、要件、回帰、画面、失敗経路を確認し、証拠と未解決問題を返す。
- 次の周回では、会話全文ではなく、計画、差分、QA、問題一覧だけを渡す。
- 3回後に、通常の3回継続と比べて、完了要件数、再発不具合、トークン、所要時間を測る。
ポイントは、役割名を増やすことではありません。QAの証拠が次の計画を変えたか、動いていた成果物を守れたかを記録することです。
この試験はHoHの再現ではありません。論文の設計原理を、費用を抑えた社内比較へ移したものです。
まだ信用しすぎてはいけない点
第一に、各タスクと条件の組み合わせは一回しか実行されていません。集計は多数のタスクを平均していますが、同じ条件を乱数違いで何度も走らせた結果ではありません。三つのクライアントに共通する再現可能な生成シードもなく、temperatureやtop-pも固定し直していません。
第二に、3回のHoHは安価ではありません。GameCraft-Benchで平均8.41Mトークンを使っており、品質上昇が費用に見合うかは製品ごとに違います。
第三に、70ループの事例は一つのゲームです。TesterはDeveloperから分離されていますが、人間の外部監査ではありません。実ユーザーが遊んだ比較試験も報告されていません。
第四に、公開性には段差があります。公式リポジトリには論文、説明、動画があり、Fusepointにはゲームと開発記録があります。一方、再利用できるHoH-lite実装はREADMEで「coming soon」とされています。AICompanyでは全ベンチマークを再実行していません。
結論
Harness-of-Harnessが示したのは、長期開発の性能を上げるために、必ずしも新しい巨大モデルが必要ではないということです。
CodexのGameCraft-Benchでは、通常の3回継続が58.24点だったのに対し、計画、実装、独立テストを証拠でつないだ3回は71.52点でした。計画更新、テスト証拠、成果物の引き継ぎを一つずつ外すと、すべて成績が下がりました。
実務で持ち帰るべきなのは「AIを70回回せば完成する」という夢ではありません。次の担当が迷わない証拠を残し、直す仕事と増やす仕事を同じ小さな周回に入れることです。
長期エージェントの強さは、記憶量だけでは決まりません。昨日の失敗を、今日の計画へ変えられるかで決まります。