
エージェント評価の途中打ち切りで入力トークンを最大44.1%削減。EarlyEvalが変える改善ループ
AIエージェントの評価は、最後まで走らせなくても結末が見えていることがあります。
正しい修正を終えたのに、念のため同じテストを何度も回す。反対に、同じエラーと編集を往復し、残り時間では立て直せそうにない。それでも従来のベンチマークは、停止条件に達するまでモデルを呼び続けます。

2026年9月2日に公開された論文「EarlyEval」は、この「もう結果が読める区間」を機械学習で見つけます。SWE-bench Verified、TerminalBench、Toolathlonの3評価で、エージェントの途中経過から最終的な成功か失敗を予測し、推測に十分な確信が出た時点で実行を止めました。
論文の推奨設定では、実行ステップを13%から26%減らし、入力トークンは最大44.1%、出力トークンは最大29.4%削減しました。ただし、これは「最終評価を省いてよい」という話ではありません。EarlyEvalが狙うのは、開発中に何度も繰り返す比較を安くすることです。
評価費は、問題数だけでなく一問の長さでも膨らむ
通常の言語モデル評価は、一つの質問に一つの回答を返して終わります。ところが、コーディングやツール操作を行うエージェントは違います。
リポジトリを検索し、ファイルを読み、編集し、テストし、エラーを受けて修正する。1タスクの中でモデル呼び出しが何十回も続き、履歴が長くなるほど毎回読み直す入力トークンも増えます。
論文が2026年6月に取得したOpenHands Indexの例では、OpenHandsでSWE-bench Verifiedを1回評価する費用は、モデルによって715ドルから935ドルでした。SWE-bench Multimodalでは641ドルから2,270ドルです。しかも、これは一つのエージェント設定を一度評価する費用です。
プロンプト、利用モデル、ツール、実行方針を変えるたびに再評価すれば、費用はすぐに積み上がります。
これまでの効率化は、500問から代表的な問題だけを選ぶように、主に「何問走らせるか」を減らしてきました。EarlyEvalは別の方向を見ます。選んだ一問の中で「どこまで走らせるか」を短くします。
EarlyEvalは途中の行動から成功と失敗を別々に読む
仕組みは二段階です。
最初に、すでに最後まで評価済みの履歴を集めます。各履歴には、操作の列と最終的な成功または失敗のラベルがあります。次に、履歴を1手目まで、2手目まで、3手目までという途中状態へ分解し、その時点で見えている特徴から最終結果を学習します。
使う特徴は大きく三つです。
- 行動の特徴
ファイル閲覧、検索、編集、テスト、コマンド実行、ツールエラーなどの回数を数えます。最後の操作、最初の編集までの時間、同じ検索の反復、テストせず提出しようとしているか、失敗数が減っているかといった仕事の進み方も含みます。
- 文章の特徴
タスク説明、エージェントの操作文、環境から返ったメッセージをTF-IDFとSVDで小さな数値表現へ変換します。大きな言語モデルを毎手呼んで判定するのではなく、軽い特徴量として扱います。
- 正解との距離
正解パッチが公開されている場合は、触ったファイル、API名、テスト名が正解とどれだけ重なるかを使います。正解がないTerminalBenchとToolathlonでは、この特徴を外します。
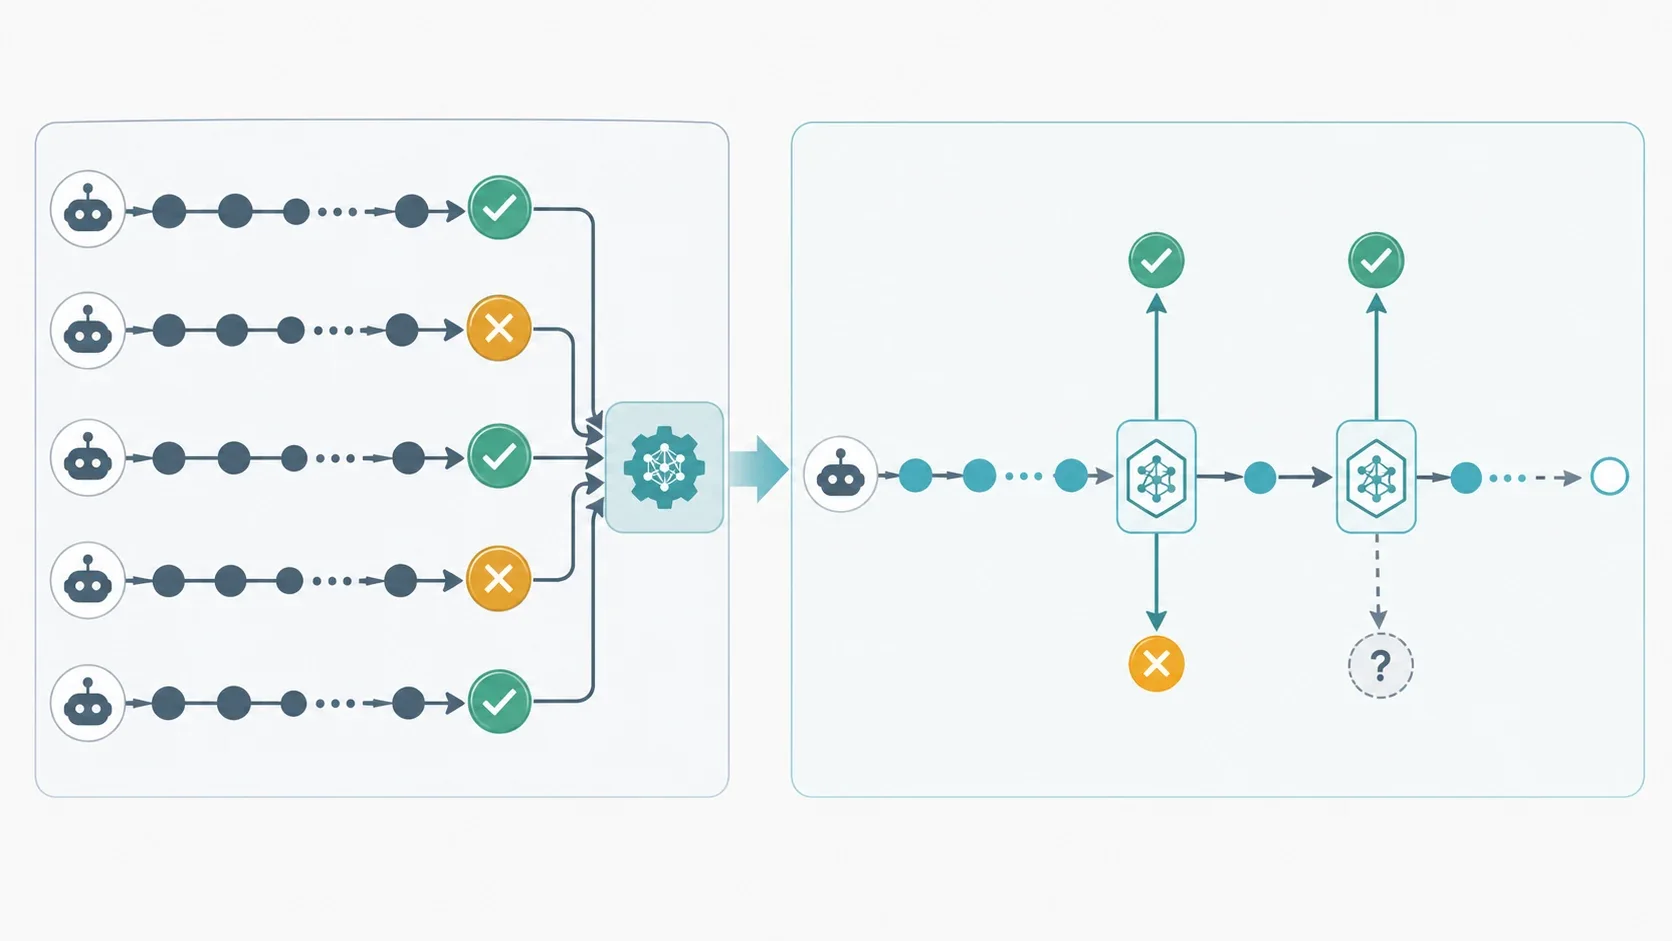
これらを入力にして、成功用と失敗用の二つのLightGBM分類器を学習します。成功らしさがしきい値を超えれば成功として止め、失敗らしさが超えれば失敗として止めます。どちらにも十分な確信がなければ、エージェントは次の手へ進みます。
成功と失敗を一つの二択モデルへ押し込まない点が重要です。正しい修正とテスト成功は成功の証拠になります。一方、同じ操作の反復や改善しないエラーは失敗の証拠です。どちらの証拠も弱い灰色の区間を残すことで、分からない時には止めない設計になっています。
予測確率はPlatt scalingで校正されます。しきい値を高くすれば誤判定は減りますが、止められる実行も減ります。EarlyEvalは「何%節約できるか」だけでなく、「評価結果を何ポイントずらしてよいか」を同時に選ぶ仕組みです。
21,678本の軌跡で未見のエージェントを試した
研究チームは、3種類のベンチマークから合計21,678本の実行履歴を集めました。
- SWE-bench Verified:16モデル、7,805軌跡
- TerminalBench:37のモデルと足場の組み合わせ、6,757軌跡
- Toolathlon:22モデル、7,116軌跡
評価では、一つのエージェント設定を試験用に外し、残りの設定だけで分類器を学習するleave-one-agent-out方式を使いました。学習済みの分類器が、見たことのないモデルや実行足場にも使えるかを確かめるためです。
TerminalBenchでは、さらに厳しい二つの条件を置きました。一つは試験対象と同じ基盤モデルを学習から全て外す条件、もう一つは同じ実行足場を全て外す条件です。モデルだけでなく、操作のリズムを作る足場が変わった時の崩れ方まで調べています。
SWE-benchではステップ26.0%減、評価値のずれは1.1ポイント
SWE-bench Verifiedの推奨しきい値0.95では、EarlyEvalは34.8%の実行を途中で判定しました。その結果、全体の実行ステップは26.0%、入力トークンは32.7%、出力トークンは28.7%減りました。
途中判定の正解率は95.0%です。ただし、この95.0%と「エージェントの性能」は別物です。95.0%は、EarlyEvalが途中で止めた実行について、最後まで走らせた場合の成功か失敗をどれだけ当てたかを示します。
途中停止後に計算した各エージェントのPass@1は、完全実行と平均1.1ポイントずれました。16エージェントの順位相関は0.991で、81%は順位が変わりませんでした。
これは開発中の比較には有用な精度です。しかし、1.1ポイント差が順位や主張を変える接戦では無視できません。論文自身も、公開する正式スコアは最後まで実行すべきだと明記しています。
Toolathlonでは入力トークンを44.1%減らした
ツール利用を測るToolathlonでは、しきい値0.90でステップを23.0%、入力トークンを44.1%、出力トークンを29.4%減らしました。Pass@1の平均絶対差は0.9ポイント、22モデルの順位相関は0.994です。
入力トークンの削減率がステップ削減率より大きいのは、後半ほど長い履歴を読み返すためです。最後の数手を止めるだけでも、初期の数手より多くの入力を省けます。
一方、Toolathlonでは成功判定より失敗判定が中心でした。正解パッチがない環境では「正解に近づいた」という強い手掛かりを使えません。それでも、反復、停滞、エラーの残り方などから失敗を早めに見つけられたという結果です。
エージェントの行動は、モデル名より足場に左右される
TerminalBenchの厳格な比較は、便利な注意点を示しました。
同じモデルを学習から外しても、しきい値0.90の条件では失敗側の予測を使って24.6%のステップを削減し、順位相関は0.959でした。ところが、同じ実行足場を外すと、推奨条件でのステップ削減は12.7%まで下がります。
論文は、足場が検索、編集、テスト、環境応答の順番を決めるためだと説明します。モデルが変わっても作業の骨格は似ますが、Codex、Claude Code、OpenHandsのように足場が変わると、途中履歴の形そのものが変わります。
ここから得られる実務上の教訓は単純です。新モデルを追加しただけなら既存の停止器が働く可能性があります。ツール構成や実行ループを大きく変えたら、以前の停止器をそのまま信じず、再校正が必要です。
なぜ判定役にもLLMを使わなかったのか
途中経過の判定なら、別のLLMに履歴を読ませる方法も考えられます。しかし、毎ステップで判定用モデルを呼べば、節約したい費用を別のモデルへ付け替えることになります。
SWE-bench Verifiedの比較では、微調整したQwen 0.5B判定器は18.7%の実行を止め、正解率90.7%、ステップ削減17.9%でした。LightGBMは34.8%を止め、正解率95.0%、ステップ削減26.0%です。
LightGBMの判定は単一CPUコアで1ミリ秒未満と報告されています。複雑な判断を担う本体はLLMのまま、繰り返し実行される交通整理だけを小さなモデルへ渡す。この役割分担がEarlyEvalの実用性を支えています。
実務では二車線の評価にすると安全
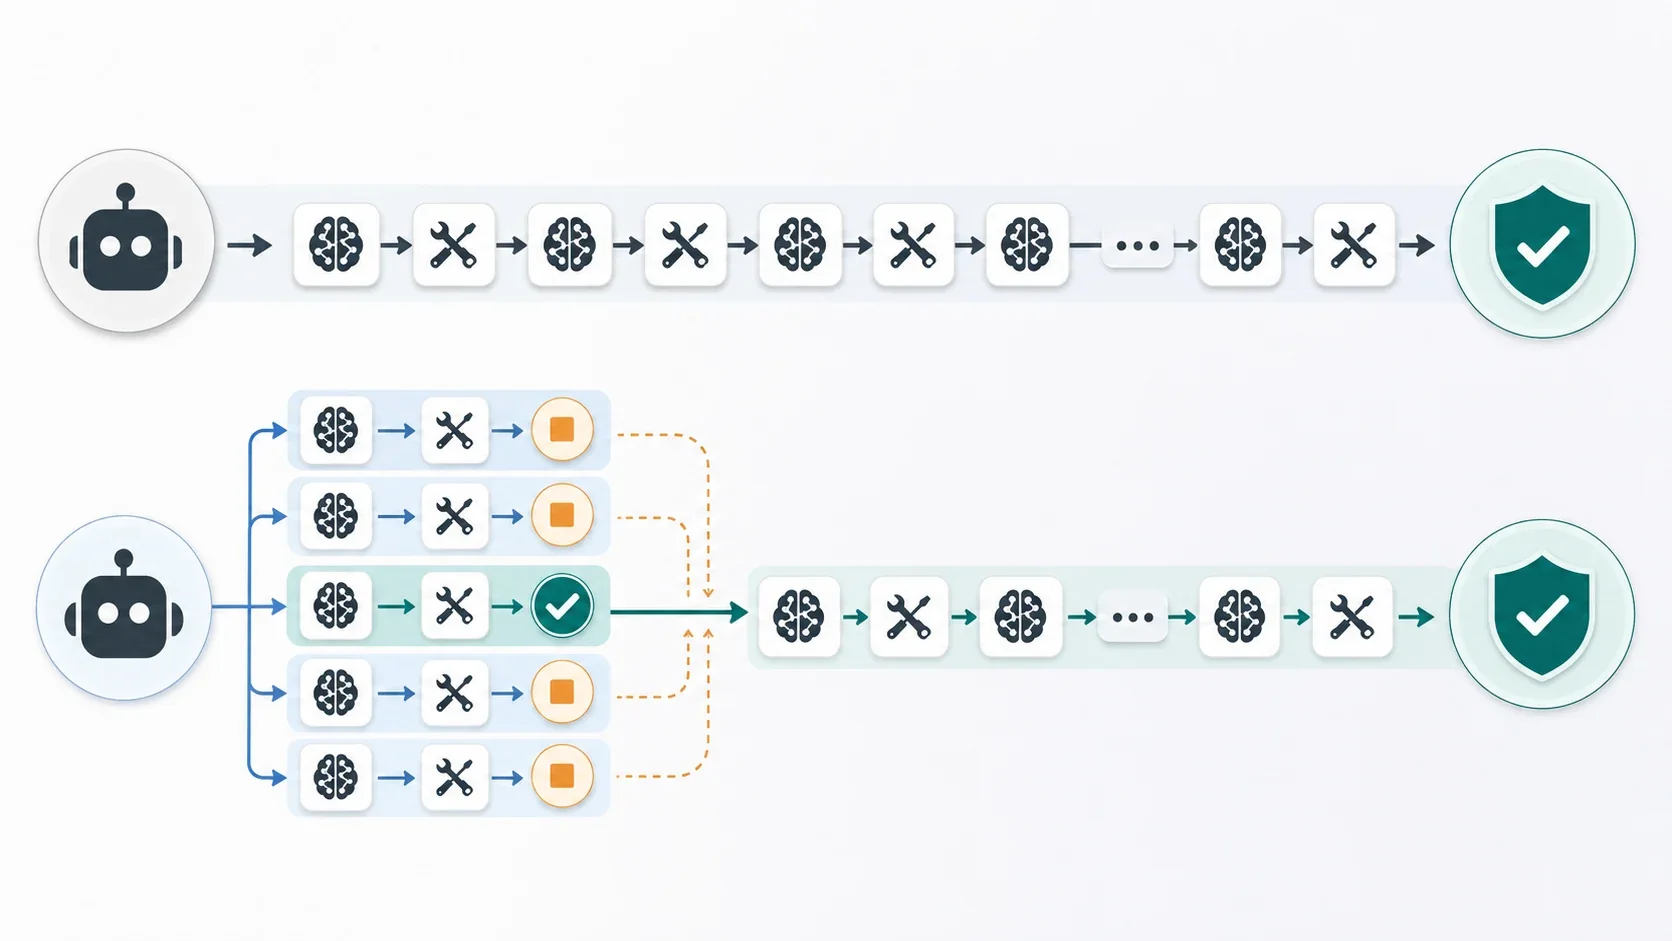
EarlyEvalの考え方を導入するなら、全ての評価を一気に置き換えるより、開発用と公開用を分けるのが安全です。
開発車線
毎日のプロンプト修正、ツール追加、停止条件の調整では、途中判定を使って候補を絞ります。しきい値は、節約率ではなく許容するスコア差から決めます。
記録する項目は少なくとも次の五つです。
- 途中で止めた実行の割合
- 途中判定の正解率
- ステップと入出力トークンの削減率
- 完全実行に対する平均スコア差
- 順位が入れ替わった候補数
公開車線
採用候補、リリース前の回帰試験、外部へ出すベンチマーク値は最後まで実行します。途中判定は、正式な合否を置き換えるのではなく、どの候補へ完全評価の予算を使うかを決める予選にします。
この二車線なら、日々の反復を速めながら「打ち切った推測値を正式結果として出す」という事故を防げます。評価費のダイエットは必要ですが、体重計まで捨ててはいけません。
小さく試すなら、まず失敗側だけで始める
自社のエージェントに試す場合、最初から論文の全特徴を再現する必要はありません。
まず過去の完全実行から、次のような単純な行動特徴を作れます。
- 同じコマンドや検索を繰り返した回数
- 最後の編集から経過した手数
- テスト失敗数が改善したか
- タイムアウトや権限エラーの有無
- 残り予算に対する未解決エラー数
そして失敗予測だけを学習し、非常に高い確信が出た時だけ停止します。成功側は「あと一回のテストで確定する」場面を誤って切りやすいため、後から追加する方が安全です。
検証では、時間順に古い履歴で学習し、新しいモデルや足場で試します。ランダム分割だけでは、同じタスクや似た実行パターンが学習側と試験側へ混ざり、実運用より良く見える恐れがあります。
限界は、過去の失敗に似ていることと本当に失敗することの差
EarlyEvalには明確な利用条件があります。
第一に、完成済みで結果ラベルの付いた履歴が必要です。新しいベンチマークの初回評価には使えません。履歴が増えるほど有利になる仕組みです。
第二に、分布が変わると精度が落ちます。新しい足場は操作の順序やエラーの見え方を変えるため、以前の特徴が通用しない可能性があります。
第三に、途中停止は成功率を完全には保存しません。推奨設定でも約1〜2ポイントのずれがあります。差が小さい候補を比較する時や、正式な順位を出す時は完全実行が必要です。
第四に、公開リポジトリはコード中心です。学習、特徴生成、アブレーション、再生、表生成のコードはありますが、生の軌跡、加工済みテーブル、学習済みモデル、予測結果、論文表は含まれていません。リポジトリにはライセンス表示も確認できませんでした。コードが読めることと、研究結果をすぐ完全再現できることは別です。
第五に、論文の多くの削減値は保存済み軌跡を使った再生評価です。実際のAPI価格、待ち時間、並列実行、キャッシュを含む運用費が同じ割合で下がるとは限りません。
結論:全部走らせる前に、何のための数字かを決める
EarlyEvalの新しさは、単に「失敗しそうなら早く諦める」ことではありません。成功と失敗の途中証拠を校正し、節約率と評価値のずれを同じ表で選べるようにした点です。
3ベンチマークと21,678軌跡の結果は、反復開発の評価を軽くできる可能性を示しました。特に、後半の長い文脈を切ることで、ステップ以上に入力トークンを減らせる点は実務的です。
同時に、論文は使い分けの線も引いています。開発中の方向確認には途中予測を使い、公開する数字は最後まで走らせる。評価を安くするほど、どこから先が推定値かを明確にする必要があります。