
テストを通っても3件に1件はレビュー失格。SWE-Gateが示したコードエージェント評価の盲点
「テストは全部通りました」。コードエージェントからこの報告が来れば、仕事はほぼ終わったように見えます。
ところが、新しいベンチマーク「SWE-Gate」では、機能テストを通過した644件の修正のうち221件が、別に用意されたレビュー制約テストに失敗しました。割合にすると34.3%です。動くけれど、そのままでは受け入れにくい修正が約3件に1件ありました。

これは「AIはコードを書けない」という話ではありません。むしろ、私たちが成功を測る物差しに、一本足りなかったという話です。
従来の評価が見ていたのは「直ったか」まで
代表的なコードエージェント評価では、実際のリポジトリと課題を渡し、生成されたパッチがテストを通るかを確認します。バグが再現しなくなり、期待した出力が返れば成功です。
しかし、現場のコードレビューでは、それだけでマージされるとは限りません。
- 既存APIとの互換性を壊していないか
- 例外の種類や発生条件を変えていないか
- 一時ファイルや接続を確実に片付けるか
- 型やスキーマの約束を守っているか
- 一部の入力だけでなく、適用範囲全体を直しているか
- 同じ処理を繰り返しても重複や破損が起きないか
こうした条件は、目の前の機能テストに現れないことがあります。機能は直った。しかし公開インターフェースを変えてしまった。正常系は通った。しかし失敗時の後片付けが抜けた。人間のレビューで止まるのは、だいたいこの辺りです。テストが青でも、レビュー欄は赤い。少し信号機が忙しい状態です。
SWE-Gateは「機能」と「受け入れ条件」を分けた
SWE-Gateの論文は、実際のプルリクエストのレビューコメントから、客観的に検証できる受け入れ条件を抽出します。その条件を別のリポジトリへ移し、機能修正とレビュー制約を独立して試せる課題を構成しました。
ベンチマークには303件の修正課題があり、75のオープンソースPythonリポジトリをカバーします。各課題には、次の要素が含まれます。
- 利用者から見える不具合の説明
- 不具合を埋め込むパッチ
- 不具合が直ったかを見る機能テスト
- レビュー由来の制約説明
- 制約を守ったかを見る制約テスト
- 機能は直すが制約には違反する参照パッチ
- 機能と制約の両方を満たす正解パッチ
重要なのは、機能テストと制約テストが同じものを言い換えていない点です。機能だけ直した修正が実際に作れ、それが制約テストでは落ちる。さらに、両方を満たす修正も存在する。この4状態をDocker上で実行し、最後は人手でも確認しています。
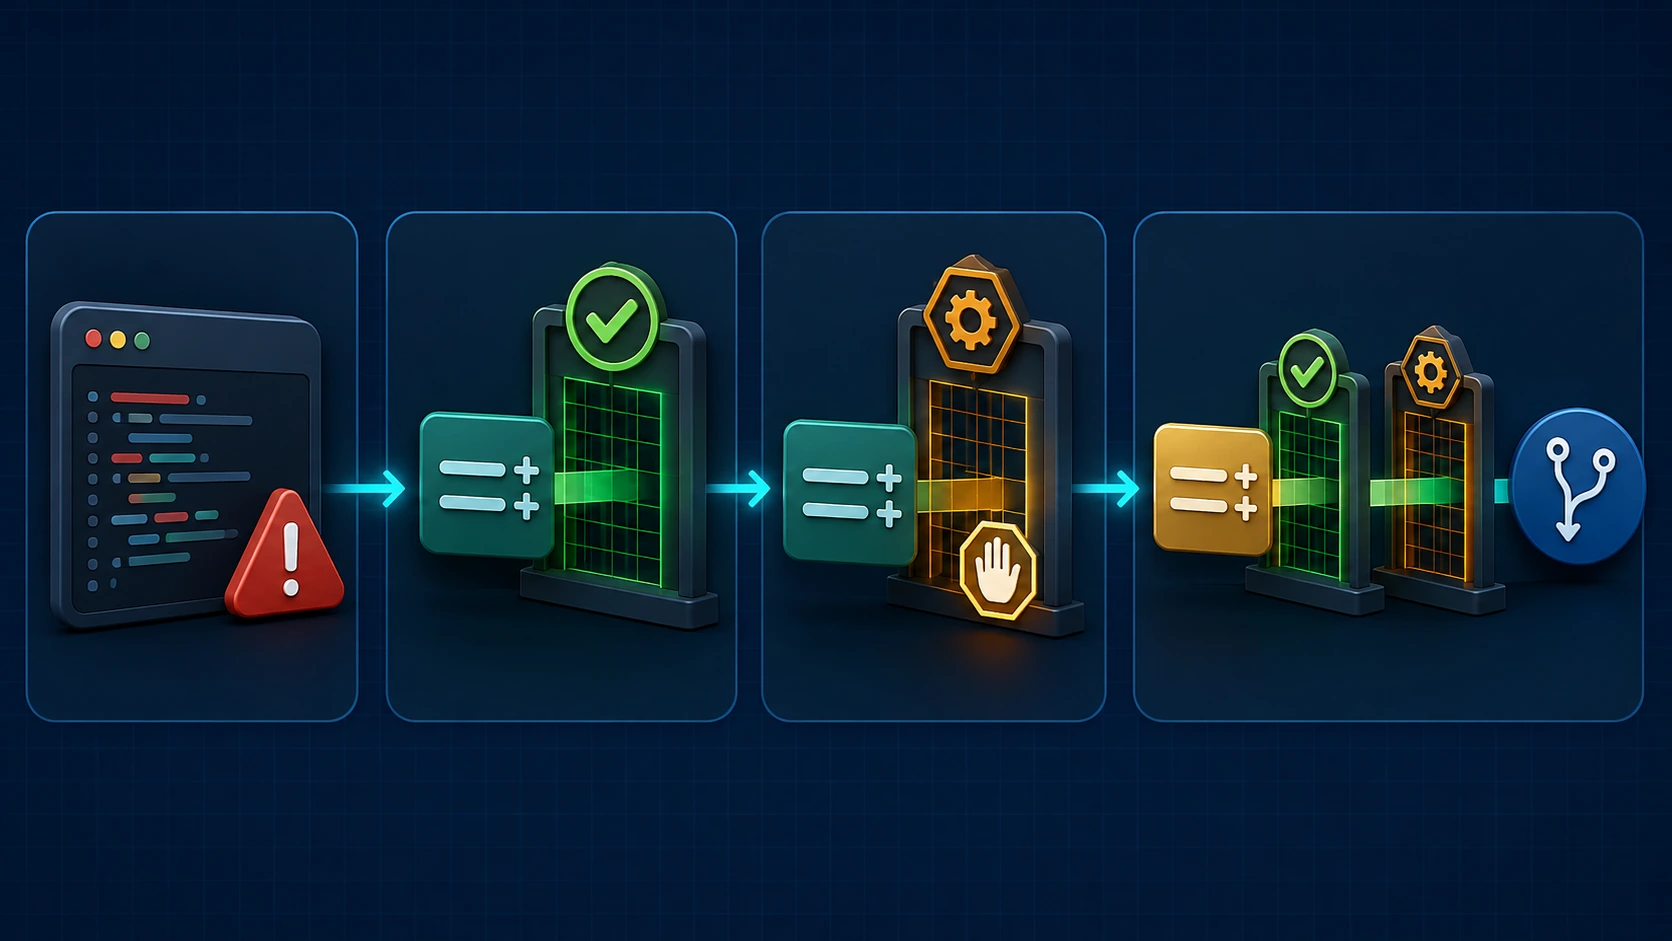
最も強いモデルでも、機能成功の29.5%が隠れた失敗
研究チームは、GPT-5.5、GPT-5.4-mini、DeepSeek-V4-Flash、GPT-4o-miniを、同じMini-SWE-Agentと最大100ステップの条件で評価しました。
レビュー制約を指示に含めた場合、GPT-5.5の機能成功率は74.9%でした。一方、機能と制約の両方を通る共同成功率は52.8%です。GPT-5.5が機能テストを通した227件のうち、67件は制約テストに失敗しました。隠れた失敗率は29.5%です。
4モデル全体では次の結果でした。
- 機能テストを通過した修正は644件
- 機能と制約の両方を通過した修正は423件
- 機能だけ通り、制約に失敗した修正は221件
- 隠れた失敗率は34.3%
弱いモデルだけの問題でもありません。隠れた失敗率は、GPT-5.5の29.5%からGPT-4o-miniの53.6%まで、すべてのモデルで確認されました。
制約を明記すれば改善する。ただし無料ではない
では、レビュー制約を最初から指示に書けば解決するのでしょうか。
GPT-5.5では、制約を渡さない場合の共同成功率41.3%が、制約を渡すと52.8%へ上がりました。11.5ポイントの改善です。機能修正に成功した中で制約も守れた割合は、54.6%から70.5%へ上がりました。
一方で、機能成功率は75.6%から74.9%へわずかに下がりました。他の3モデルでも、制約を渡した条件では機能成功率が3.3から9.9ポイント低下しています。
論文は、各モデルと各課題につき生成が1回なので、制約の提示が一般に機能修正を悪化させるとまでは主張していません。それでも、評価項目を増やせば単純に全部よくなるわけではないという注意は重要です。エージェントは追加条件へ注意を配るぶん、目の前の修正で迷うことがあります。
実務では受け入れゲートを3層にする
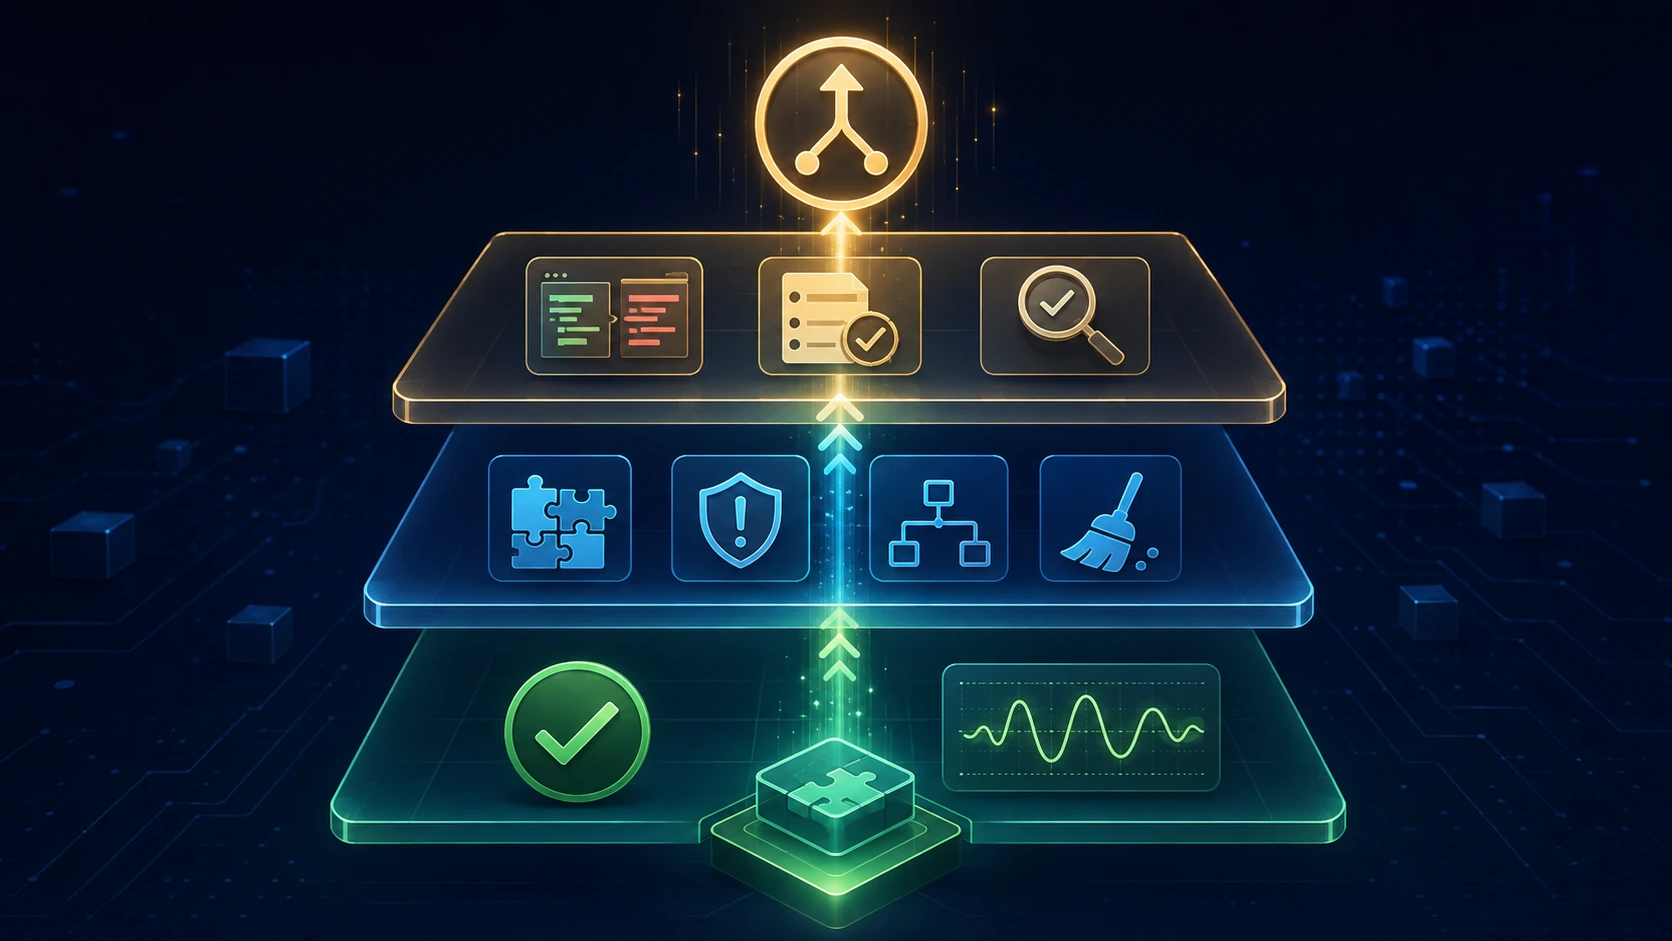
この研究から持ち帰りやすいのは、コードエージェントの成果を一つのテスト結果で判定しないことです。次の3層に分けると、SWE-Gateの考え方を小さく試せます。
1. 機能ゲート
報告された不具合が直ったかを確認します。再現テスト、正常系、主要な異常系がここに入ります。
2. 工学制約ゲート
既存契約を壊していないかを確認します。互換性、例外、型、スキーマ、順序、エスケープ、後片付け、冪等性を、機能テストとは別のチェックとして持ちます。
3. 変更証拠ゲート
差分の範囲、変更理由、追加したテスト、未検証部分を確認します。エージェント自身の「完了しました」ではなく、差分と実行結果を受け入れ証拠にします。
たとえば「CSV出力の文字化けを直す」という課題なら、出力文字列が正しいだけでは足りません。既存の引数順を保つ、指定済みエンコーディングを上書きしない、ファイルを例外時にも閉じる、といった条件を別に置きます。これで、バグ修正とリポジトリの約束を別々に評価できます。
新しいのは、レビューを自動採点へ近づけたこと
レビュー品質をLLMの採点だけに任せる方法は、判定の揺れや好みの混入を避けにくいものです。SWE-Gateは、レビューコメントを起点にしつつ、最終判定を実行可能なテストへ落としました。
もちろん、すべてのレビュー指摘を自動化できるわけではありません。命名の読みやすさ、設計の一貫性、将来の保守性などは、客観的なテストにしにくいままです。それでも、互換性や例外動作、資源解放のように機械で確認できる部分を、機能テストの陰に隠さない価値は大きいでしょう。
公開リポジトリには、303件のデータ、99のDockerベース環境、8種類のモデル条件の予測ファイル、構築スクリプト、評価コードが含まれています。論文の数字を読むだけでなく、どの条件をどう実行するかまで追える形です。
まだ言えないこと
結果をそのまま「コードエージェントの3分の1は使えない」と一般化してはいけません。
- 対象はPythonの75リポジトリで、他言語や社内コードは未検証です。
- 元のレビュー条件は実在しますが、課題は別の適合する文脈へ移して合成されています。
- 評価したのは4モデルと一つのエージェント構成です。
- 各条件は1回生成で、ばらつきの幅は測っていません。
- 公開リポジトリは監査時点で2コミットと新しく、ルートのライセンス表記も確認できませんでした。
- 303件中48件には、単独の検証行列ファイルがありません。リポジトリ側は欠落対象を明記しています。
- 本記事では公開資料を確認しましたが、Docker環境と有料モデルを使う全実験は再実行していません。
つまり、34.3%はSWE-Gateの条件で観測された値です。普遍的な故障率ではありません。
結論
SWE-Gateが突きつけたのは、コードエージェントの成功を「テストが通った」の一言で終わらせる危うさです。
機能テストは必要です。しかし、互換性、例外、型、資源管理、適用範囲といった受け入れ条件は、別のゲートとして見なければ隠れます。エージェントに制約を明記すると共同成功率は上がりましたが、機能成功との交換条件も残りました。
実務で始めるなら、機能、工学制約、変更証拠の3層です。AIに任せる範囲を広げるほど、最後の合格条件は一枚ではなく、重ねて持つ方が安全です。