
「テストは通りました」。AIにコードを直してもらうとき、この一言は頼もしく聞こえます。でも、そのテストが修正コードと同じ勘違いをしていたらどうでしょう。
Microsoft Researchなどの研究チームが公開したExecCriticは、この問題を正面から扱います。同じ修正用モデルでも、未学習のテスト作成役が用意したテストを使うと、課題の解決率が61.2%から57.3%に下がりました。実行して確かめることは大切ですが、何を確かめるかが間違っていれば、確認作業が修正を遠回りさせることもあります。

研究の中心は、テストを作る役とコードを直す役を分け、それぞれを学習させることです。さらに、修正中にテストの条件を書き換えられないようにします。「合格した」という報告の手前にある、合格基準の質を問う研究です。論文の実験結果、表2
修正とテストが、同じところを見落とす
たとえば「空の入力でも正しく扱ってほしい」という不具合があったとします。AIが通常の入力だけに注目すると、通常の入力に対応する修正を書き、その動作だけを確認するテストを用意してしまうかもしれません。
そのテストが通っても、空の入力の不具合は残ります。テストの数だけを増やしても、同じ見落としが増殖するなら安心にはつながりません。
ExecCriticは、修正案と検証基準が同じ作業履歴から生まれることに着目します。別の作業履歴でテストを作り、修正役にはそのテストを変更する権限を渡さない。まず、この分離によって「通りやすいように問題を変える」余地を減らします。
ただし、役を分けるだけでテストが正しくなるわけではありません。独立した担当者でも勘違いはします。そこで研究チームは、良いテストを作る能力そのものを学習対象にしました。
三つの提出物で、確認する行動を固定する
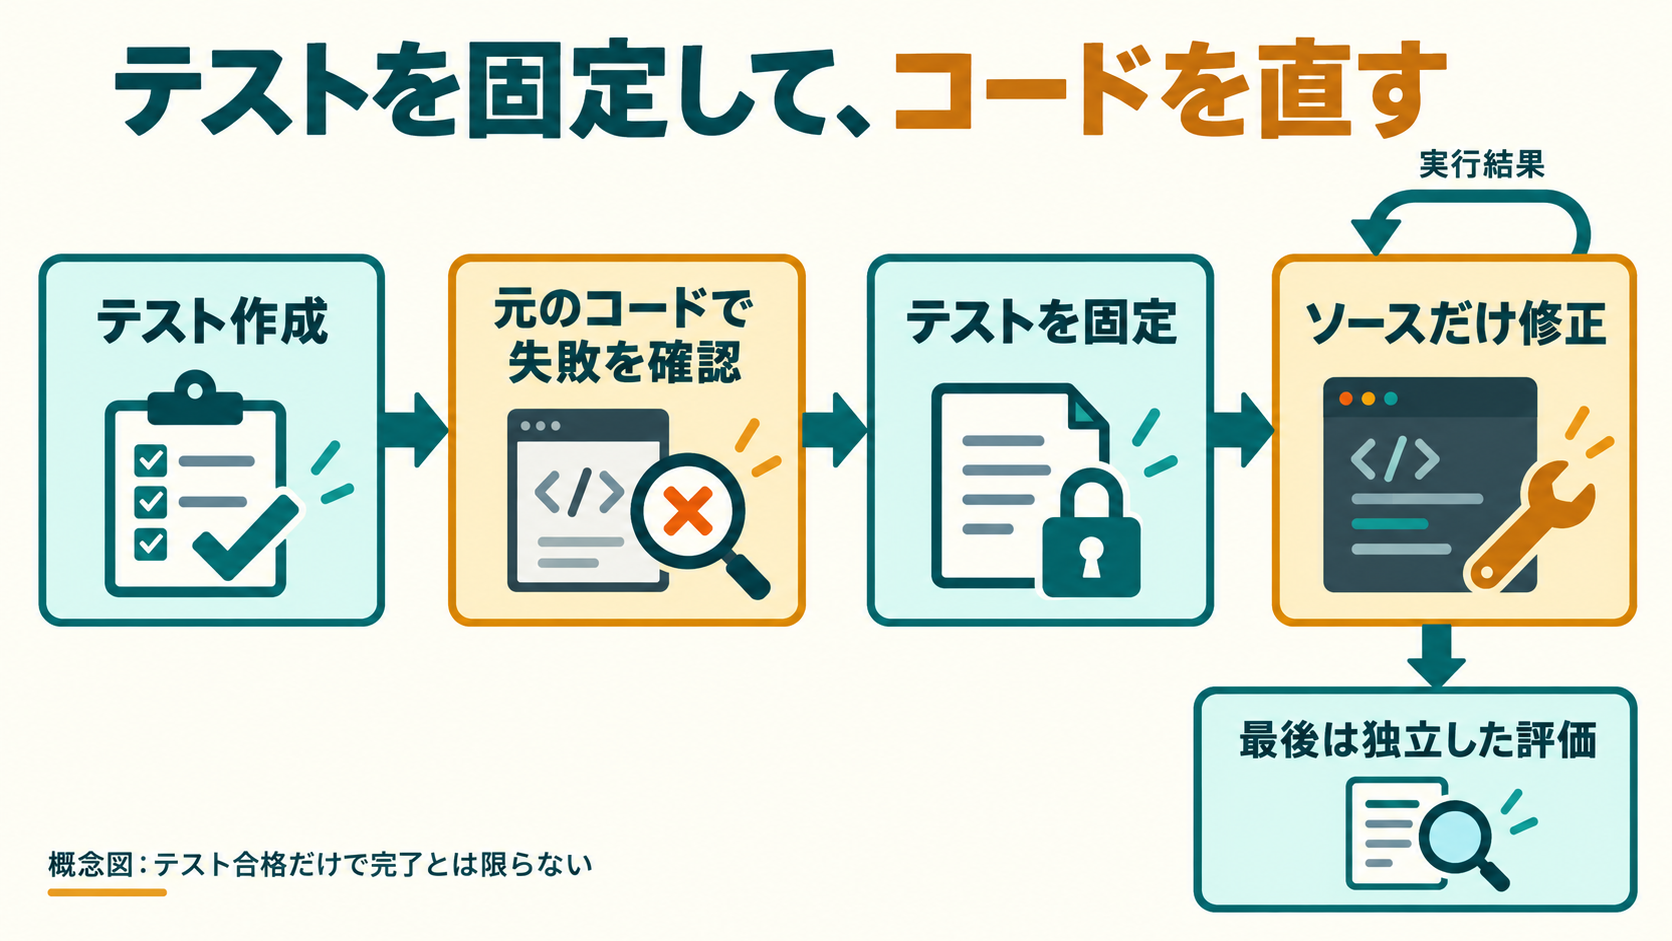
テスト作成役が提出するのは、単なるテストコードではありません。テストの変更差分、実行対象を特定したコマンド、期待する動作を記述した構造化データの三つです。
期待する動作には、呼び出す公開機能、不具合が起きる条件、期待する結果、その根拠などを含めます。これにより「コマンドが成功した」という記録だけでなく、どの要求を調べたのかを追えるようにします。
実行を管理する仕組みは、提出物の形式や実行対象を検査し、不具合のある元のコードでテストを動かします。ここで必要なのは、テストが適切に実行され、期待する動作を満たさず失敗することです。準備不足や実行環境のエラーを、不具合の再現と同じようには扱いません。
この条件を満たしたテストを固定し、修正役はソースコードだけを直します。失敗すれば結果を受け取って修正を続け、局所的なテストに通れば提出へ進みます。最終的な課題の解決判定は、別の公式評価で行います。仕組みの説明、3節と付録A.4
「元のコードで失敗する」だけでは、良いテストと断定できない
この区別は大切です。間違った期待値を書いたテストも、元のコードでは失敗できます。
研究では、学習や事後監査のときに、正解の修正を適用したコードでも同じテストを実行します。元のコードでは失敗し、正解の修正後には通るかを調べる指標がBase-to-Goldです。さらに、正しい修正候補と誤った候補を見分けられるかも学習信号に使います。
一方、評価時に修正役へ渡すテストを選ぶ際は、正解の修正やその結果を使いません。元のコードで適切に失敗することが入口です。正解を見てから都合のよいテストだけを採用する手順とは区別されています。
適格なテストを作れなかった課題も、評価から消しません。その場合は最初の修正案を公式評価へ送り、全課題の解決率に含めます。成功したテストがある課題だけで割合を計算していない点は、結果を読むうえで重要です。
72.6%という結果を、二つの改善に分けて読む
学習対象にはQwen-3.5-35B-A3Bを使い、テスト役と修正役を別々に訓練しています。SWE-bench Verifiedでの結果を整理すると、次のようになります。
- 元の修正役が追加のテストを使わない場合:61.2%。
- 元の修正役が未学習のテスト役の結果を使う場合:57.3%。
- 元の修正役が学習済みテスト役の結果を使う場合:64.1%。
- 学習済み修正役が追加のテストを使わない場合:68.3%。
- 学習済みの両者を組み合わせた場合:72.6%。
最初と最後を比べると11.4ポイントの改善です。ただし、これは「テスト役を足すだけで11.4ポイント伸びる」という意味ではありません。修正役の学習だけでも最初の解決率が7.1ポイント上がり、学習済み修正役に学習済みテスト役の結果を加えた差が4.3ポイントです。
また、テストを作る計算や追加の修正作業も増えます。同じ計算量で比較した11.4ポイントの改善ではありません。
テスト作成のBase-to-Gold成功率も、元の22.2%から、教師データによる学習後は39.6%、さらに強化学習を加えると62.2%へ上がっています。こちらは「良いテストを作れた割合」であり、「不具合を直せた割合」とは別の指標です。表1・表2
小さな開発でも取り入れられる考え方
ここからは、論文の仕組みを日々の開発へ移すための、AICompanyによる応用例です。ExecCriticの性能を再現する手順ではありません。
たとえば「重複した通知が出る」という不具合なら、修正前に「同じイベントを二度受け取っても通知は一度だけ」「別のイベントなら二度通知する」という二つの条件を書き出します。実際の要求と照らし合わせて、勝手に条件を補っていないかも確かめます。
次に、修正案を見せずに、その条件を確認するテストを別の作業で作ります。元のコードで不具合が再現することと、テスト自体が正常に動くことを確かめます。修正中は、この確認条件を固定します。
修正後には、そのテストに加えて既存の正常な動作も確認します。もし元の条件が間違っていたと分かったら、修正作業のついでにこっそり変えず、要求から見直します。
この方法の価値は、担当するAIの数よりも、要求、テスト、修正の関係を後から追えることにあります。「通りました」に対して「どの条件を、何で確認したのか」と答えられる状態を作るわけです。
公開コードがあっても、すぐ同じ結果が出るわけではない
今回の結果は研究チームによる評価であり、AICompanyがベンチマーク全体を再実行したものではありません。
解決率は三回の修正実行の平均ですが、テストは課題とテスト作成モデルごとに一度生成したものを共有しています。テストを毎回作り直したときの変動まで測った平均ではありません。
より広い修正を扱うSWE-bench Proでは、強い参照モデルに生成テストを加えた改善が61.6%から62.3%にとどまりました。一つの行動に焦点を当てたテストだけでは、要求全体を覆えない可能性があります。ただし、差の原因をテスト範囲だけに断定することはできません。
公式リポジトリには実装が公開されていますが、学習済みチェックポイントや実験結果、実行履歴、データセットは同梱されていません。公開された学習用スクリプトと論文の設定にも違いがあり、そのまま実行すれば論文の数値を再現できる配布物ではありません。
さらにREADMEは、環境を初期化しても一部の無視対象ファイルが残り得ることや、履歴へのアクセス制限の確認が十分に記録されていないことも説明しています。厳密な評価には、こうした実装上の境界も確かめる必要があります。
テストの合格を、要求の達成につなげる
ExecCriticが示したのは、確認作業の回数を増やすことより、確認する基準を育てることの大切さです。
テストを独立して作り、修正中は固定し、最後に別の評価で確かめる。そのうえで、テストそのものが要求を正しく捉えているかも調べる。AIが「直りました」と言う場面が増えるほど、この一段深い確認が効いてきそうです。
出典:Leitian Taoほか「ExecCritic: Learn to Test, Test to Improve for Coding Agents」(2026年9月8日公開)。論文、本文と付録、公開実装。図は論文の考え方をもとにAICompanyが独自に制作しています。