
「昨日は正しかった」をAIの誤答から見分けられるでしょうか。
たとえば、社内のAIに「このサービスを使っている社員は何人?」と聞く。AIは資料を見つけ、計算も正しく行い、もっともらしい人数を返す。けれど、その資料は退職者の情報が反映される前のものだった。文章を丁寧にしても、推論を長くしても、元の数字が古ければ答えは古いままです。

2026年9月10日に投稿されたChurnBenchは、この問題を調べるための評価環境です。面白いのは、単に「古い情報は危険」と言うのではなく、キャッシュを最初に作った日と、中の情報を最後に更新した日を分けて測るところにあります。
一度作ったキャッシュにも、新しい情報は入る
キャッシュは、元のデータを毎回取りに行かずに済むよう、手元に置いておく写しです。社内検索の索引や、よく使う集計結果も似た役割を持ちます。
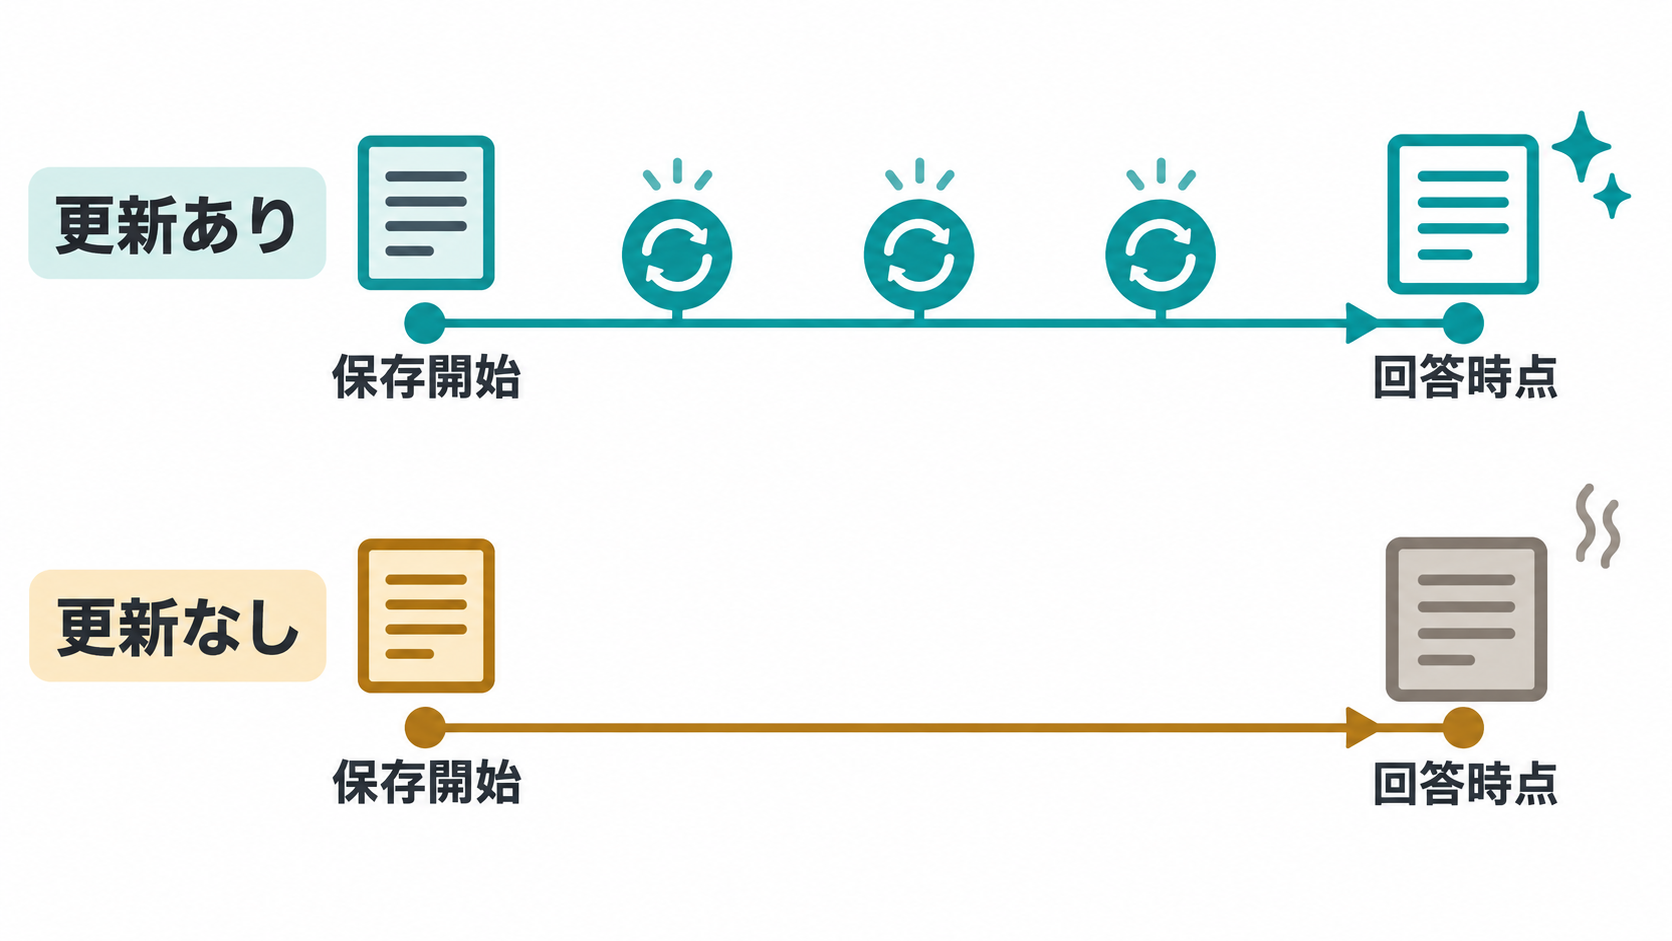
「1か月前に作ったキャッシュ」と聞くと、1か月前の情報が出てくるように感じます。しかし、利用者一覧を毎日更新していれば、その部分は昨日の情報かもしれません。一方、同じキャッシュ内の価格表は先週、契約条件は先月のまま、ということもあります。
ここで出てくるTTLは、情報をどれくらいの期間使ってから更新するかを決める期限です。保存場所が同じでも、情報ごとに期限が違えば、実際の古さも違います。
著者らは、利用者やライセンスの変更、価格改定、契約更新などが起きる架空の業務環境を作りました。変更履歴を追記式の台帳に残し、ある時点の正解をそこから計算します。AIが参照するデータベースや文書とは別に正解を持つので、「今の答え」と「情報を取得した時点の答え」を照合できます。仕組みの詳細は論文のIV節にあります。
過去には正しかった誤答を、別に数える
この研究では、現在の正解には合わず、実際に参照した情報の時点では合っている答えを「鮮度による誤り」として数えます。たまたまどこかの過去の数字と一致するだけでは足りません。参照記録に結びついた時点であることが必要です。
これには実務上の意味があります。計算手順が間違っているなら、手順を直す。古い価格を正確に足しているなら、価格の更新経路を直す。最終的な正答率だけを見ると、どちらも同じ「不正解」に埋もれてしまいます。
ただし、この分類は原因を完全に証明するものではありません。複数の資料が異なる日時を指している場合もあり、「それ以外の誤答はすべてモデルの推論能力不足」とまでは言えません。調査を始める場所を絞るための分類、と捉えるのが適切です。
更新を止めると、長い期間の条件で差が出た
著者らが公開した結果は、更新を有効にした構成と無効にした構成を、短い期間と長い期間で比べています。各条件は180問です。AICompanyでも公開JSONの各問題の判定を数え直し、次の件数を確認しました。
| 公開データの条件 | 更新あり | 更新なし |
|---|---|---|
| D+1 | 7件 | 7件 |
| D+28 | 4件 | 45件 |
表は鮮度による誤りの件数で、すべての誤答数ではありません。D+28の更新あり条件でも、正答は117問でした。更新を続ければ何でも正解になる、という結果ではありません。
日付には注意点があります。論文では長い条件を「28日」と呼んでいますが、公開JSONにある作成日2024年3月29日と評価日4月27日の差は29日です。ここでは条件名のD+28をそのまま使い、厳密な28日間の実験とは扱いません。根拠となる記録は更新ありと更新なしで確認できます。
同じ長い条件でも、更新ありの利用者情報は評価時点で1日前、価格は5日前の情報でした。更新なしでは、どちらも29日前のままです。キャッシュの箱を作った日は同じでも、中身の年齢は違う。この差が、見るべき場所を教えてくれます。日時の内訳は公開された更新時刻の表にあります。
手元の業務なら「価格が変わる午後」を作ってみる
ここからはAICompanyの応用案です。大きな評価環境を立てる前に、小さな架空データで原因を切り分けられます。
午前9時、ある商品の価格を1,000円として保存します。正午に元データを1,200円へ変更し、午後1時に「3個買うと合計いくら?」と聞く。正解は3,600円ですが、AIが午前の写しを使えば3,000円になります。
このとき、残したいのは質問と回答だけではありません。参照した価格、価格の取得時刻、計算に使った数量、評価時点の価格を一緒に残します。3,000円という答えなら、古い価格の計算には合っています。2,500円なら、更新以外の問題も調べる必要があります。
次に、同じ質問と同じモデルで、価格の再取得だけを有効にして比べます。これで直れば、少なくともこの例では更新経路が改善点です。なお、この例は説明用の思考実験で、ChurnBenchの実測値でも、特定のAI製品で実行した結果でもありません。
さらに一歩進めるなら、商品の説明文と価格を同じ頻度で更新しない設計を試せます。説明文はほとんど変わらなくても、価格や在庫は変わる。まず変更履歴を見て、変わり方に応じて再取得の間隔を決めます。誤った情報を出したときの影響も、判断材料になります。
更新を増やせば通信や処理も増えるため、最初から全部を毎回読み直す必要はありません。「どの情報を、いつ確認したか」が見えれば、費用をかける場所も選びやすくなります。
この結果を、そのまま全社システムへ広げない
ChurnBenchの評価は、合成したソフトウェア資産管理データと一つのモデル・実行基盤を使っています。評価中も世界が変化し続ける状況や、別の業種・モデルで同じ差が出るかは、まだ別の課題です。競合する構成との最終条件での比較もありません。
公開記録には通信障害後の一部問題の再実行履歴があります。また、著者らが示す別の期間比較にはモデル設定の違いがあるため、本記事の表には使っていません。実装が扱える集計項目にも不足があり、全体の正答率にはその影響が含まれます。
AICompanyが今回確認したのは、論文、公開実装、保存済み結果の集計です。モデルを呼び直す実験や、台帳から全正解を再生成する検証は行っていません。検証用の案内には結果と根拠の対応があり、一部の生の実行記録はサイズ上の理由で公開対象外とされています。
それでも、日々の運用へ持ち帰れる問いははっきりしています。「このAIはいつ作った資料を見たか」だけでなく、「回答に使った情報は最後にいつ更新されたか」。古い答えを減らしたいとき、その日時を残すところから始める価値があります。
出典:Vivek Kumar Singh、Preeti Priyam、ChurnBench(arXiv:2609.11515)、著者公開リポジトリ。