
AIに渡す手順書を何度も書き直したのに、本当に良くなったのか分からない。スキルを使い込むほど、そんな場面が増えてきます。説明を足したら別の作業で失敗し、短くしたら大事な条件を忘れる。文章の見栄えだけでは、優劣を決められません。
COBRA-Skillsは、この問題を「試す候補と、試す予算の配り方」から考える研究です。実行結果から複数のスキルを育てつつ、有望な候補と、まだ十分に試されていない候補に評価を振り分けます。著者らの実験では、比較手法のSkillOptに対して、最適化の費用試算を約55〜58%抑えながら、3モデルすべてで6課題の平均スコアが上回りました。

ただし、これは日々のAI利用料金が半分になるという話ではありません。何に費用がかかり、どこまで試した結果なのかを分けると、この研究の使いどころが見えてきます。論文の結果と費用表
直す対象はモデル本体ではなく、再利用する手順書
ここでいうスキルは、作業の進め方を記したSKILL.mdのような文書です。過去の実行でうまくいった判断、間違えやすい条件、出力の整え方を、次の仕事にも使える形にまとめます。
たとえば表計算の編集なら、「計算結果を確認する」とだけ書くより、「変更した範囲を読み直し、参照式と対象外のセルを確認する」とした方が役立つかもしれません。これは仕組みを説明するための例で、論文がこの文面の効果を測ったわけではありません。
難しいのは、もっともらしい手順書が、実際に良い手順書とは限らないことです。候補を作るたびにエージェントを何十件も動かすと、評価自体が高くつきます。逆に、AIに文章だけを採点しても、実行時の失敗は見逃しかねません。
COBRA-Skillsは、候補を作るモデルと、その候補で仕事をするモデルの役割を分けます。手順書の良し悪しを決める根拠は、後者を実際に動かして得た成績です。作業用モデルの重みを追加学習する方式ではありません。ただし、候補の成績を予測する小さな別のモデルは学習します。論文2節・3節
「良さそう」と「まだ分からない」の両方に試す価値がある
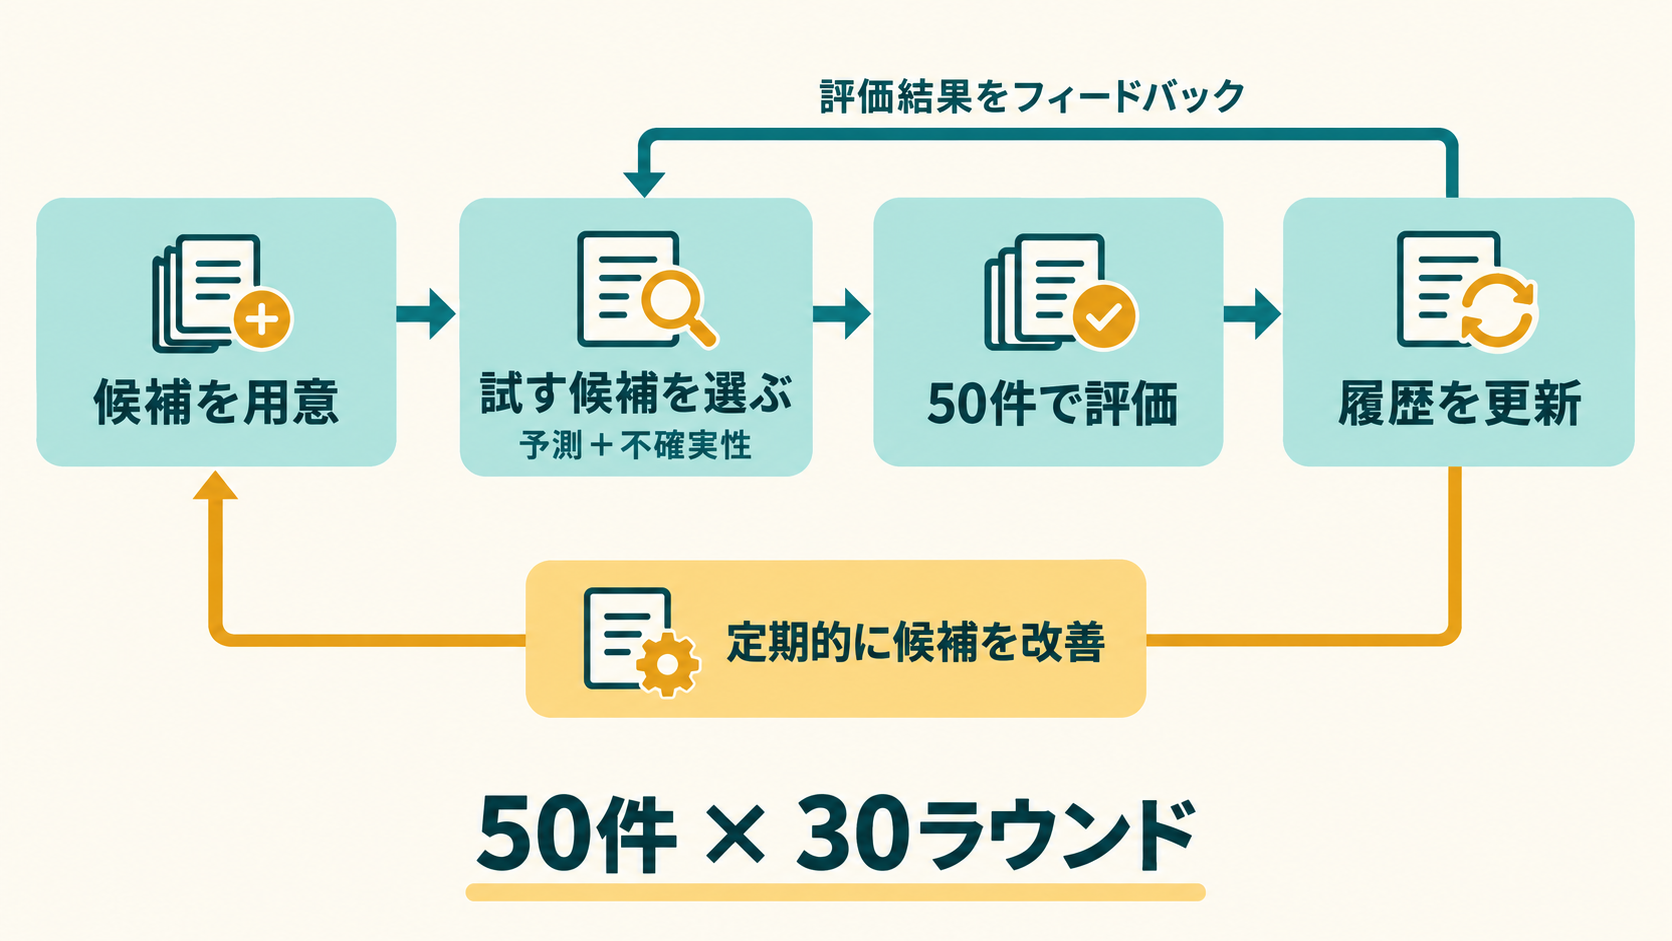
最初に、スキルなしで作業した記録から10個の候補を作ります。その後は、候補の文章を数値表現に変え、これまでの評価履歴から予想スコアを求めます。
予想スコアが一番高いものだけを試すと、序盤の偶然に引っ張られます。そこで、履歴から見てまだ十分に分かっていない候補にも、探索のための加点を与えます。「良さそうだから試す」と「判断材料が足りないから試す」を両立させる考え方です。論文では、小さなニューラルネットワークの予測とLinearUCBの不確実性ボーナスを組み合わせています。
選ばれた1候補を、最適化用の50件すべてで実行します。得られたスコアと実行記録を履歴に加え、次の候補選びに使います。この循環を30ラウンド続けます。最後に選ぶのは探索用の加点が大きい候補ではなく、評価履歴で平均成績が最も高かったスキルです。
ここは数字を読み違えやすいところです。「50件で最適化」は「50回動かせば終わる」ではありません。 オンラインの候補評価だけでも、50件×30ラウンドで1,500件分の実行になります。初期記録の収集や最終テストは別です。論文のアルゴリズムと付録A.1
候補は残すだけでなく、実行記録から育て直す
評価する候補を選ぶだけでは、最初の10個に良い手順書がなかったときに行き詰まります。そこで一定のタイミングで優先度の低い3候補を外し、新しい候補を加えます。毎ラウンド必ず書き直すわけではありません。
作り方は3種類あります。
- スキルなしの実行記録に戻り、別の方針で新しい候補を作る。
- 今試した候補の成功・失敗記録から、その候補を部分的に直す。
- 良かった候補を土台に、別の良い候補の工夫と、悪かった候補の教訓を取り込む。
3番目は、手順書を単純につなげる処理ではありません。使える部分を選び、失敗した方針を避けながら土台を修正します。評価履歴が十分に集まってから使う設計です。
また、生成指示には、評価用の答えや具体的な問題文、問題IDをスキルに埋め込まないよう制約があります。目指すのは答えの暗記帳ではなく、別の問題でも使える手順書です。ただし、指示があること自体が、漏えいを完全に防げる証明にはなりません。論文3.3節・付録C
実験で良くなったのは、6課題の平均スコア
評価対象は、質問応答、表計算、文書画像の理解、数学、役割推理、仮想環境での行動という6種類です。各課題の最終テストは100件で、結果は3回の独立実行の平均として報告されています。
以下は、論文の表1から抜き出した6課題の平均値です。順番は「スキルなし → SkillOpt → COBRA-Skills」です。
- Qwen3.6-35B-A3B:60.4 → 69.6 → 73.5
- GPT-5.4-Nano:30.0 → 53.7 → 56.9
- Gemma4-26B-A4B-it:46.4 → 67.6 → 68.9
役割推理のSocialMazeは部分点を含むため、これらをあらゆる作業に共通する成功率として扱うのは不適切です。あくまで、この6課題の平均スコアです。手順書を作る教師役はGPT-5.5のmedium設定で、作業する3モデルでは明示的な推論・thinkingを無効にしています。
さらに、平均で勝っていても、個別の課題すべてで勝つわけではありません。QwenのSearchQAでは、COBRA-Skillsが84.3、SkillOptが86.3です。GPT-5.4-NanoのLiveMathでも、47.7対48.7で下回ります。「スキルを最適化すれば、どの仕事も良くなる」とは読めません。実験条件と表1
費用が減った理由と、減ったとは言えない費用
表2の最適化費用は、入力・出力トークンに固定の単価を掛けた試算です。Qwenを作業役にした比較では、SkillOptの121.02ドルに対してCOBRA-Skillsは54.10ドルでした。ほかの2モデルを含めた削減率を表の値から計算すると、約55.3%、56.2%、57.7%になります。
大きく減ったのは、手順書を作り直す教師役のトークンです。Qwenの比較では15.16百万から3.00百万へ減っています。一方、作業役のトークンは93.77百万から115.92百万へ増えました。「評価も生成もすべて少なくなった」のではなく、費用の内訳が変わっています。
この数字は、現在の請求単価でも、導入後の月額費用でもありません。実行環境の運用や準備を含めた総費用を保証するものでもありません。また、比較手法は課題ごとに53〜170件の最適化用データを使い、COBRA-Skillsは50件です。同じテストでの比較ですが、最適化データ量まで完全にそろえた条件ではありません。表2・付録A.2・付録B.1
自分の仕事に持ち帰るなら、まず「評価用の仕事」を分ける
AICompanyとして役立つと考えるのは、毎回その場の印象でスキルを書き換える習慣を、記録に基づく比較へ変えることです。次は論文の再現手順ではなく、考え方を小さく試すための案です。
たとえば、記事の出典確認を手伝うスキルを改善するとします。「一次資料を探す」「日付を確認する」「数値の条件を読む」という同じ目的に対して、短い手順書を複数用意します。調整に使う記事例と、最後にだけ試す記事例は先に分けておきます。
評価では、文章の印象よりも「根拠のあるURLに到達したか」「対象期間を間違えなかったか」「数値の母数と条件を記録したか」を見ます。失敗があったら、その問題の正解そのものを追加せず、見落としを防ぐ一般的な手順を修正します。最後に残しておいた例で比べ、改善が移るかを確認します。
候補Aが10件中8件、候補Bが10件中7件できたとしても、それだけでAを固定するのは早計です。これは仮の数字ですが、どの種類の仕事で落ちたか、もう一度実行しても傾向が続くかまで見る必要があります。COBRA-Skillsの探索ボーナスをそのまま実装しなくても、「良い候補を使うこと」と「判断がつかない候補を確かめること」を分ける発想は持ち帰れます。
公開コードはある。ただし、万能な自動改善ではない
公式リポジトリには6課題の実行部品、データ分割の一覧、最適化処理が公開されています。コードはApache-2.0ですが、元データにはそれぞれの利用条件があり、すべてが同梱されているわけではありません。特にLiveMathは、READMEで元データの準備と再配布条件への注意が説明されています。
今回、AICompanyが確認したのは論文、公開コードの構造と一部処理、実験条件、表の数値です。モデルを動かして全実験を再現したわけではありません。
論文にはCodexとClaude Codeを実行基盤にした追加実験もありますが、そこで動かすモデルはQwen3.6-35B-A3Bです。普段使っているCodexやClaudeのモデルで同じ改善が起きると保証する結果ではありません。追加実験の表3
限られた最適化用データを繰り返し使えば、その範囲に合わせ過ぎる可能性もあります。評価の採点方法がずれていれば、育つスキルもそのずれに合わせてしまいます。候補を上手に探す仕組みと、仕事の良し悪しを正しく測る仕組みは、両方必要です。
COBRA-Skillsが示すのは、長い手順書を作る競争よりも、実行して確かめる予算の使い方に改善の余地があるということです。スキルを一つ書き直す前に、何をもって良くなったと判断するかを決める。その順番からなら、日々の作業にも取り入れられます。
原論文:COBRA-Skills: Contextual Bandit-Guided Evolution for Agent Skill Optimization、Pingchen Luほか、2026年9月10日投稿。