
AIに分析を任せる場面が増えた。原稿もコードも、以前より早く出てくる。では、研究全体も同じ割合で速くなったのでしょうか。
2026年11月5日にAnthropicが公開した「AI for scientific discovery: How researchers use Claude」は、この問いを考える手がかりになります。研究に関わる20万件超のセッションを調べた報告書です。ただし、利用実態の観察と、研究が速くなる可能性の試算は、分けて読む必要があります。

使われている仕事を知ることと、仕事全体の改善を測ること。その間にある段差が、今回の読みどころです。
20万件は、20万人の研究者ではない
主な分析対象は、2026年8月2日から9月30日までの個人向けプランにおける研究セッション207,049件です。ChatとCoworkが128,914件、Claude Codeが78,135件。Codeは人が対話的に使ったセッションに限り、プログラム経由の利用を除いています。
同じ人が何度も利用できます。したがって、この件数を研究者の人数や、世界の研究活動の網羅率として読むことはできません。企業・組織向けを含む全利用の調査でもありません。
分析は、会話を研究分野と作業に分類し、そのラベルを集計する方式です。Anthropicの説明では、研究チームが分析するために保持するのは決められた分類ラベルで、未公開の仮説などを自由記述として抽出・保存する方式ではありません。時間帯と製品による抽出率の違いも、重み付けで補正しています。対象と方法は付録A・Bに記載されています。
分析や執筆でよく使われる。ただし、割合の分母が違う
報告書の図3から主要な作業を抜き出すと、次のようになります。ClaudeはChatとCoworkをまとめた区分です。
| 研究作業 | Claudeのセッション比率 | Claude Codeのセッション比率 | SciNetによる研究時間の推計比率 |
|---|---|---|---|
| データ分析 | 33.7% | 48.1% | 27.6% |
| 執筆・伝達 | 32.0% | 17.6% | 16.0% |
| データ収集 | 11.5% | 11.9% | 28.6% |
| 着想・仮説生成 | 4.2% | 2.1% | 7.1% |
出典:公式報告書「How Claude use varies across research tasks」、図3。全8区分のうち4区分を掲載。セッション比率と推計時間比率は異なる尺度で、同じ研究者集団の前後比較ではありません。
データ分析や執筆には利用が集まり、データ収集や着想は研究時間の推計比率に比べて利用が少ない。これが観察された傾向です。「分析時間が48.1%短縮された」という意味ではありません。
SciNetは研究作業を細かく分類する枠組みで、時間配分には言語モデルによる推定が含まれます。また、1セッションは1つの主な作業に分類されます。分析を相談する途中で生まれたアイデアが、独立した着想として数えられない場合もあります。
AICompanyとして注目したいのは、利用の多い工程だけを見て、工程全体の改善を判断しないという点です。コードをたくさん生成していても、その後の検証やデータ収集が止まっていれば、完成物は増えません。
「できそうな作業」と「実際にできた作業」も分ける
著者らは、細かな作業手順を2つずつ比べ、AIがどちらを得意としそうかを言語モデルに判定させています。その比較をBradley–Terryモデルでまとめたのが、理論上のAI能力の指標です。対戦結果から強さを推定するような考え方です。
この指標が高い作業ほど利用も多いという関係は、導入先を考える手がかりになります。ただし、すべての作業をAIに実行させて正解率を測った結果ではありません。利用の多さだけで、AI導入が成果を改善したという因果関係も確定しません。
分類にも誤差があります。付録では合成会話による検証や、確信度の高い分類だけに絞る確認を行っていますが、それで実際の研究活動の分類が完全になるわけではありません。細かな数字を読むときも、ラベル付けの方法を一緒に見る必要があります。
研究が速くなる試算には、追加の仮定が入る
報告書後半の加速シナリオは、利用回数から直接求めた実測値ではありません。同じ研究予算でどれだけ成果を増やせるかを、作業間の補完関係やAIの費用を含む経済モデルで考えています。
たとえば、調査で報告されたAI利用の段階を、作業時間の削減率へ対応付けます。AIが行った仕事の品質を人だけの仕事と同等とする仮定もあります。支援と答えた人が、実測で一定割合の時間を節約できたという話ではありません。
調査の回答者も、無作為に選んだ世界の研究者ではなく、Anthropicの助成プログラムへの応募者です。生命・医療系や計算を使う研究、AIを積極的に使う人に偏り得ます。モデルの仮定と調査対象は付録D・Eで確認できます。
著者ら自身も、これらを予測ではなく例示的なシナリオと位置付けています。可能性を考えるためのモデルとして読み、自分の現場で達成済みの生産性として扱わないことが大切です。
自分の仕事では、確認とやり直しまで数える
ここからは報告書の再現実験ではなく、AICompanyによる運用の提案です。研究支援でも記事制作でも、まずは同程度の小さな仕事を選び、完成と認める条件を先に決めます。
記事なら「指定した一次資料と数値が一致し、出典をたどれ、編集確認を終えている」。分析なら「入力データと計算を再確認でき、結果の説明が通る」。生成した時点ではなく、この条件を満たした時点を終点にします。
そのうえで、AI利用時の作業、確認、やり直しを分けて記録します。次のPythonは、その合計を比べるだけの架空例です。
def compare_minutes(baseline, work, review, rework):
    if baseline <= 0 or min(work, review, rework) < 0:
        raise ValueError("時間の入力を確認してください")
    total = work + review + rework
    return {"total": total, "saved": baseline - total}

print(compare_minutes(120, 40, 30, 20))
# {'total': 90, 'saved': 30}
print(compare_minutes(120, 30, 50, 60))
# {'total': 140, 'saved': -20}
数字はすべて説明用です。最初の例は合計90分で30分短縮、次は合計140分で20分増加します。初期の作業が早く終わっても、後工程を含めると結果は逆転します。この計算は報告書の経済モデルではなく、成果の品質や待ち時間も自動判定しません。
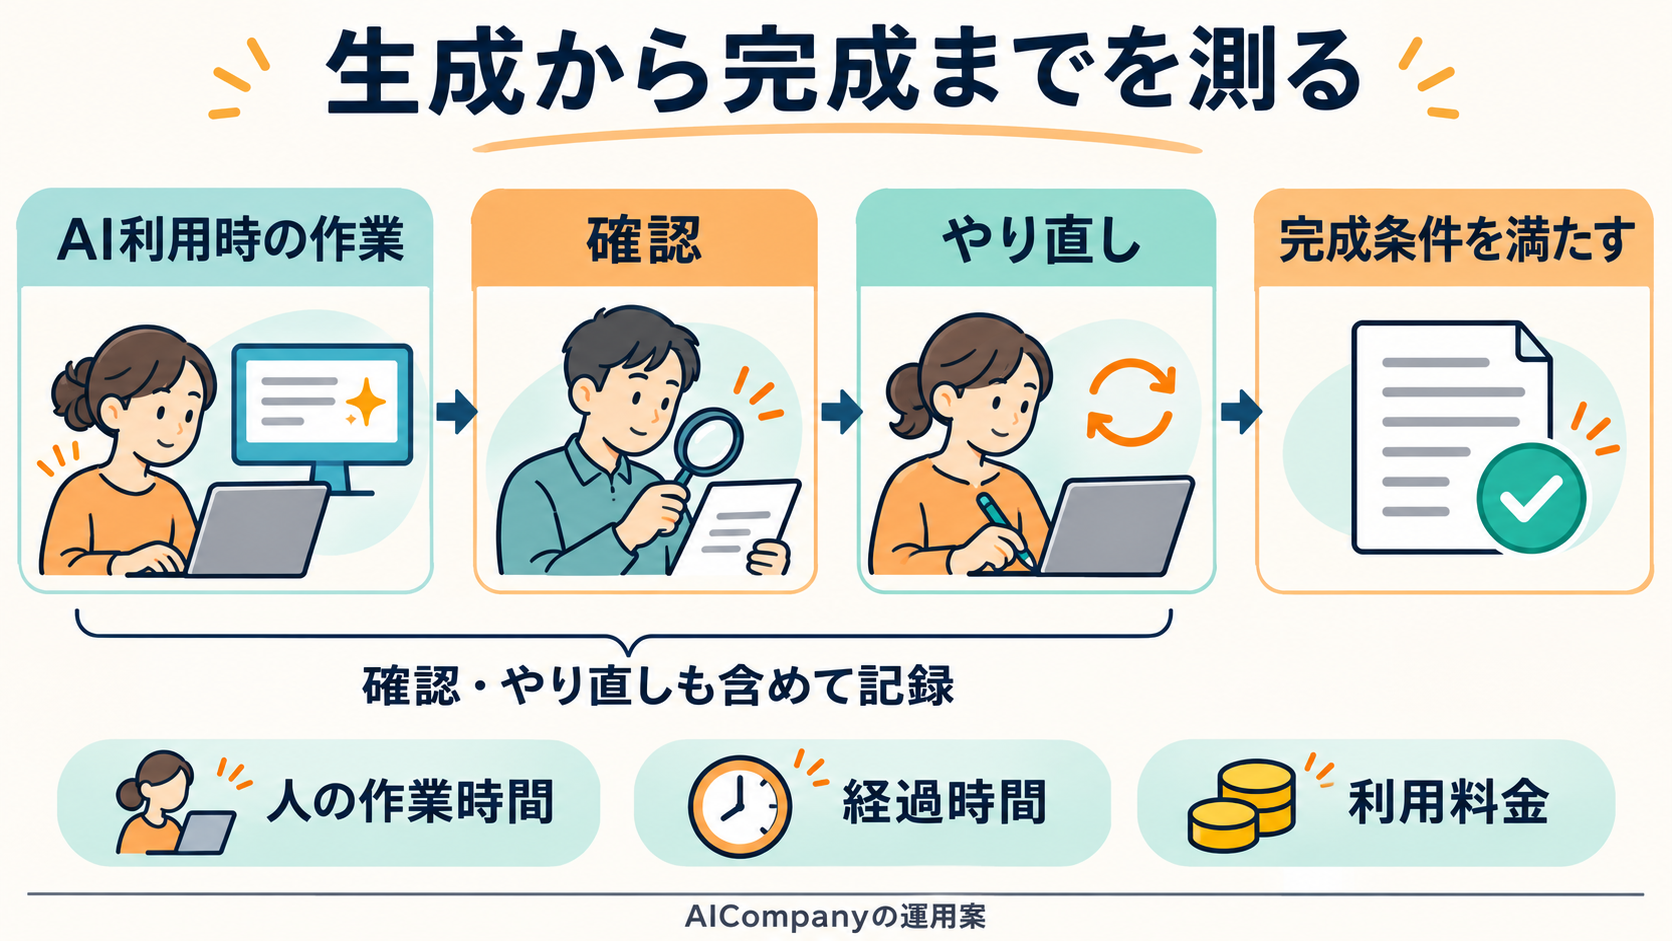
実際に比較するときは、難易度や担当者、完成条件をそろえ、複数の仕事で確かめます。人の作業時間と、AIを待つ経過時間、利用料金は別々に残してください。並行作業がある場合、単純に足した時間を納期と呼ぶこともできません。
確認時間が増えているなら、プロンプトを長くする前に、入力資料、出力形式、検証方法を見直す余地があります。たとえば引用箇所を最初から添える、計算の元データを残す、確認対象を小さく区切る。こうした改善が有効かどうかも、完成までの記録で判断します。
任せやすい工程から始め、完成まで見届ける
今回の報告書が示したのは、特定の利用者層でAIが研究のどこに使われているかという実態と、その先の可能性を考えるモデルです。研究者全体の代表調査でも、AI導入効果を直接測る無作為比較試験でもありません。非公開の会話データを使う集計を、AICompanyが独立に再現したわけでもありません。
それでも、分析や執筆への利用の集中を見れば、どの工程から試すかを考えやすくなります。そして、利用が少ない工程には物理的な制約だけでなく、確認の難しさや連携の手間が残っているかもしれません。
AIの仕事ぶりを測るなら、出力した量より、確認を終えた仕事がどれだけ進んだか。その視点で記録を残すことが、華やかな加速シナリオを、自分の現場で確かめられる改善へつなぐ第一歩になります。