
AIに渡す文章を短くすれば、料金も下がる。長く動くコード修正エージェントなら、そう考えたくなります。ところが、古い履歴を削った結果、読み直しが増え、安く再利用できた入力まで通常料金に戻ることがあります。
10月26日公開の論文「The Hidden Costs of Forgetting」は、この問題を9,400回の実行で調べています。注目したいのは、単に「削ると失敗する」という話ではありません。課題を解けた割合が大きく変わらない設定でも、裏側の作業や費用が増えていました。

ただし、ここで扱う費用は、実際のAPI請求書ではなく、実行ログに料金条件を当てはめた推計です。この区別を押さえると、何が分かり、何を自分の環境で測るべきかが見えてきます。
履歴は、使い終わったゴミとは限らない
コード修正エージェントは、ファイルを読み、修正し、テストして、次の行動を考えます。次のモデル呼び出しには、それまでの推論文、ツール呼び出し、ツールの出力などが履歴として渡されます。
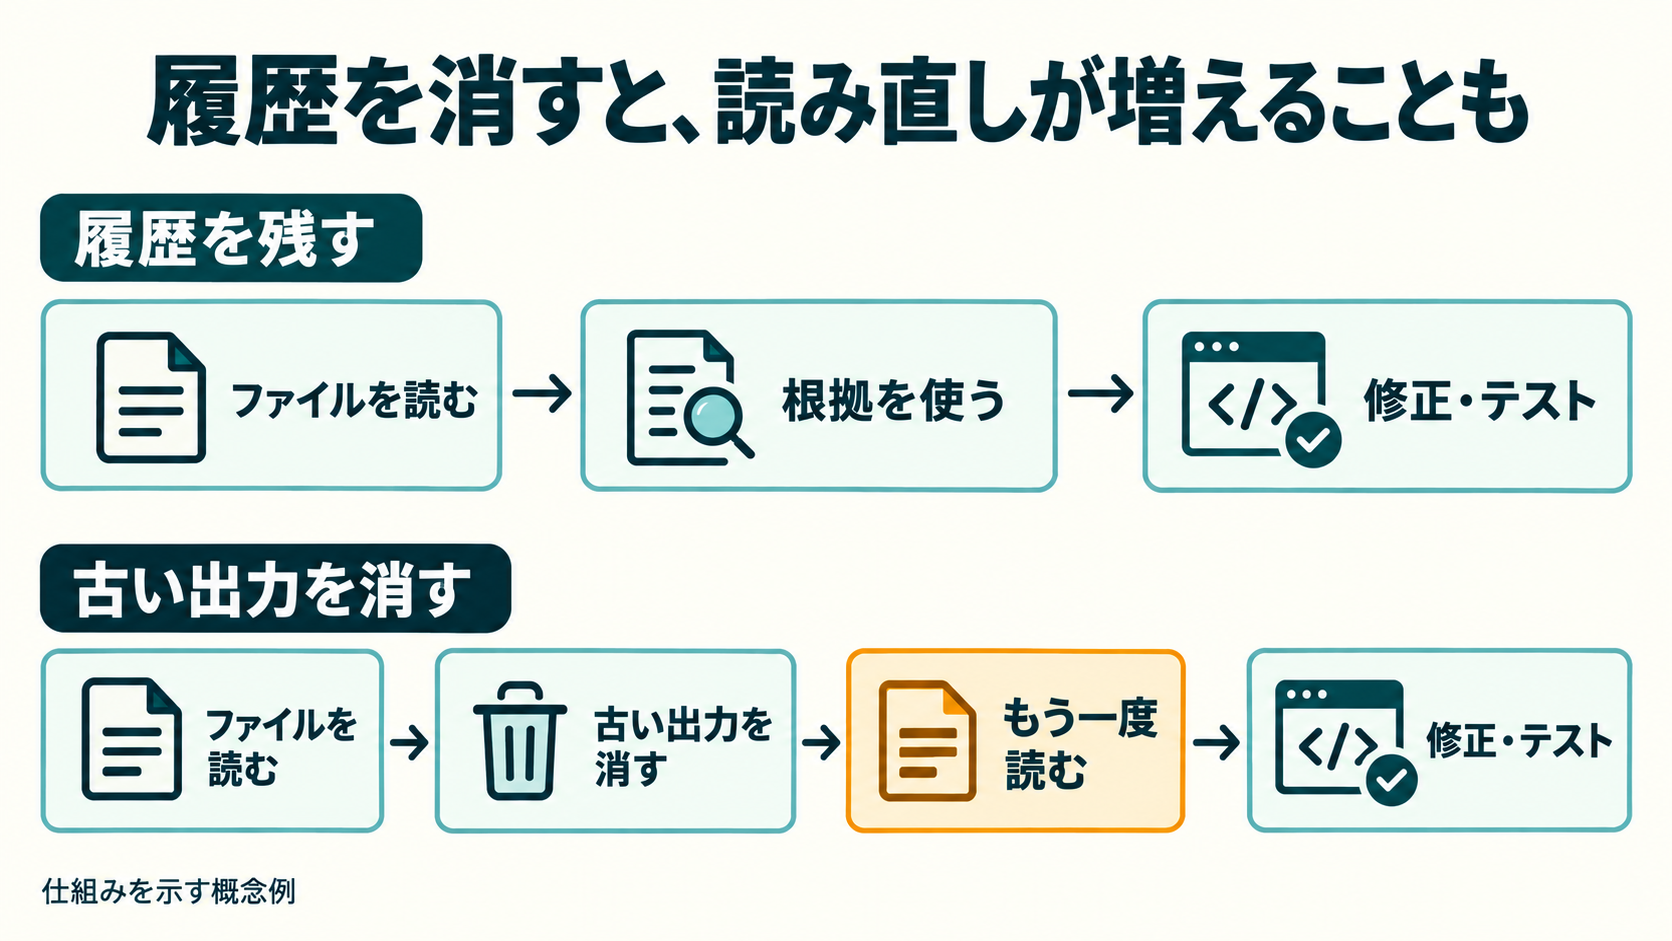
積み重なる履歴を減らせば、コンテキストの容量には余裕ができます。一方で、さっき見た関数の中身やエラーログも一緒に消してしまうかもしれません。必要になれば、エージェントはまたファイルを開きます。「忘れたので、もう一度お願いします」が機械の中でも起きるわけです。
この研究の新しさは、トークン削減と費用削減の違いを初めて指摘したことではありません。削る対象、粒度、量、タイミングを分け、消した情報の再取得と、入力キャッシュの失効を合わせて追った点にあります。
42の削除設定を、二つのエージェントで比較
研究チームは、Mini-SWE-agentとTrae agentを使い、SWE-bench Verifiedの固定100課題で実験しました。二つのエージェントが使うモデルは、どちらもDeepSeek-V4-Flashです。複数モデルの比較ではありません。
削除対象は、推論文、ツール出力、両方とツール呼び出しを含むターン全体の3種類。ターン単位で確率的に消す方法と、対象内のトークンをランダムに抜く方法を比べます。削除率とタイミングを組み合わせ、42設定を作りました。
タイミングは二通りです。一つは直近2ターンを残す遅延削除。もう一つは、次の呼び出しの前に直前の内容も削除対象にする即時削除です。後者でツール出力を全部消すと、モデルはその出力を一度も完全な形で見られません。
42設定を二つのエージェントで試すので、介入条件は計84評価です。遅延削除だけ、または即時削除だけを見ると、それぞれ42評価になります。各100課題の8,400実行と、削除しない基準条件を各エージェント5回ずつ実施した1,000実行を合わせて、計9,400実行です。
解けたからといって、無駄がなかったとは言えない
遅延削除では、42評価中37評価で、解けた課題数の統計的に有意な減少は見つかりませんでした。ただし、これは「性能が同じだと証明した」という意味ではありません。差を検出できなかったことと、同等性の確認は別です。
しかも、21評価では実行ターン数が有意に増えていました。いずれもツール出力を削る設定です。削った内容を再取得する動きがあり、最終的に直せたかどうかだけでは、途中の遠回りを捉えきれません。
例えばTrae agentで、2ターン待ってから古いツール出力をすべて消す設定では、解けた課題は100件中70件でした。削除しない基準の平均は74.6件で、この減少は有意とは判定されていません。一方、実行ターン数の中央値は73%増えています。ゴールに着いたことと、同じ労力で着いたことは違います。
研究では、ファイル読込の出力が以前の読込とどれだけ重なるかを使って、再取得を判定しています。削らずに残した出力の再取得はおおむね基準並みで、余分な読込は削った内容に集中していました。とはいえ、この判定は行の重なりに基づくため、別の形に変換された同じ情報まで完全に捉えるものではありません。
短くした入力が、なぜ高くなるのか
もう一つの理由が、入力の先頭から同じ並びを再利用するプレフィックスキャッシュです。履歴を末尾に足すだけなら、それまでと一致する先頭部分を割引価格で扱える条件があります。
古い履歴の途中を書き換えると、最初に変わった位置から後ろは、以前と同じキャッシュとして使えなくなります。後ろの文章自体を残していても、その前提となる並びが変わっているからです。
論文は、通常入力、キャッシュ入力、出力の価格比を「1:0.1:5」として計算しました。キャッシュ可能な先頭部分は必ず再利用できると仮定しています。これは研究上の条件で、特定サービスの現在の料金表ではありません。
| 遅延削除の42評価 | 入力を一律料金で計算 | キャッシュ割引を含めて計算 |
|---|---|---|
| 推計費用が基準を下回った評価 | 26評価 | 0評価 |
| 統計的に有意に安くなった評価 | 6評価 | 0評価 |
| 統計的に有意に高くなった評価 | 3評価 | 26評価 |
数値は論文の表IIと第VI節に基づきます。AICompanyでも公開表の費用比を再集計し、一律料金で26評価、キャッシュ込みで0評価が基準未満になることを確認しました。元の9,400実行を再現した検証ではありません。
具体例では、Mini-SWE-agentで古いツール出力をすべて削る遅延設定は、一律料金なら基準の0.71倍、キャッシュ込みなら1.20倍でした。同じ実行ログでも、料金の扱いで「29%安い」が「20%高い」に変わります。
架空の入力で、割引の消失を確かめる
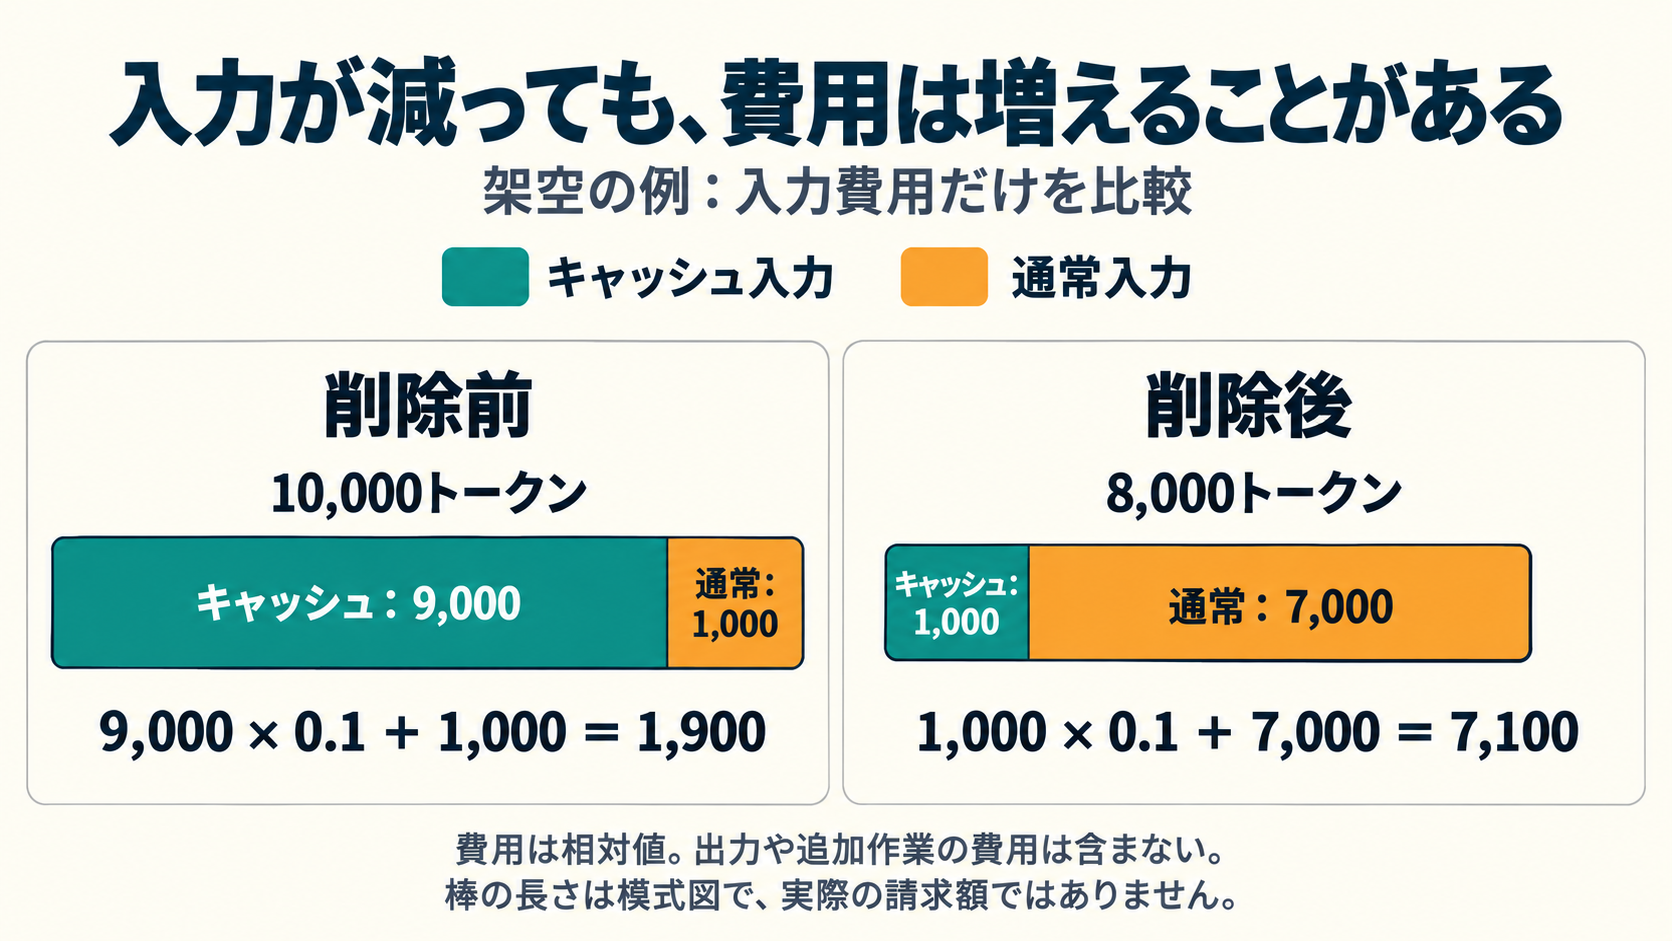
仕組みだけなら、小さな計算で確認できます。次は論文の測定値ではなく、AICompanyが作った架空の例です。出力や再読込の増加は省き、1回の入力費用だけを比べます。
削除前は、入力10,000トークンのうち9,000がキャッシュ扱い、1,000が通常扱いとします。削除後は入力が8,000に減るものの、キャッシュ扱いは1,000、通常扱いは7,000になったと仮定します。
def input_cost(cached, uncached):
    return cached * 0.1 + uncached

before = input_cost(9000, 1000)
after = input_cost(1000, 7000)
print(before, after)  # 1900.0 7100.0
入力トークンは20%減りましたが、入力費用の指標は1,900から7,100へ増えます。単位は架空で、円やドルではありません。どの位置をどれだけ書き換えたかでキャッシュ部分が変わるため、実環境でこの増え方になると予測する例でもありません。
この計算が示すのは、「少ない入力」だけから「安い入力」は導けない、ということです。実際の総費用を比べるには、出力、再読込、圧縮処理そのものの費用も必要になります。
自分のエージェントでは、何を記録するとよいか
ここからはAICompanyの運用案です。履歴削減を試すなら、削除しない条件を基準にして、同じ課題群で比較すると判断しやすくなります。
記録したいのは、解けた課題数、途中で予算に達した件数、ターン数、再読込、通常入力とキャッシュ入力、出力、そして最終的な請求額です。要約モデルを使う場合は、その呼び出しも含めます。費用が低くても、早く諦めて課題を解けなくなっただけなら、望んだ節約とは言いにくいでしょう。
また、古い推論文と、今まさに使うファイル内容を同じ扱いにしない設計は、試す価値があります。ただし、この論文は最適な保持期間を決めていません。「直近2ターンを残せば十分」と、そのまま運用ルールにすることはできません。
この結果を、すべての圧縮に広げない
実験は一つのモデル、二つのエージェント、公開されたPythonリポジトリの100課題に限られます。介入条件は課題ごとに1回で、削る箇所の乱数も一通りです。温度ゼロでも実行は完全には再現せず、統計区間は介入の反復によるばらつきまで含みません。多数の比較への補正では、有意な個別結果も減ります。
推論文だけを削る設定は、ツール出力を削る設定より削除トークン数が少ないため、内容の種類と量の影響も完全には分かれていません。公開された修正例をモデルが知っている可能性や、テスト通過が修正の完全な正しさを保証しない点も残ります。
費用はGH200を使った自前推論のログから推計したもので、従量APIの実支払いではありません。キャッシュの書込追加料金、最低長、期限切れや追い出しなどは省略しています。省略の影響は基準条件と削除条件で等しいとは限らず、どの提供元でも同じ比率になるとは言えません。
さらに、対象はランダム削除です。学習した重要度選択、要約、書換えを間引く方式まで実証した研究ではありません。著者が示す再現パッケージのリンクは、今回の取得では内容を確認できず、AICompanyは元ログの再分析やモデル実行を行っていません。
この論文から持ち帰りたいのは、履歴を長く残すこと自体が正解だという結論ではなく、忘れた後の仕事も数えるという視点です。削除量と正答数に加えて、取り直した情報と失った割引を見る。そこで初めて、自分の環境での節約を確かめられます。
出典
論文:The Hidden Costs of Forgetting, arXiv:2610.35496v1。Fernando Vallecillos-Ruiz、Islem Bouzenia、Michael Pradel、Leon Moonen。2026年10月26日公開。実験条件は第III節、課題とターン数は表I、再取得と費用比は表II、限界は第VII節を参照。
論文の全文HTML。掲載図は転載せず、仕組みをAICompanyが独自に図解しました。表の再集計と架空例の計算は、元実験の再現や特定サービスの請求額検証を意味しません。