
AIが資料を何度も探し直しているとき、足りないのは考える力でしょうか。それとも、最初に渡した資料の質でしょうか。
NVIDIAが10月21日に公開したNemotron 3.5の技術報告は、後者を考える材料になります。同じエージェントの検索部分を変更した比較で、検索結果を並べ替えるモデルを加えると、エージェントが使うトークン量が約13〜14%減ったと報告しています。

ただし、これを「AIの総費用が13〜14%安くなる」と読むのは早計です。並べ替え自体にも計算が必要だからです。今回の面白さは、検索と推論を別々に最適化するだけでなく、両者のつながりを測ろうとしている点にあります。
資料は多ければよい、とは限らない
たとえば、社内のPDFを調べるAIに「来期、在庫切れしそうな商品はどれか」と頼んだとします。必要なのは商品名を含む文書だけではありません。需要予測のグラフ、在庫の表、仕入れ先の納期を、対応する商品と期間をそろえて読む必要があります。
似た言葉の資料が大量に届いても、肝心の表が抜けていれば答えは出ません。別の検索を試し、資料を開き、不要な文章を読み、また探す。この往復で、最初から必要な根拠がそろう場合よりもトークンを消費し得ます。
そこで登場するのが、検索後の「再順位付け」です。英語ではrerankingと呼びます。最初の検索で候補を広く集め、その候補が質問にどれだけ直接答えるかを、別のモデルで詳しく比べ直します。
検索窓の向こうに、資料を選ぶ編集者がもう一人いる。そんなイメージです。ただし、その編集者にも仕事代はかかります。
Parse、Embed、Rerankは、それぞれ何をするのか
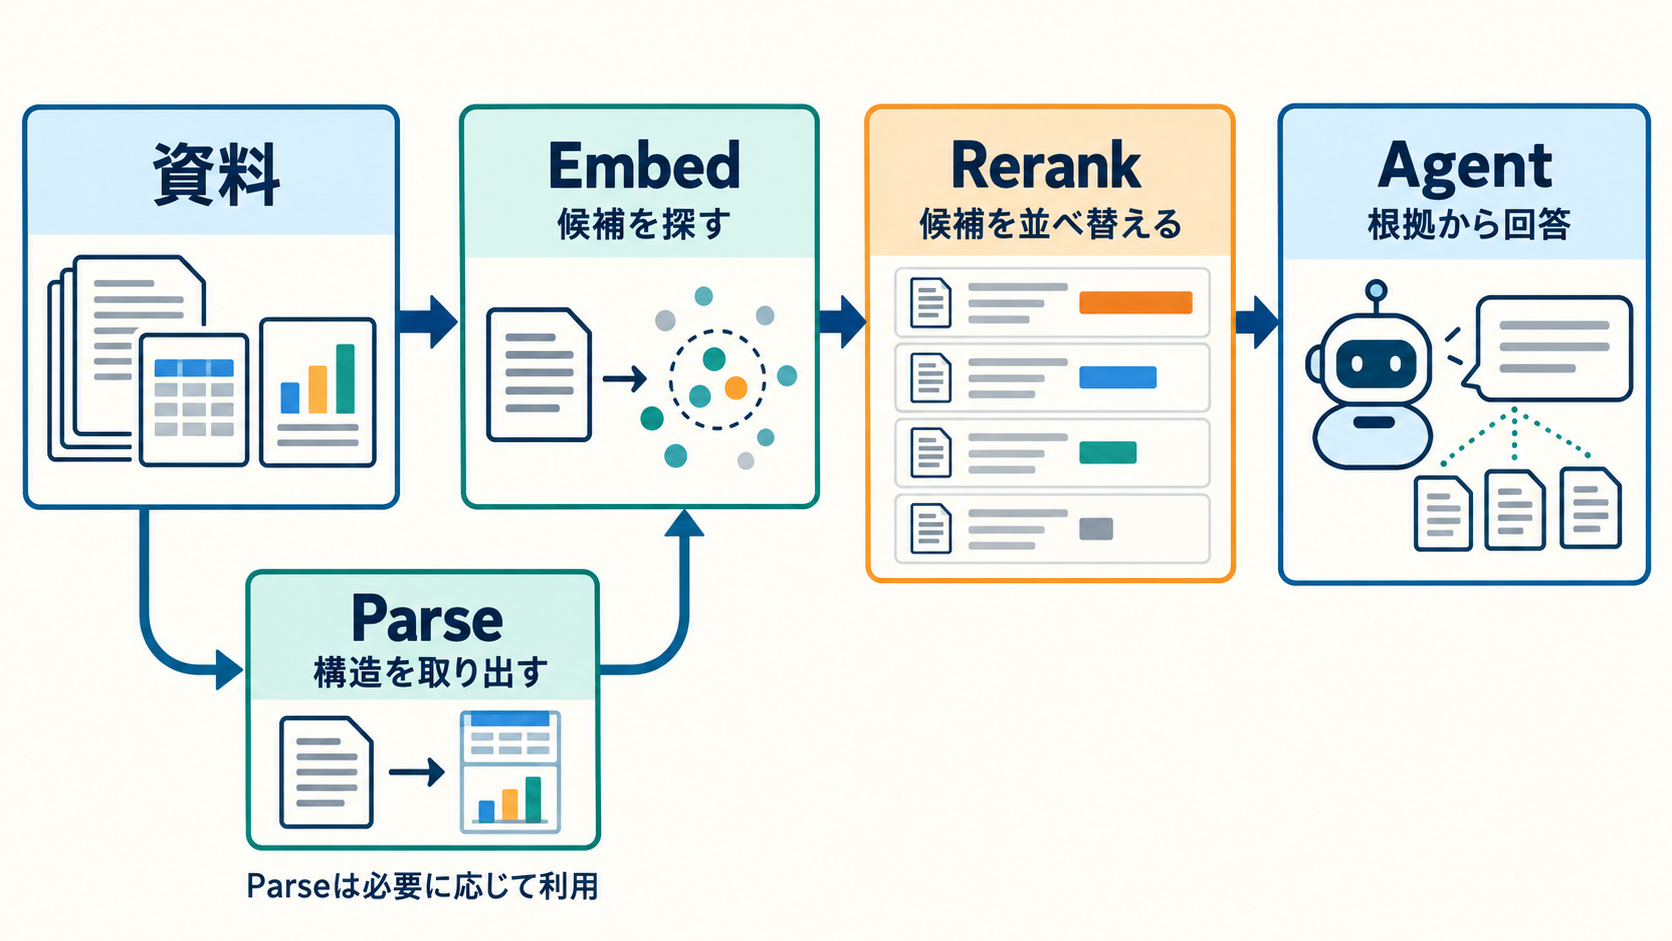
今回の発表には、文書の読み取り、検索、並べ替えを担うモデルが含まれます。ひとつの巨大なモデルですべてを処理するという話ではありません。
Parseは、文書画像を扱いやすい形にする役割です。 文字だけでなく、読む順序、表、図の情報を、MarkdownやHTMLの表などの構造に取り出します。元の資料の見出しや列との対応が失われると、後段で正しく検索できても意味を取り違えるためです。
Embedは、資料を探すための表現を作ります。 質問や文書をベクトルという数値のまとまりにし、近い表現の資料を候補として集めます。Nemotron 3.5 Embedは文章に加え、表やグラフを含むページ画像も対象にします。質問はテキスト、資料側はテキスト、画像、または両方を入力できます。
Rerankは、候補を質問と組み合わせて読み直します。 質問と文書を一緒に処理し、関連度の得点を出します。単に同じ話題かどうかだけでなく、答えの根拠として役立つ候補を前に出すことが狙いです。
Parseで構造を取り出す経路と、ページ画像を直接Embedに渡す経路は、資料や目的に応じて使い分けるものです。三つを必ず直列につなぐ必要はありません。また、Rerankは検索候補を並べ替えるので、候補に一度も入らなかった重要ページを、それだけで救い上げられるわけではありません。
約13〜14%減ったのは、何の量か
NVIDIAの報告では、エージェントのLLM、ツール、課題、文書集合、実行方針を固定し、検索の構成を変えています。対象には、画像と文章を扱うViDoRe v3と、文章を扱うBRIGHT、BrowseComp-Plusが含まれます。
エージェントは検索し、根拠を確認し、必要に応じて検索を修正します。計測するトークン量は、この一連のやり取りでエージェントが使った入力と出力の合計です。
報告された約14%の削減はEmbed 8BにRerankを追加した場合、約13%はEmbed 1Bに追加した場合です。いずれも検索精度が改善したとされています。ただし、この数字から検索回数が同じ割合だけ減ったとは言えませんし、すべての質問で同じ効果が出るとも言えません。
| 比較した構成 | NVIDIAが報告した変化 | この数字だけでは分からないこと |
|---|---|---|
| Embed 8BにRerankを追加 | エージェントのトークン量が約14%減少 | 総費用、待ち時間、質問ごとのばらつき |
| Embed 1BにRerankを追加 | エージェントのトークン量が約13%減少 | 並べ替えの計算資源を含めた収支 |
出典は公式記事の「Better Retrieval for More Efficient Agents」です。これは提供元による評価で、AICompanyがモデルを動かして再現した結果ではありません。
さらに、検索順位の評価と、最後の回答の正しさは別の指標です。資料の上位に正解の根拠が来やすくなっても、エージェントが読み違える可能性は残ります。導入判断では、検索の点数だけでなく、根拠に忠実な最終回答が出たかまで見る必要があります。
小型版でも、並べ替えまで小さいとは限らない
今回のEmbedには、8B版と1B版などがあります。ただし「1B」は製品名の区分で、1B BF16版のモデルカードに記載された実際のパラメータ数は約15.5億です。Rerank 8B BF16は約83.8億です。
つまり、Embed 1Bを使う構成にRerankを追加する場合も、約83.8億パラメータの並べ替えモデルを動かす資源が別途必要です。「小型の検索モデルだから、全体も軽い」とは判断できません。
Embed 1Bの出力は標準で2,048次元のベクトルで、最大コンテキスト長は32,768トークンです。この上限には画像由来のトークンも含まれます。巨大なPDFをそのまま無制限に投入できる仕様ではなく、ページの分け方や画像解像度の調整が関わります。
日本語は、モデルカードにある文章検索34言語、画像検索18言語の評価対象に含まれます。とはいえ、日本語の縦書き、細かな注記、独自の帳票、読み取りにくいスキャンまで同じ品質になると保証するものではありません。
低精度版NVFP4の性能報告もありますが、処理速度の比較にはNVIDIA GB200という特定のハードウェア条件があります。その数字を手元のパソコンの速度に置き換えることはできません。
モデルの利用条件はOpenMDW 1.1です。元になったMinistralのライセンスと、公開されたモデルに適用される条件は分けて確認する必要があります。
13%の削減でも、総費用は増え得る
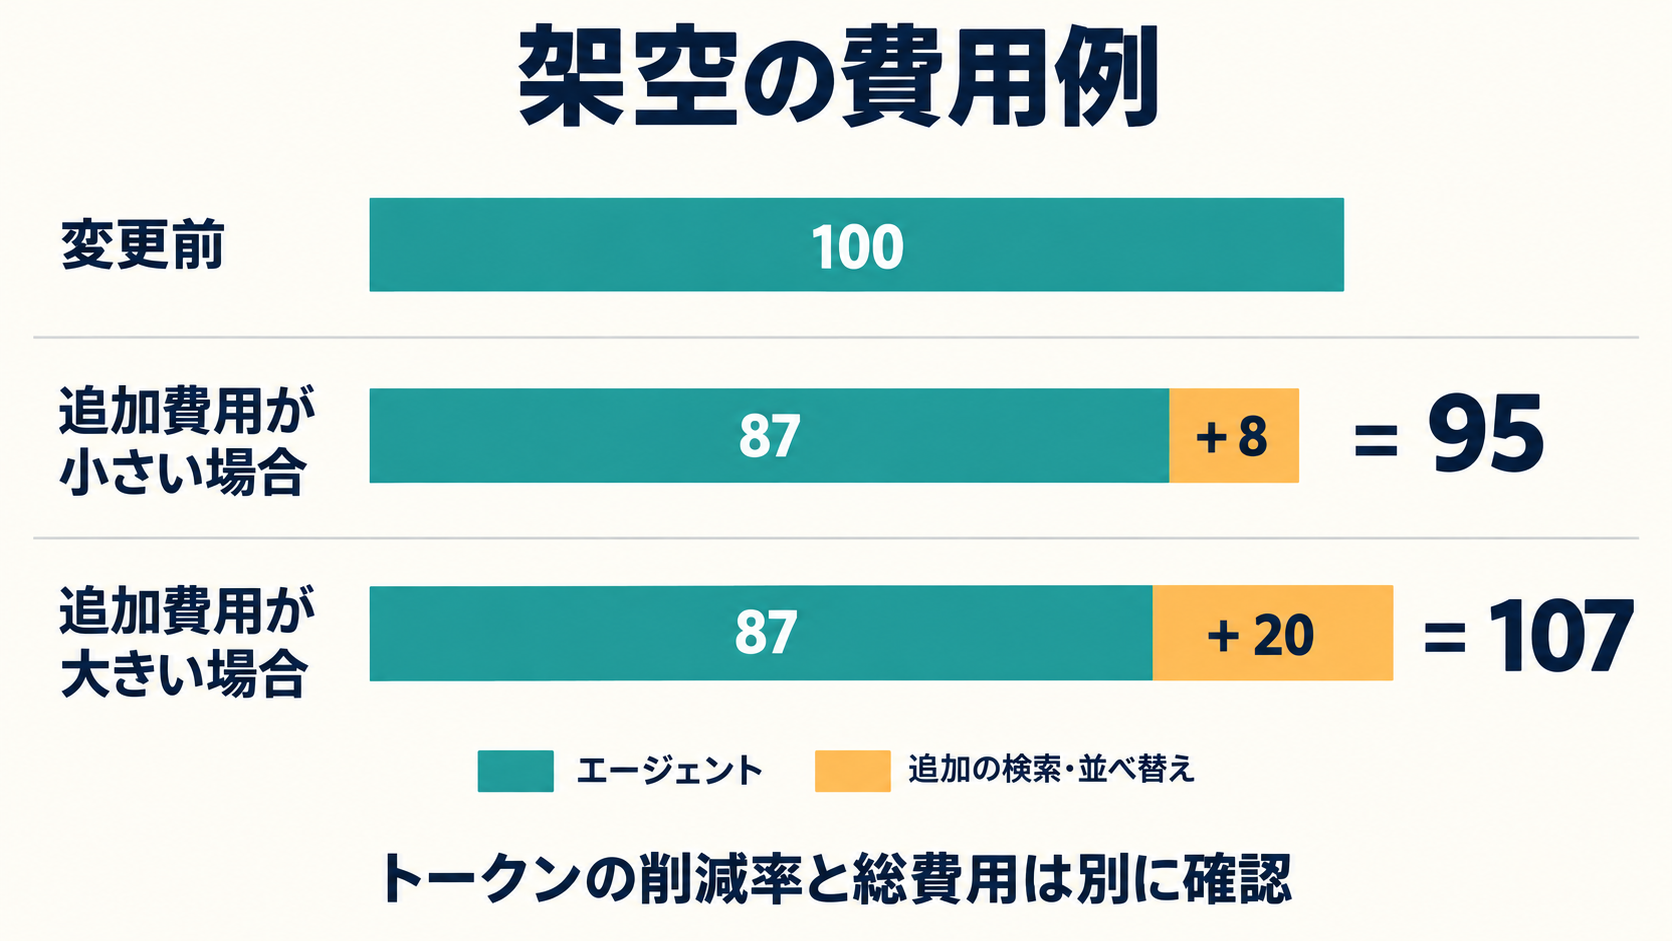
ここからはAICompanyの考え方を説明するための、架空の計算です。NVIDIAの費用実測値ではありません。
変更前のエージェント費用を100とし、仮にトークンの削減がそのままこの費用の13%削減になると置くと、変更後は87です。追加の検索・並べ替え費用が8なら合計95ですが、20なら合計107になります。既存の共通費用は比較から省いた単純化です。
def total_cost(agent_before, reduction, extra_retrieval):
    return agent_before * (1 - reduction) + extra_retrieval

print(total_cost(100, 0.13, 8))   # 95.0
print(total_cost(100, 0.13, 20))  # 107.0
この例で差し引きの損益が入れ替わるのは、追加費用が13のところです。実際には入力と出力の単価、キャッシュ、バッチ処理、GPUの稼働率、取り込み費用も変わります。トークン削減率を、そのまま請求額の削減率にはできません。
また、このコードは費用の足し算を確認するだけです。検索精度やモデル性能を検証するものではありません。
手元の資料で試すなら、何をそろえるか
この発表から実務へ持ち帰れるのは、「とりあえずRerankを足す」という結論より、比較の仕方です。
たとえば、論文や技術資料のライブラリなら、実際に答えを探したい質問と、その根拠になるページを先に用意します。文章だけで答えられる質問と、表やグラフが必要な質問を分けると、画像を扱う価値も見えやすくなります。
そのうえで同じ文書集合とエージェントを使い、検索のみの構成と、検索後に並べ替える構成を比較します。最初の候補に必要なページが入ったか、並べ替え後に上位へ来たか、最後の回答が根拠を正しく使ったかを順番に見ます。
一緒に記録したいのは、エージェントの入力・出力トークン、検索と並べ替えの処理量、待ち時間、文書取り込みの費用です。品質が下がったままトークンだけ減った構成を、改善とは呼べません。
ここでの試し方はAICompanyの応用案です。日本語資料で効果を確認した実験結果ではありません。特に元の図表の読み違いや、ページから出典へ戻る対応付けは、検索順位と別に確かめる必要があります。
考えるモデルの前に、渡す根拠を点検する
Nemotron 3.5の報告は、エージェントの負担を減らす場所が、推論モデルの内部だけではないことを示唆しています。必要な根拠を早く渡せれば、余計な読み直しや探索を減らせる可能性があります。
一方、並べ替えのモデルを追加すれば、処理も資源も増えます。約13〜14%という数字は、その追加分まで帳消しにする約束ではありません。
見るべきなのは、回答の質を保ちながら、資料の取り込みから最終回答までの負担がどう変わるかです。AIにもっと考えてもらう前に、渡している資料を点検する。その順番には、試す価値があります。
出典
- NVIDIA公式技術記事:Nemotron 3.5 Embed, Rerank, and Parse(2026年10月21日公開)
本記事は公開された技術記事とモデルカードに基づきます。AICompanyではモデル推論、検索ベンチマーク、実環境の速度・費用測定を実施していません。