
AIに同じ作業を頼んだのに、昨日できた確認を今日は忘れる。そんなとき、もっと賢いモデルへ交換する前に試せることがあります。過去の成功と失敗から「次に守る手順」を取り出し、作業前に読ませる方法です。
IBM Researchが10月20日に公開したALTK-Evolveの顧客対応実験は、その効き方と難しさを示しています。新しいのは手法そのものの初公開ではなく、小売と航空の対話型ベンチマークにおける評価報告です。コードや順位への提出は、それ以前から公開されていました。

読むべき点は「古いモデルが首位」という見出しだけではありません。経験から作った指針が、未使用課題での繰り返し成功にどう効き、指針を増やすと何を失うのか。そこを追うと、自分のAI作業へ持ち帰れる設計が見えてきます。
残すのは会話の全文ではなく、次に使える行動指針
顧客対応のAIは、答えを説明するだけでは済みません。本人を確認し、注文を探し、返品できる条件を確かめ、変更内容への同意を得てからツールを実行します。一つの確認漏れで、最後の状態が間違ってしまいます。
ALTK-Evolveは、訓練用課題の試行ログから短い行動指針を抽出し、まとめた手引きをエージェントのプロンプトへ追加します。モデルの重みを更新する仕組みではありません。顧客対応の例なら「注文に触れる前に本人確認する」「更新操作の前に変更内容をまとめ、明示的な同意を得る」といった指針です。
公開実装では、業務ポリシーの後ろへ箇条書きの指針を追加します。考える段階とツールで行動する段階を持つReActエージェントの、両方のプロンプトへ入れる構成です。一般的なALTK-Evolveライブラリの機能すべてを使う話ではなく、今回の評価では、この比較的単純な追加が中心になっています。
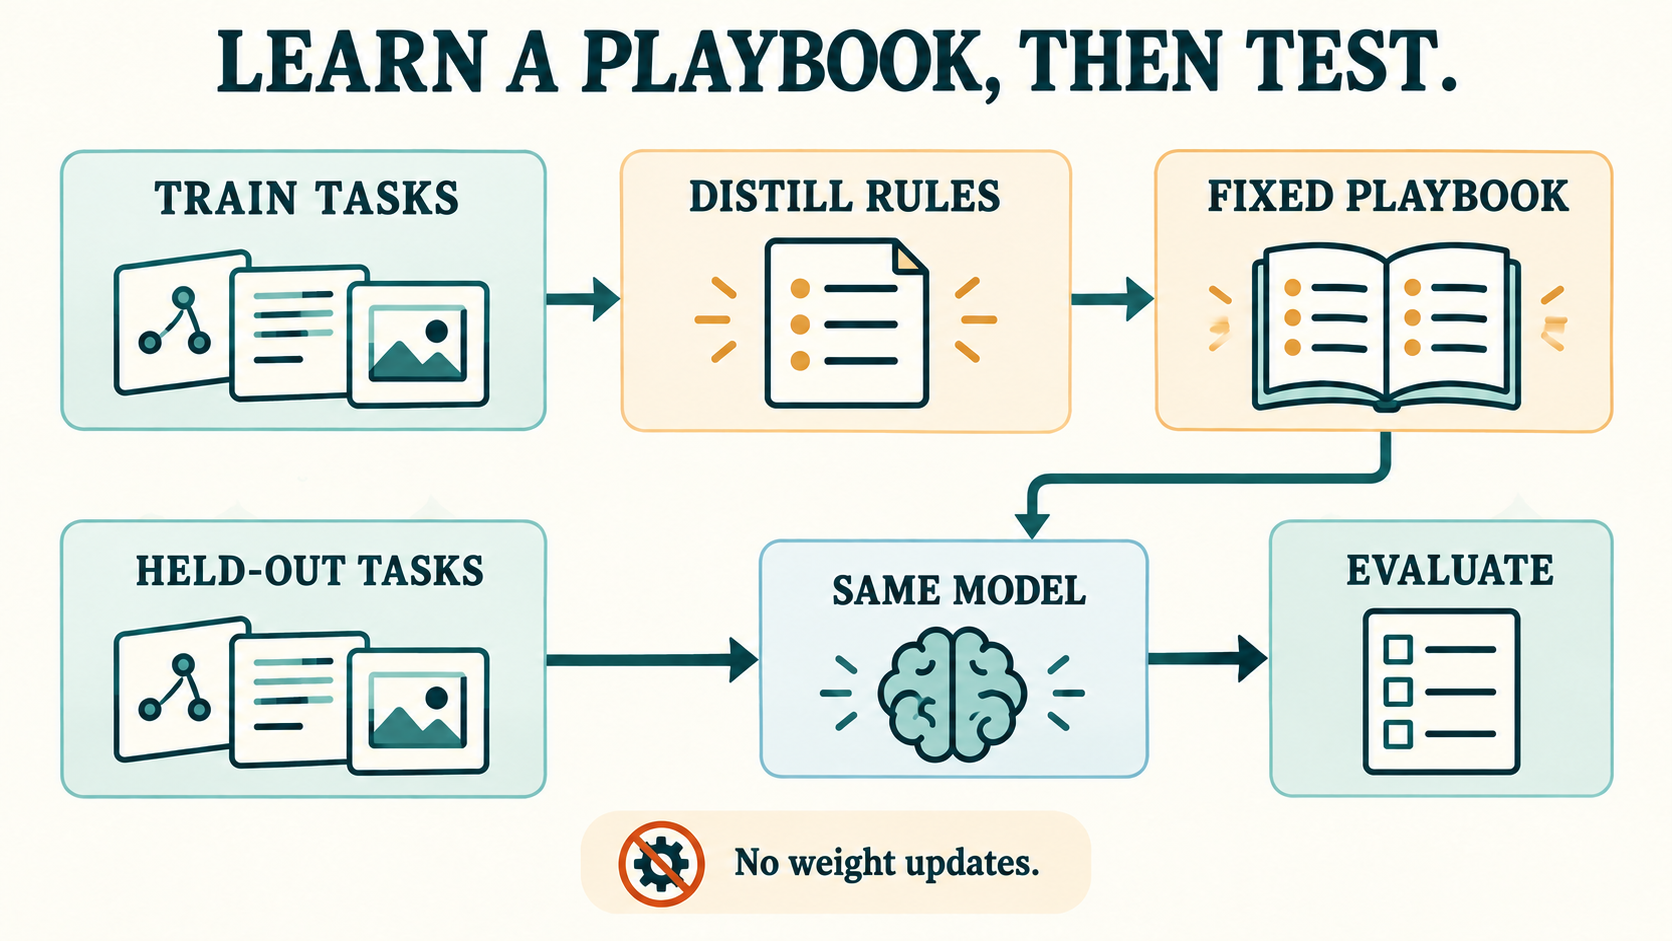
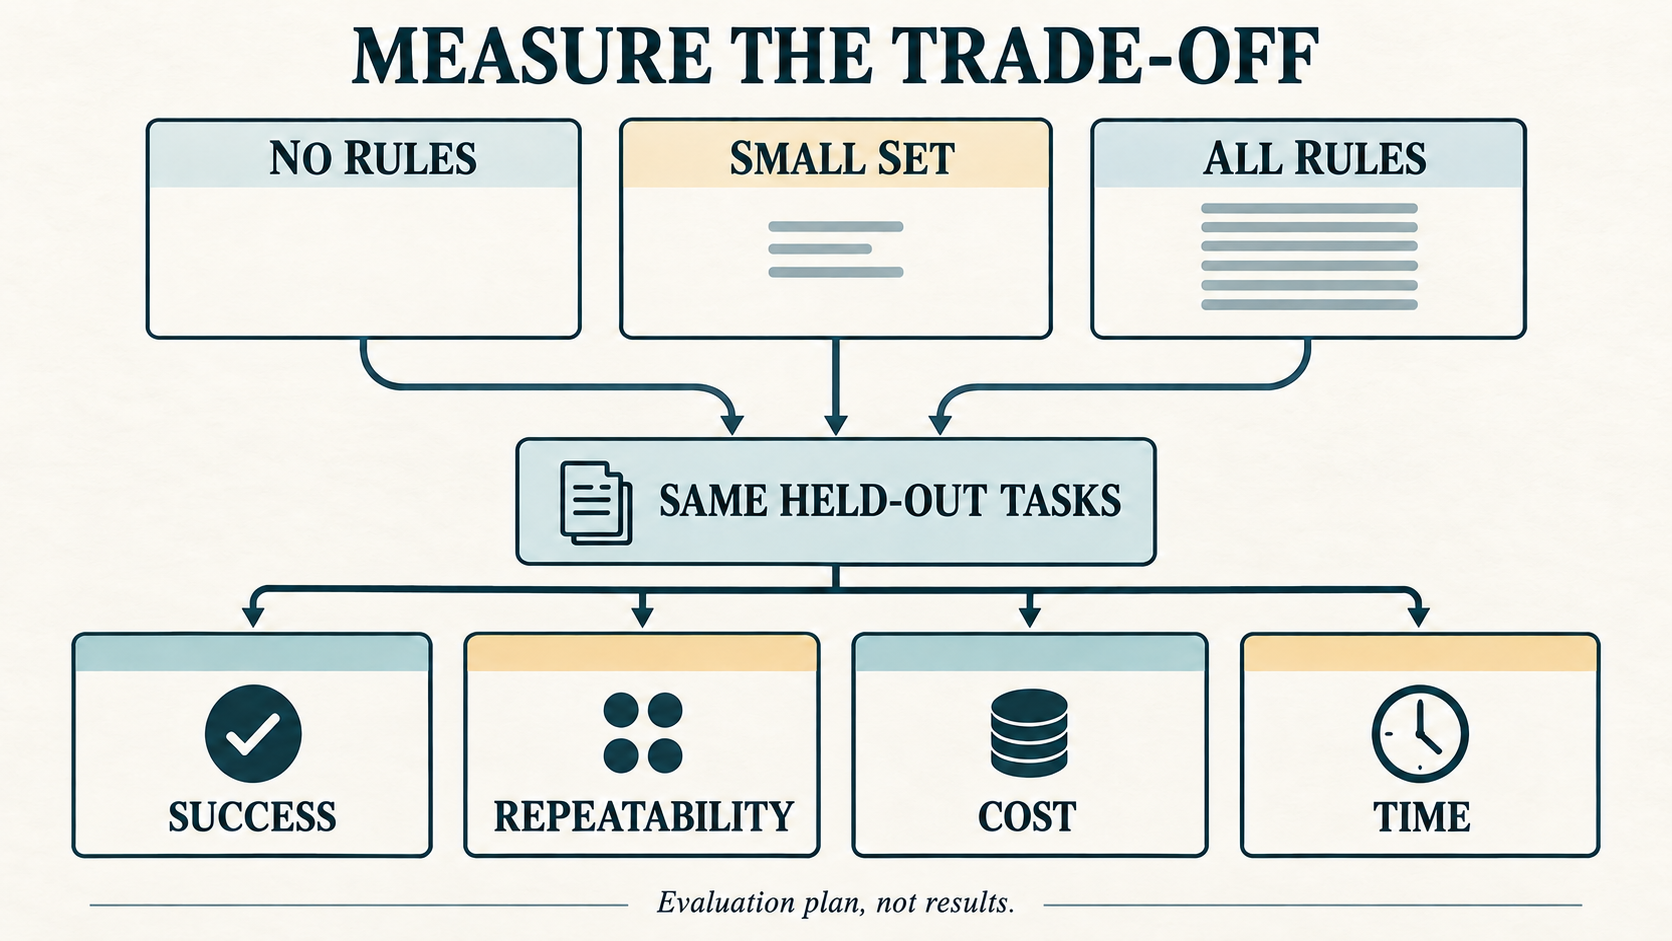
指針には、何件の異なる訓練課題から得られたかを表す支持数が付きます。今回の比較は、追加なし、支持数3以上だけを残すsup3、支持数1以上をすべて残すlosslessです。小売ではそれぞれ0件、31件、292件。航空のGPT-4.1では0件、14件、101件でした。
ここでいう支持数は、正しさの確率ではありません。複数の課題で繰り返し得られたことを示す数です。間違った指針が何度も抽出されれば、その数も増えます。手引きが分厚ければ安心、とは限らないわけです。説明書にも、読みすぎによる迷子はあります。
一度の成功と、4回とも成功することを分ける
評価に使われたτ²-benchでは、AIがシミュレーターの顧客と対話し、業務ツールを操作します。報告は小売と航空を対象とし、GPT-4.1を担当者、GPT-5.5を顧客役にして、各課題を4回試しています。実際の顧客へ導入した結果ではありません。
平均成功率は、全試行のうち何回成功したか。対してPass^4は、4回すべて成功した課題の割合です。4回のうち一度でも当たればよいpass@4とは違います。また、4回成功したから、その課題で将来も必ず成功するという意味でもありません。
次の表は、IBMが公表した指針抽出に使わなかったテスト課題の結果です。小売40課題、航空20課題という母数を残して読む必要があります。
| 領域 | 指針 | 平均成功率 | 4回とも成功 |
|---|---|---|---|
| 小売40課題 | なし | 78.1% | 57.5% |
| 小売40課題 | sup3:31件 | 78.8% | 60.0% |
| 小売40課題 | lossless:292件 | 82.5% | 67.5% |
| 航空20課題 | なし | 57.5% | 35.0% |
| 航空20課題 | sup3:14件 | 60.0% | 45.0% |
| 航空20課題 | lossless:101件 | 65.0% | 40.0% |
出典:IBM公式記事Table 1、2。数値は提供者の報告であり、AICompanyが新たにモデルを動かして再現した結果ではありません。
小売では、多い指針が平均成功率と4回連続成功の両方を伸ばしました。航空は違います。101件を入れると平均成功率は高くなりますが、4回連続成功は14件の構成より低くなります。航空20課題では5ポイントがわずか1課題分です。小さな差を普遍的な優劣へ膨らませず、どの失敗が増減したかも確認したいところです。
より強いモデルでも指針が役立つ可能性は残ります。同じ記事のGPT-5.5による航空テストでは、20課題のPass^4が指針なし55%から、指針あり70%へ上がったと報告されています。ただし、これも同じ評価領域での結果です。別の仕事へそのまま移せるとは限りません。
「首位」の母数と、未使用課題の母数は違う
順位比較には、訓練課題とテスト課題を合わせたbase splitが使われています。小売は114課題、航空は50課題です。指針を作るときに使った課題が、その評価にも含まれます。未使用課題での性能と同じ数字として扱えません。
AICompanyでは、固定した公開実験リポジトリの報酬ログを課題ごとに再集計しました。小売456試行では114課題中77課題、航空200試行では50課題中41課題が4回とも成功しており、約67.54%と82.0%を確認できました。
これは保存済みの採点結果を数え直した確認です。対話の生成や採点の正しさ、未使用課題の比較表を独立に再現したわけではありません。
さらに、確認時点で小売の提出PRと航空の提出PRはopenのままでした。いずれもプロンプトを変更したこと、学習課題がbase評価に含まれること、Unverifiedとして扱われる想定を明記しています。記事の順位比較も10月12日のスナップショットです。現在の承認済み首位として紹介するのは避けるべきでしょう。
往復が減っても、時間と費用が減るとは限らない
長い手引きは、モデルを呼ぶたびに入力として渡されます。小売のbase評価では、担当者と顧客シミュレーターを合計した1会話の費用が、指針なし約0.084ドルから、292件の指針で約0.139ドルへ増えました。約65%増です。これは当該実験の会計値で、実運用の見積もりや現在の料金表ではありません。
公開結果のEffort & costには、平均所要時間も載っています。指針なし107.2秒に対し、292件では119.8秒でした。会話のターン数が少ないことだけで、高速化したとは言えません。並列実行やAPIの揺らぎもあるため、この表だけで指針が遅延の原因だと断定することもできません。
同じ指針を繰り返し送るならキャッシュが有効かもしれません。ただし、キャッシュ込みの総費用と実時間は、別に測る必要があります。指針を作るための訓練試行と抽出の費用も、導入時には加えるべきです。
自分の作業では、指針の量を比較できる形にする
ここからはAICompanyの応用案です。記事制作の補助なら「主張の直後に一次資料を対応させる」「資料の発表日と実験実施日を分ける」など、具体的な失敗を防ぐ指針が考えられます。まず過去の練習用案件から指針を作り、別に残した案件で、追加なし・少数・全件を比べる方法がよさそうです。
支持数の数え方だけなら、次の小さな例で確かめられます。同じ課題から同じ指針が何度抽出されても、1件分として数えます。これは仕組みを説明する自作例で、ALTK-Evolveの意味的な統合や指針抽出を再現するものではありません。
from collections import defaultdict

examples = [
    ("A", "日付を確認する"),
    ("A", "日付を確認する"),
    ("B", "日付を確認する"),
    ("C", "日付を確認する"),
    ("A", "表の合計を確認する"),
]
support = defaultdict(set)
for task, rule in examples:
    support[rule].add(task)

small = [r for r, tasks in support.items() if len(tasks) >= 3]
print(small)  # ['日付を確認する']
この数え方を確認しても、選ばれた指針が役立つことまでは分かりません。検証用案件で成功率と繰り返し成功を測り、入力トークン、実時間、修正回数も並べます。検証結果を見て指針を選び直したなら、最後の評価用にさらに別の案件を残します。
また、手引きは業務ポリシーや実行権限の代わりにはなりません。返金や公開の前に確認するよう書くことと、ツール側で必要な条件を強制することは別です。機密情報を含むログから指針を作る場合も、そのまま共有せず内容を確認する必要があります。
経験を残す価値はある。残し方も評価対象にする
今回の報告は、行動指針をプロンプトへ追加することで、特定の顧客対応課題における成功率や繰り返し成功を改善できる可能性を示しています。一方、少数のテスト課題、シミュレーター、モデル依存の評価であり、本番の顧客満足や安全性を保証するものではありません。
公開リポジトリには、9月8日の別の3試行評価も残っています。そこでは小売でも少数の指針が平均成功率で優勢でした。今回の4試行評価と混ぜることはできませんが、「多いほどよい」を固定ルールにできない理由にはなります。
持ち帰りたいのは、記憶を増やすことより、経験から作った手引きを検証可能な部品として扱う姿勢です。何を残し、何を削るか。その判断まで含めて測ると、AIの経験は、読まれない議事録から次の作業に効く道具へ近づきます。
一次資料:IBM Research公式評価報告(Table 1〜5)、ALTK-Evolve公開実装、実験コード・手引き・公開ログ。図は仕組みと確認手順をAICompanyが独自に再構成しています。