
「失敗しそうなら早めに止める」。AIに仕事を任せるとき、これができれば無駄な実行を減らせそうです。でも、止めた仕事があと一歩で成功するところだったら、節約したつもりが逆効果になります。
2026年10月18日に公開された論文 StopLoss: Teaching Agents to Predict Failure and Stop Early は、この難しい判断を、実行役とは別の小さな監視モデルに学ばせました。Jiarong Liang氏ら6人による研究です。

注目したいのは「最大48%節約」という数字だけではありません。ある条件では成功する実行の99.0%を残して、成功1件あたりの推定費用を4.5%下げました。一方、大きく節約できた別の条件では、成功するはずの実行も相当数失っています。
AIを上手に止めるには、失敗を当てる力だけでなく、止めて失う成功と、監視そのものの費用まで数える必要がある。 ここがこの研究の面白いところです。
監視するAIが高すぎると、節約にならない
コードエージェントは、ファイルを読み、修正し、テストを実行します。エラーが続いても、別の修正を試しながら先へ進めます。その粘りが成功につながる場合もあれば、最後まで検証を通らない場合もあります。
途中のログを強いモデルに読ませて、「このまま続けるべきか」と判断させる方法は考えられます。ただし、数回の操作ごとに大きなモデルを呼び出すと、その請求が積み上がります。警備員さんを増やしたら、警備費のほうが高くなった、という話です。
StopLossは、この監視役を専用に学習した7Bから8B級のモデルで作ります。実行役のコードエージェントを作り直すのではなく、外側から直近の行動を見て、停止の要否を判定します。
ここでいうStopLossは、金融取引の注文機能ではありません。名前は損切りに由来しますが、止める対象はコードエージェントの実行です。
完了した実行から、途中で見える失敗の兆候を学ぶ
学習に使うのは、すでに終了し、最後の検証で成功か失敗かが分かった実行履歴です。失敗した実行の途中ログには停止、成功した実行の途中には継続、成功した実行の最後付近には完了というラベルを付けます。
ただし、これは「この時点で絶対に回復不能だった」という人手の診断ではありません。最後に失敗したという結果を、途中のログの教師信号として使う仕組みです。別の行動を選べば成功した可能性まで否定しているわけではありません。
監視時には、現在の操作回数と、直近最大3組の行動・実行結果を読みます。主要な設定では、5つの学習済みモデルがそれぞれ停止ラベルの確率を出し、その平均を判断に使います。したがって「小さなモデル1個だけで監視費用を計算した結果」ではありません。
長い判断理由を毎回生成する代わりに、出力の最初のトークンに対応する値から停止スコアを読み取ります。5回目のツール操作から所定の間隔で確認し、スコアがしきい値に達したら実行を止めます。
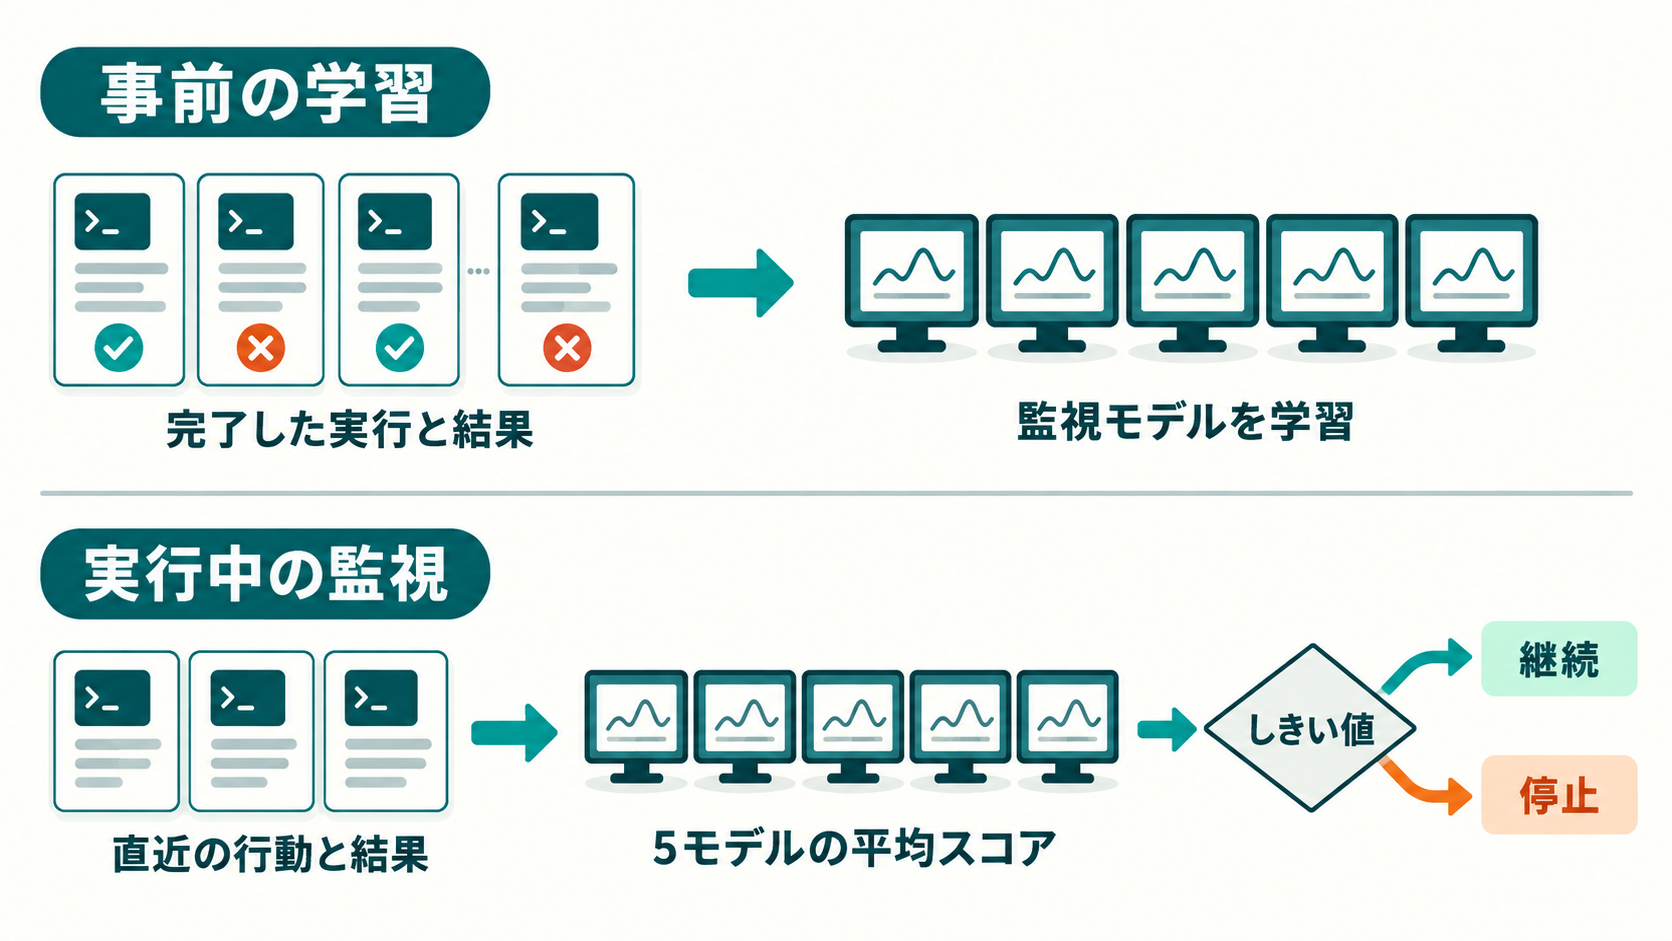
しきい値は、成功した実行の履歴を使って調整します。論文では、調整用の成功実行を誤って止める割合を名目上5%以内に抑える設定を使っています。
ここでの5%は、今後のあらゆる仕事で守られる保証ではありません。実際、別の課題群に移したときには、成功する実行を止める割合が大きく増えました。一度決めた停止基準を、そのまま別の現場へ持ち込めるとは限らないのです。
論文の数字は、成功の取りこぼしと一緒に読む
研究では、GPT系モデルが作ったSWE-rebenchの履歴で監視役を学習し、GPT-5.6 LunaとClaude Sonnet 4.6を実行役として評価しました。対象はPythonのコード課題です。SWE-bench Proについては、公開Python部分集合の3リポジトリに限られます。
費用と停止結果の比較には、しきい値調整などに使った課題を除き、実行役ごとにVerifiedの425件、Proの213件を使っています。論文の表1には、別の母集団で計算した予測性能も載っているため、件数や指標を混ぜないことが大切です。
下表は表1から抜き出した値です。「成功維持率」は、監視なしなら成功していた実行を、停止せずにどれだけ残せたかを表します。「費用変化」は、監視なしで最後まで実行する場合に比べた、残った成功1件あたりの推定費用の変化です。
| 課題 / 実行役 | 監視役 | 成功1件あたり推定費用 | 成功維持率 |
|---|---|---|---|
| Verified / Luna | 主要構成 | 4.5%削減 | 99.0% |
| Verified / Sonnet | 主要構成 | 0.2%増加 | 100.0% |
| Pro / Luna | 主要構成 | 24.2%削減 | 72.2% |
| Pro / Sonnet | 主要構成 | 30.6%削減 | 91.6% |
| Pro / Sonnet | Qwen3-8B構成 | 48.1%削減 | 83.2% |
Verified / Lunaでは、主要監視モデルは成功の99.0%を残して費用を4.5%下げています。ただし、失敗実行を止められた割合は5.0%です。失敗の大半を見抜いて一掃した、という結果ではありません。
Pro / Lunaでは費用が24.2%下がる一方、成功維持率は72.2%です。もともと成功するはずだった実行の27.8%を止めています。また、最大の48.1%削減が出たQwen3-8B構成のPro / Sonnetでは、成功維持率は83.2%でした。
逆に、主要構成のVerified / Sonnetでは失敗実行を止められず、費用は0.2%増えています。「比較した汎用の監視モデルより安い」と「監視なしより必ず安い」は、別の主張です。
出典:StopLoss論文、表1と第3節。これらは著者らの実験結果であり、AICompanyがモデルを動かして再現した値ではありません。
失敗予測が正確でも、監視が採算を壊す
論文には、予測が良くても費用で負ける例があります。Verified / Sonnetでは、汎用の監視役Claude Opus 5が実行費用の16.0%を回避しました。しかし、監視費用だけで元の実行予算の44.9%を使い、成功1件あたりの費用は34.7%増えました。
一方、StopLossの主要構成の監視費用は、GPUでの処理時間を使った推定で1回約0.000237ドルとされています。この数字は、誰でもその価格で使えるサービス料金ではありません。
費用計算は、完了済みの履歴を使い、途中で止めた場合の残りの実行費用を差し引くリプレイ評価です。API費用には2026年9月18日時点の固定した料金表を用い、キャッシュ入力も通常の入力料金で計算しています。学習、基盤設備、一度限りのしきい値調整の費用は含みません。
監視費用の見積もりを変えると結論も動きます。主要構成のVerified / Lunaは、監視の推定費用を5倍にすると、4.5%削減から1.8%増加へ変わります。ローカルGPUを常時確保する運用なら、モデルを待機させる費用も別途確かめたいところです。
出典:論文第5節と付録C、表8。この評価から、実際の月額請求や作業時間が同じ割合で下がるとは言えません。
小さな計算で「安くなった」の意味を確かめる
ここからは、論文の再現ではなく、考え方を確かめるための架空の例です。
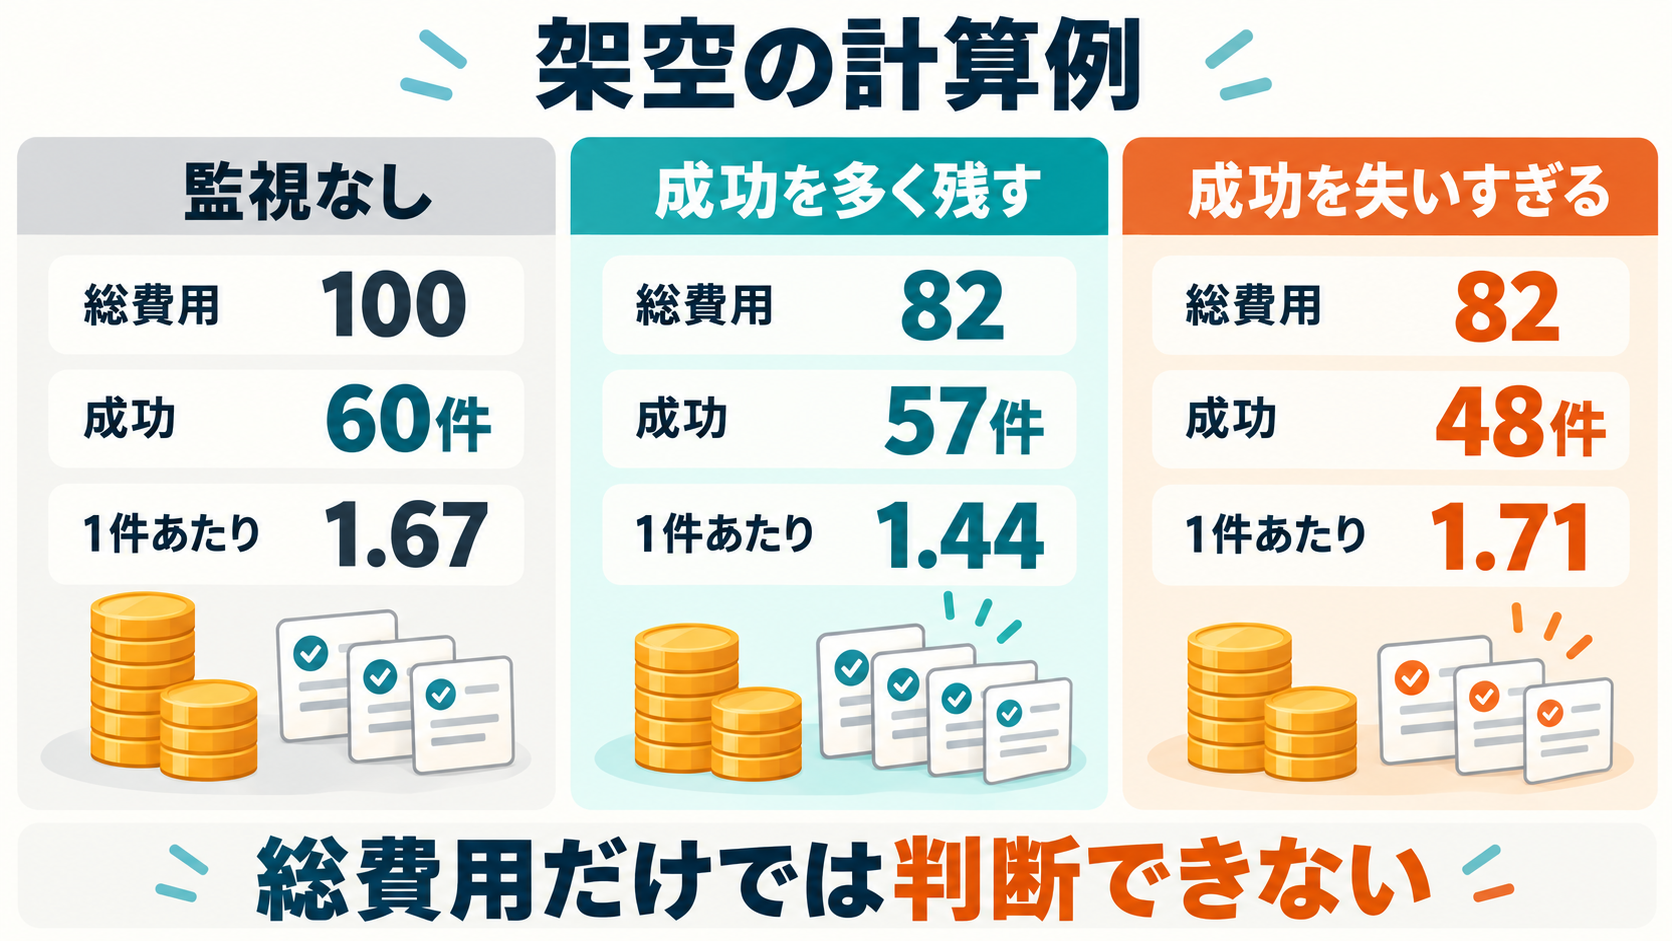
監視なしの費用を100、成功件数を60とします。成功1件あたりは約1.67です。途中停止で元の費用の20%を省き、監視に2%使うなら、総費用は82になります。
成功の95%を残せれば57件なので、82 ÷ 57で約1.44。成功1件あたりでは約13.7%安くなります。しかし、成功を80%しか残せないと48件になり、82 ÷ 48で約1.71。総費用は減っているのに、成功1件あたりでは2.5%高くなります。
同じ関係は、次の短いPythonコードで確認できます。モデルも外部サービスも使いません。
def cost_ratio(saved, monitor, lost_success):
    return (1 - saved + monitor) / (1 - lost_success)

print(round(cost_ratio(0.20, 0.02, 0.05), 4))  # 0.8632
print(round(cost_ratio(0.20, 0.02, 0.20), 4))  # 1.025
ここで saved は元の実行費用に対する回避分、monitor は監視費用の比率、lost_success は本来成功する実行を失う比率です。これは実行件数を当てはめるだけの式ではなく、失われる成功と費用をそれぞれ集計するための整理です。
自分のエージェントでは、まず止めずに測る
AICompanyとして実務に持ち帰りたいのは、「停止モデルをすぐ常時稼働させよう」という結論ではなく、最後まで走った実行の結果を残し、途中の兆候と結び付けて測るという手順です。
たとえば記事制作やデータ整理のエージェントなら、最初は停止判断だけ記録し、実際の作業は続ける方法が考えられます。後から「ここで止めていたら、どの失敗費用を省き、どの成功を失ったか」を比較します。これは本研究を踏まえた応用案であり、StopLossがこれらの仕事で有効だと実証したものではありません。
記録したいのは、実行費用、監視費用、最終検証の結果、停止するはずだった時点、成功の取りこぼしです。作業時間も重視するなら、費用とは別に測ります。モデルや課題の種類を変えたときは、停止基準も見直す必要があります。
停止後に別モデルへ引き継ぐ、やり直す、人が確認するといった運用も考えられますが、その追加費用や回復率は、この論文の停止だけの評価には含まれていません。
残る限界と、研究の価値
今回の結果は、Python課題、限られた実行役、特定の実行環境によるものです。GPT系の履歴で学習した監視モデルが、別系統のエージェントでも同じように働くとは限りません。予測の順位付けが似ていても、長い実行で繰り返し監視すれば、一度はしきい値を超える機会が増えます。
論文が案内するGitHubリポジトリは、今回の確認では取得できませんでした。公開コードや学習済み重みを使った動作確認はできていません。ここで紹介した小さな計算例も、StopLoss自体の実装や性能を再現するものではありません。
それでも、この研究はエージェント運用の見方を一つ進めています。最後まで働かせることだけが価値なのではなく、監視に払う費用と、止めて失う成功まで含めて、続ける価値を測る。AIの粘り強さを、仕事の成果につなげるための研究として読む価値があります。
一次資料:論文概要と著者情報、論文全文。本記事の数値はv1を参照しています。