
調べものを頼んだAIが、見出しも参考文献も整ったレポートを返してきた。ところが引用先を開くと、その論文はそこまで言っていない。見た目は優等生なのに、根拠だけが半歩ずれている。
研究や技術調査で困るのは、文章が書けないことより、こうした「もっともらしい広げすぎ」かもしれません。

Ai2が10月2日に公開したAstaBriefの公式技術記事は、この問題に小さなモデルと学習データの工夫で向き合った記録です。検索した論文の抜粋を渡すと、引用付きのレポートをまとめる8Bモデル。注目したいのは大きさではなく、どこを軽くし、どこを厳しくしたかです。
最初に時期を整理しておきます。今回の新着は技術記事です。モデルの公開リポジトリは以前から存在し、学習と評価の多くは2025年に行われています。2026年の最新モデルを一斉に打ち負かした話ではありません。それでも、調査の工程を設計するうえで持ち帰れるものがあります。
速くしたのは「調査の全部」ではなく、レポートを書く工程
AstaBriefが受け取るのは、研究の問いと、検索済みの文献の抜粋です。何も渡さずに未知の分野を正確に調べ切るモデルではありません。
従来のAstaのThinking modeは、材料を要約し、まとめ、節ごとに文章を作る複数段階の工程を使います。AstaBriefを使うFast modeでは、この途中の処理を簡略化し、本文をまとめて生成する方針を取りました。
Ai2の報告では、Asta全体のレポート生成時間はFast modeで平均51.1秒、Thinking modeで178.5秒。割り算すると約3.5倍です。ただし、これは仕組み全体の比較です。モデルだけを同じ条件で走らせた速度差ではなく、工程を減らした効果も含みます。日本語の手元環境で同じ時間になるとは言えません。
公開コードにも、この役割分担が表れています。確認したgenerate_reportは検索後の材料を受け取り、本文を生成してから引用や節を整理します。タイトルの生成には別の呼び出しがあります。「本文を一度に書く」を「調査全体が一回の呼び出しで終わる」と読み替えないことが大切です。固定した実装
小さなモデルに、よいレポートの書き方を覚えさせる
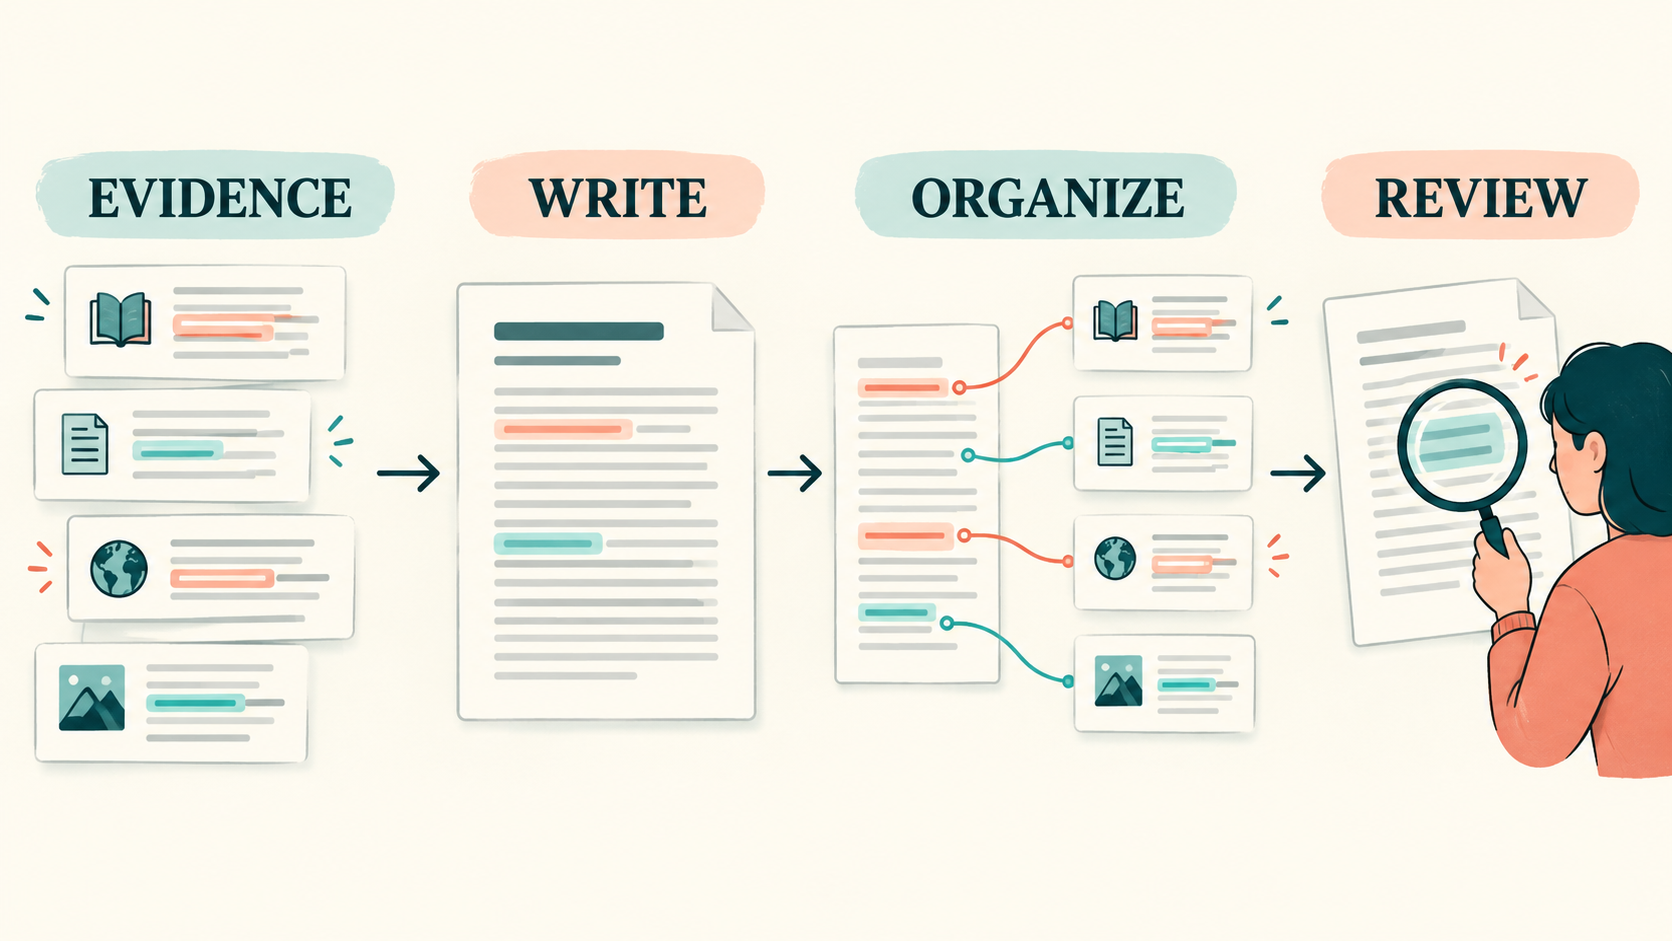
土台はQwen3-8Bです。学習には、よい回答例を覚えるSFTと、二つの回答のうち好ましいほうを選びやすくするDPOを使いました。ここで重要なのは、難しい学習方法を足す前に、何を手本にするかを整えた点です。
問いは、研究者が実際に使った調査システムの利用記録から集めています。短すぎる入力、科学と関係のない依頼、個人情報を含むものなどを除き、研究向けの問いを残しました。その問いについて、既存の文献検索・レポート生成工程を使って回答例を作っています。
DPOでは、同じ問いに対する二つのレポートを比較します。二種類の判定モデルが一致した組だけを残すことで、好みのデータに入り込むばらつきを減らす設計です。ただし、判定者が一致したからといって科学的な正しさが証明されたわけではありません。
技術記事では、絞り込んだ問いの集合を約9万件、SFTに使える例を約4.7万件と説明しています。一方、公開されたSFTデータカードは約3.95万件と記載しています。工程中に作った集合と配布データを同一視せず、差の理由も資料にないまま補いません。DPOの配布データは約6,600件です。
効いたのは、難しい判定を増やすことだけではなかった
最初のSFTで文章の内容は改善しました。しかし、問いへの関連性や引用の質では、既存の工程に届かない部分が残りました。そこでAi2は、合成した学習用レポートを四つの観点で選び直しています。
- 入力の材料に比べて、出力が長くなりすぎていないか。
- 引用した文献は、問いに関連しているか。
- 主張に引用が付いている割合は十分か。
- 一部の文献だけに偏っていないか。
調べた範囲では、引用が少ないレポートを除くことが最も大きな改善につながりました。フィルターを厳しく組み合わせれば、さらによくなるとは限らなかったそうです。
ここには、実務でも使いやすい発想があります。完成した文章を何度も注意して直すだけでなく、そもそも「根拠を添えて書く手本」を増やす。うまく書けた例の中身を点検してから再利用する、ということです。
ただし、引用の多さは入り口です。関係のない出典を大量に貼れば、見た目の密度は上がります。参考文献が行列を作っていても、主張を支えていなければ意味はありません。
実際の評価は、どこがよくなったのか
モデルカードには、コンピューター科学の研究質問100件からなるテスト分割の結果が掲載されています。全体の質問集合について技術記事が説明する200件と、ここでの100件のテスト分割は区別します。
下表は、同じテスト分割における三つの指標です。数値はAi2が公開した評価値で、AICompanyが独立に再測定したものではありません。
| モデル | 回答の関連性 | 引用の精度 | 引用のカバー率 |
|---|---|---|---|
| Qwen3-8B | 90.6 | 76.2 | 64.6 |
| AstaBrief-8B-SFT | 90.4 | 87.7 | 71.3 |
| AstaBrief-8B | 89.0 | 90.5 | 78.2 |
引用の精度は、その引用が結び付いた主張を支えているか。引用のカバー率は、必要な主張が引用でどれだけ支えられているか。回答の関連性は、段落が問いに沿っているかを見ます。
表では引用に関する二つの値が上がる一方、回答の関連性は少し下がっています。全部の項目が同時によくなったわけではありません。「小さなモデルが大きなモデルに勝った」という一行に圧縮すると、この違いが消えてしまいます。
別の長文調査ベンチマークDeepScholarBenchでは、AstaBriefの値は53.50、既存のAsta ScholarQAは60.25、DR-Tulu-8Bは56.26でした。こちらは別の指標なので、上の表と値を直接比べられません。少なくとも、どの評価でもAstaBriefが一番だったという解釈はできません。
人の評価も小規模です。研究者3人による14問の比較では、全体の好みではDR-Tuluが選ばれ、引用の正確さでは3人中2人がAstaBriefを好みました。自動判定の勝率とは別の結果です。対象人数と問いの数を考えると、広い利用者層の評価として一般化するには材料が足りません。
引用を確認しても、言い過ぎは残る
たとえば、ある研究が「特定の条件で試した20件の課題では改善した」と報告していたとします。それを「この方法はどんな現場でも改善する」と書き換えたら、同じ論文を引用していても、主張の範囲が変わっています。
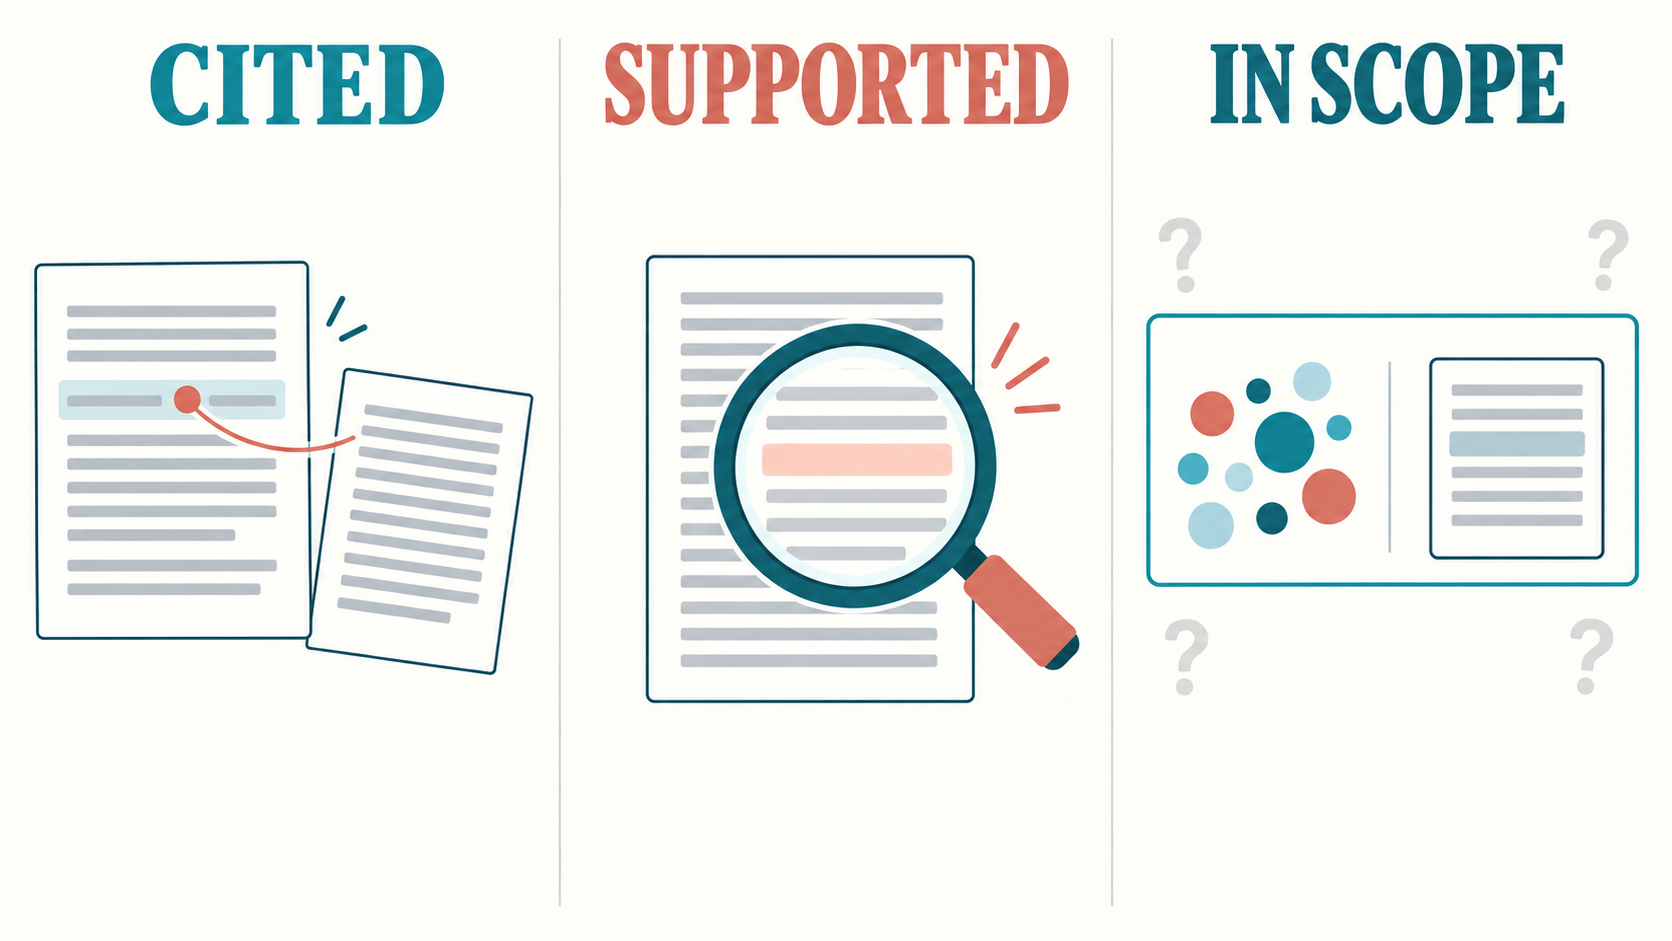
引用先の存在、引用先の内容、言い切りの強さ。この三つは別々に確認する必要があります。技術記事も、対象集団を広げることや、関連を因果として書くことなどを挙げ、引用だけでは科学的な忠実さを測り切れないと指摘しています。
AstaBriefから学べるのは、引用を増やせば完成ということではありません。引用に関する弱点を工程として測り、改善したうえで、まだ測れていない弱点を残しておく姿勢です。
小さな実験:出典が付いた主張と、支えられた主張を分ける
ここからはAICompanyの説明用の例です。AstaBriefの推論を実行した結果ではありません。人が出典を読み、主張との対応を判定済みという前提で、二つの割合を数えます。
claims = [
    {"cited": True,  "supported": True},
    {"cited": True,  "supported": False},
    {"cited": False, "supported": False},
]
cited = sum(c["cited"] for c in claims)
supported = sum(c["cited"] and c["supported"] for c in claims)
print("引用付きの割合:", round(cited / len(claims), 3))
print("引用付き主張の支持率:", round(supported / cited, 3))
出力は、それぞれ0.667と0.5です。三つの主張のうち二つに出典が付き、その二つのうち一つだけが根拠に支えられています。この例だけでも、引用を貼った割合と、引用が役に立った割合が違うと分かります。
このコードは文章の意味を自動判定しません。資料を読んで行う判断を、数え方に反映しているだけです。原著の評価器の再現でもありません。仕事で使うなら、主張、出典箇所、対象条件、確認者の判定を一緒に保存すると、後から見直しやすくなります。
記事制作に持ち帰るなら、まず工程を分ける
AICompanyの解釈では、最初に試す価値があるのは「全部を小さなモデルに任せる」ことではなく、調査と文章化を分けることです。
候補を広く集める。必要な文献を読む。使える事実を抜き出す。その材料から文章を組む。最後に、出典と主張の範囲を確認する。どこで時間がかかり、どこで誤りが入るかを分けて見ると、本文生成だけを軽くできる可能性があります。
たとえば記事制作なら、出典付きの事実メモを固定したうえで、短い初稿を作る担当を置く方法が考えられます。ただし、抜粋から条件を落とすと、書き手を変えても誤りは残ります。検索や資料の読み取りが弱ければ、文章の学習だけでは埋まりません。
これはAstaBriefで効果が測定されたAICompanyの運用ではなく、設計から導いた応用案です。試す際は、同じ問いと同じ文献で、所要時間に加えて引用の誤り、条件の省略、修正にかかった手間を比べたいところです。
使う前に残る条件
学習データの絞り込みは英語を中心にしています。日本語レポートでも同じ品質になるかは、今回の資料だけでは分かりません。日本語の論文、専門用語、引用の表記を含む別の検証が必要です。
比較の多くは開発当時のモデルと工程です。2026年の最新モデル群に対する全面的な再評価は行われていません。自動評価には判定モデルへの依存があり、DPOで狙った好みと評価の好みが重なる点にも注意が必要です。
権利も分けて確認します。モデルの重みはApache 2.0ですが、公開SFT・DPOデータはCC BY-NC 4.0と記載されています。重みと学習データの利用条件は同じではありません。配布データを使う商用の再学習を、モデルのライセンスだけで判断しないようにします。
公開されたローカル向けの例は出発点になりますが、モデルを手元に置くだけで全工程がローカルになるとは限りません。検索、生成、判定の各接続先を確認する必要があります。今回は固定したコードを読み、計数の説明用例を検証しました。重みを読み込む推論、GPU上の速度比較、評価全体の再実行はしていません。
文章のうまさより、材料と工程をよくする
AstaBriefの面白さは、研究レポートを「賢いモデルが長く考えればできるもの」として扱わなかったことです。検索した材料を渡す役割をはっきりさせ、手本の引用を磨き、途中の工程を減らす。その組み合わせで、使いやすい速さと引用の質を狙っています。
持ち帰りたいのは、小さなモデルで何でも代替できるという結論ではありません。文章を書く工程を狭く定義し、根拠を測る仕組みを外側に置けば、別の設計を試せるということです。
初稿が速くできるのはうれしい。でも、引用先を開く時間まで節約してしまうと、そこで話がひっくり返ります。速く書くために、確かめる場所を決めておく。今回の技術記事は、その考え方を具体的に見せてくれます。
一次資料
- Ai2公式技術記事:Open-sourcing AstaBrief
- Ai2によるHugging Face掲載記事
- AstaBrief-8Bモデルカードと評価表
- 公開SFTデータ
- 公開DPOデータ
- 確認したScholarQA lite実装