
AIで作った文章に、見えない目印が入る。その目印を調べれば、誰が何を書いたのか分かる。そう聞くと便利ですが、後半には大きな飛躍があります。
OpenAIが2026年10月5日に公開した文章透かし技術「textGrain」は、文章の中に統計的な信号を埋め込むものです。ところが同社の公開評価では、英語の400トークンの文章で、単語の10%を同義語に置き換えると検出率は約92%から66%へ、25%の置換では17%へ下がっています。

「見つからなかったから人間の文章」とは言えないのです。逆に、目印が見つかっても、文章の正しさや人間の貢献量までは分かりません。
今回の発表が面白いのは、単にAIを見破る道具を増やした点ではありません。文章を作るときの選択肢をどの程度残しながら、後から調べられる信号を加えるか。その調整を、情報理論の言葉で説明した点です。公式の技術報告を読みながら、できることと限界を分けてみましょう。
後から文章を鑑定するのではなく、作るときに信号を入れる
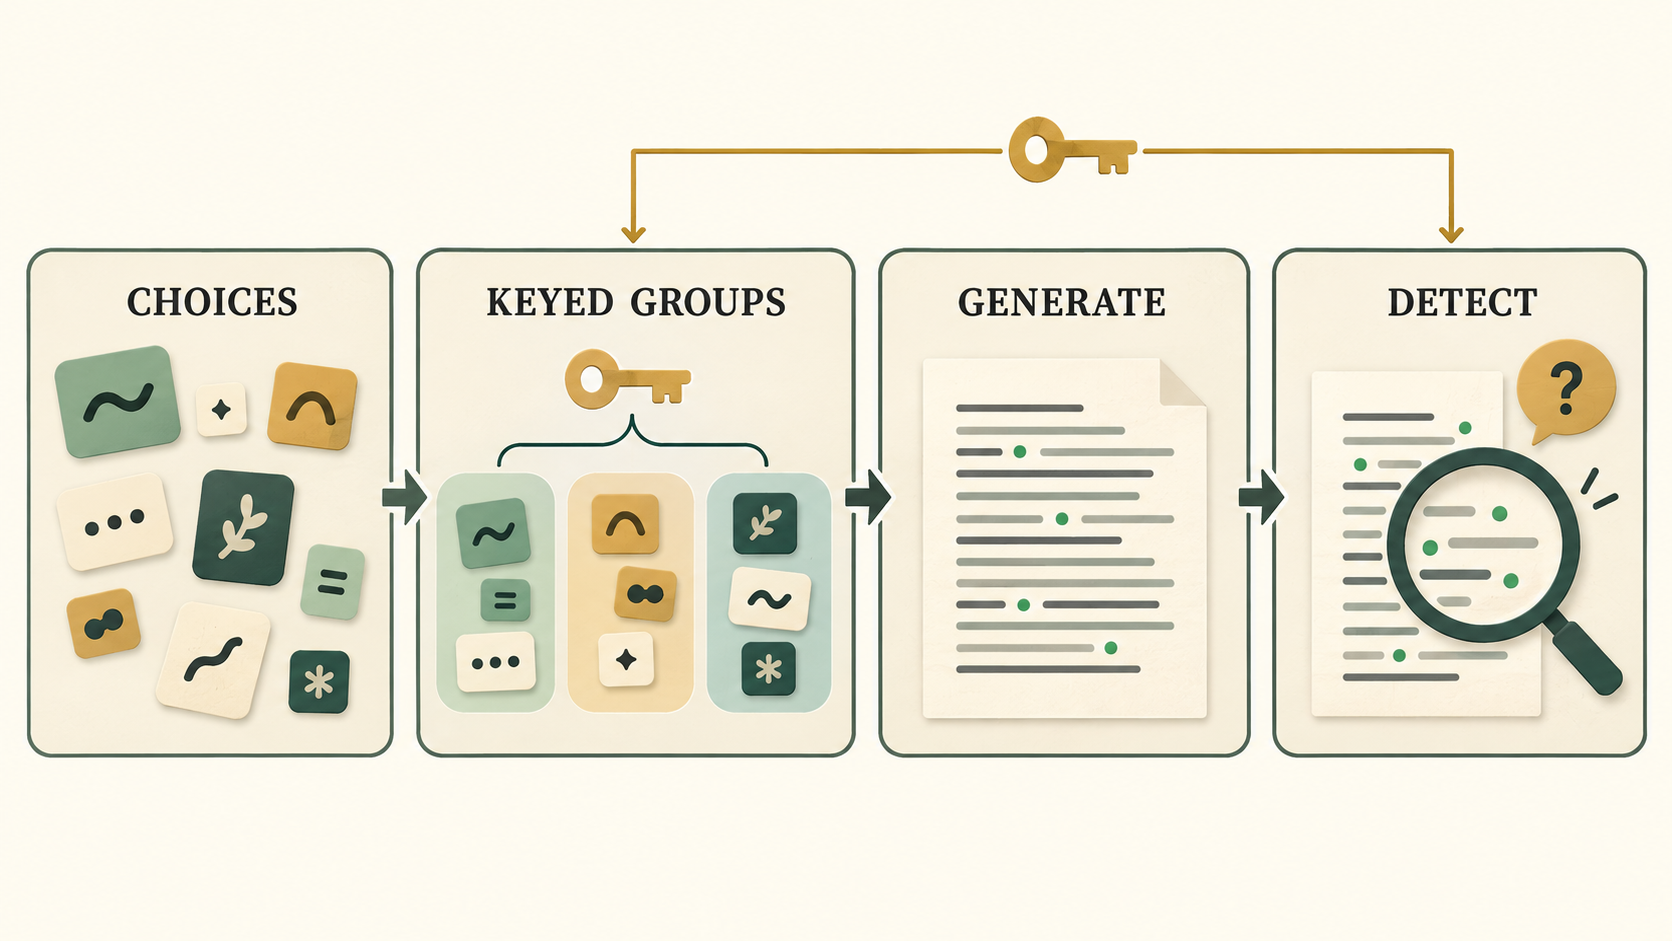
一般的なAI文章判定と、生成時に埋め込む透かしは出発点が違います。前者は文章の特徴からAIらしさを推測します。textGrainでは、生成側が秘密の鍵と直前の文脈を使って単語の選び方に統計的な関係を作り、検出側がその関係を調べます。
ここでいうトークンは、単語や単語の一部分など、モデルが文章を扱う単位です。文字数とは同じではありません。文章中に特定の記号を挿入する仕組みでもなく、読者が目で確認できるタグでもありません。
技術報告の導入部は、以前からある透かしの課題を指摘しています。鍵を変えて平均すれば元の単語の確率分布に戻る方式でも、同じ鍵と同じ文脈を固定すると、毎回同じ単語を選んでしまうことがある。複数の表現案や解決策を欲しい作業には、この偏りが困ります。
つまり、「平均すれば元どおり」と「同じ条件でも十分に選択肢が残る」は別の話です。textGrainが扱うのは、この選択の余地と検出できる信号の間の調整です。
選択肢を束ね、失ってよい自由度に予算を付ける
モデルは次に続くトークンの候補に確率を与えます。textGrainは秘密鍵と文脈に基づいて語彙を複数のブロックに分け、そのブロックと鍵から作る乱数の間に関係を持たせます。語彙全体を一語ずつ最適化するより、計算する対象を小さくするためです。
ブロックの中でどのトークンを選ぶかについては、元の相対確率を残します。例えば、同じブロック内の候補Aが候補Bの2倍選ばれやすかったなら、その比を保つということです。ブロックを選ぶ段階には信号を入れ、ブロック内の選択には元の関係を使います。
ブロックと乱数の結び付け方は、最適輸送という最適化で決めます。名前は難しいですが、ここでは「双方の全体的な確率を保ちながら、どの組合せを選びやすくするかを決める」と考えると読み進めやすいでしょう。
その結び付きが強すぎると、鍵が分かったときに次の単語の選択が固定されやすくなります。そこで、失ってよい平均的なサンプリングの自由度に予算を設けます。技術報告では、独立した状態からのKLダイバージェンスが、鍵に条件付けたときの平均エントロピーの減少と一致することを使っています。
エントロピーは、ここでは候補選択の不確かさを表す量です。「文章の面白さ」や「正解率」そのものではありません。エントロピーを残す設計から、文章の意味や品質が絶対に変わらないと結論することはできません。
また、報告が示す予算の性質は鍵や乱数についての平均です。個々の固定鍵、個々の候補列で同じ割合の自由度を保証するものではありません。数値計算の反復回数や許容誤差によっては、実際の損失が目標を上回ったり下回ったりするとも明記されています。設定した予算だけを見て安心するのではなく、計算結果を確かめる必要があります。
検出側は、同じ鍵で文章の選ばれ方を調べる
検出側は文章、秘密鍵、生成時と同じトークナイザーやブロック構成、文脈窓の規則などを使います。文脈と鍵から、生成時のブロック分割や乱数由来の値を再構成し、実際のトークンが信号に沿って選ばれているかを統計的に調べます。
この再構成には、生成したモデル本体や、生成時に使ったエントロピー予算は必要ありません。ただし「文章だけを誰でも調べられる」という意味ではありません。同じ秘密鍵と方式の設定が必要です。
技術報告は、同じ文脈を重複して数えない条件や、透かしのない文章が鍵から独立しているといった仮定の下で、検定の誤検出率を説明しています。実際に使い回す固定鍵や有限精度の計算、異なる文章用途については、別途、実測による較正が必要です。理論上の条件と実際の運用成績を、一つの保証にまとめないことが大切です。
なお、報告には投機的サンプリングとの両立も記載されていますが、対応できることと、実際に速くなることは別です。受理率や両モデルでの透かし計算の費用に左右されるため、ここから処理速度の改善を断言することはできません。
公開評価では、長さと編集の影響が大きい
OpenAIの公式記事にある検出評価は、短い文章や、表現の自由度が低い文章での難しさを示しています。
| 評価条件 | 公開された検出率 | 読むときの注意 |
|---|---|---|
| 心理学などの内容、200トークン | 約80% | 目標誤検出率1%。ELI5の質問を使用 |
| 同様の内容、400トークン | 約95% | 数学などでは検出率が大きく低下 |
| 別の400トークン英語評価、置換前 | 約92% | 同義語置換の比較に使った基準 |
| 同じ編集評価、単語10%を同義語置換 | 約66% | 表現を変えると信号が弱まる |
| 同じ編集評価、単語25%を同義語置換 | 約17% | 未検出でも透かしの不存在を断定できない |
約95%と約92%は、それぞれの評価で示された値です。同じ試験の基準値として混ぜないようにしました。いずれも提供元による評価であり、こちらで検出器を動かして再現した結果ではありません。日本語の投稿、短い見出し、翻訳文に、そのまま同じ検出率を当てはめることもできません。
出力品質については、Astraの推論設定maxで、透かしの有無を比較した8項目の結果を同社が掲載しています。値は上下しており、同社は意味のある性能差を見ていないと説明しています。ただ、技術報告に生の試行結果や各項目の信頼区間があるわけではありません。これを、あらゆる用途で品質が完全に同一とする証拠にはしません。
誤検出率1%でも、陽性の意味は利用場面で変わる
もう一つ、読者側で考えておきたい点があります。「誤検出率1%」は、「検出された文章のうち間違いが1%」という意味ではありません。透かしのない文章のうち、どれだけを誤って陽性にするかという割合です。
試しに、1万件の文章のうち対象の透かしが実際にあるものを100件と仮定します。さらに、検出率95%、誤検出率1%がこの集団にもそのまま当てはまると仮定すると、真の検出は95件、透かしのない9,900件からの誤検出は99件です。陽性194件のうち、対象の透かしが実際にあるのは約49%になります。
次の計算は、この分母の違いを確かめるための小さな例です。textGrainの検出器の実装ではなく、実際の投稿集団の割合を測ったものでもありません。
total = 10_000
marked = 100                 # 仮定:対象透かしのある文章は1%
true_positive = marked * 0.95
false_positive = (total - marked) * 0.01
precision = true_positive / (true_positive + false_positive)
print(true_positive, false_positive, round(precision, 3))
# 95.0 99.0 0.49
この例は透かしが役に立たないと言いたいのではありません。陽性が出たときの判断には、対象となる透かしの普及率、文章の条件、検出器の較正が必要だという話です。生成AI全般の利用率と、特定の方式の透かしがある割合も違います。
記事制作では、判定結果と制作記録を一緒に扱う
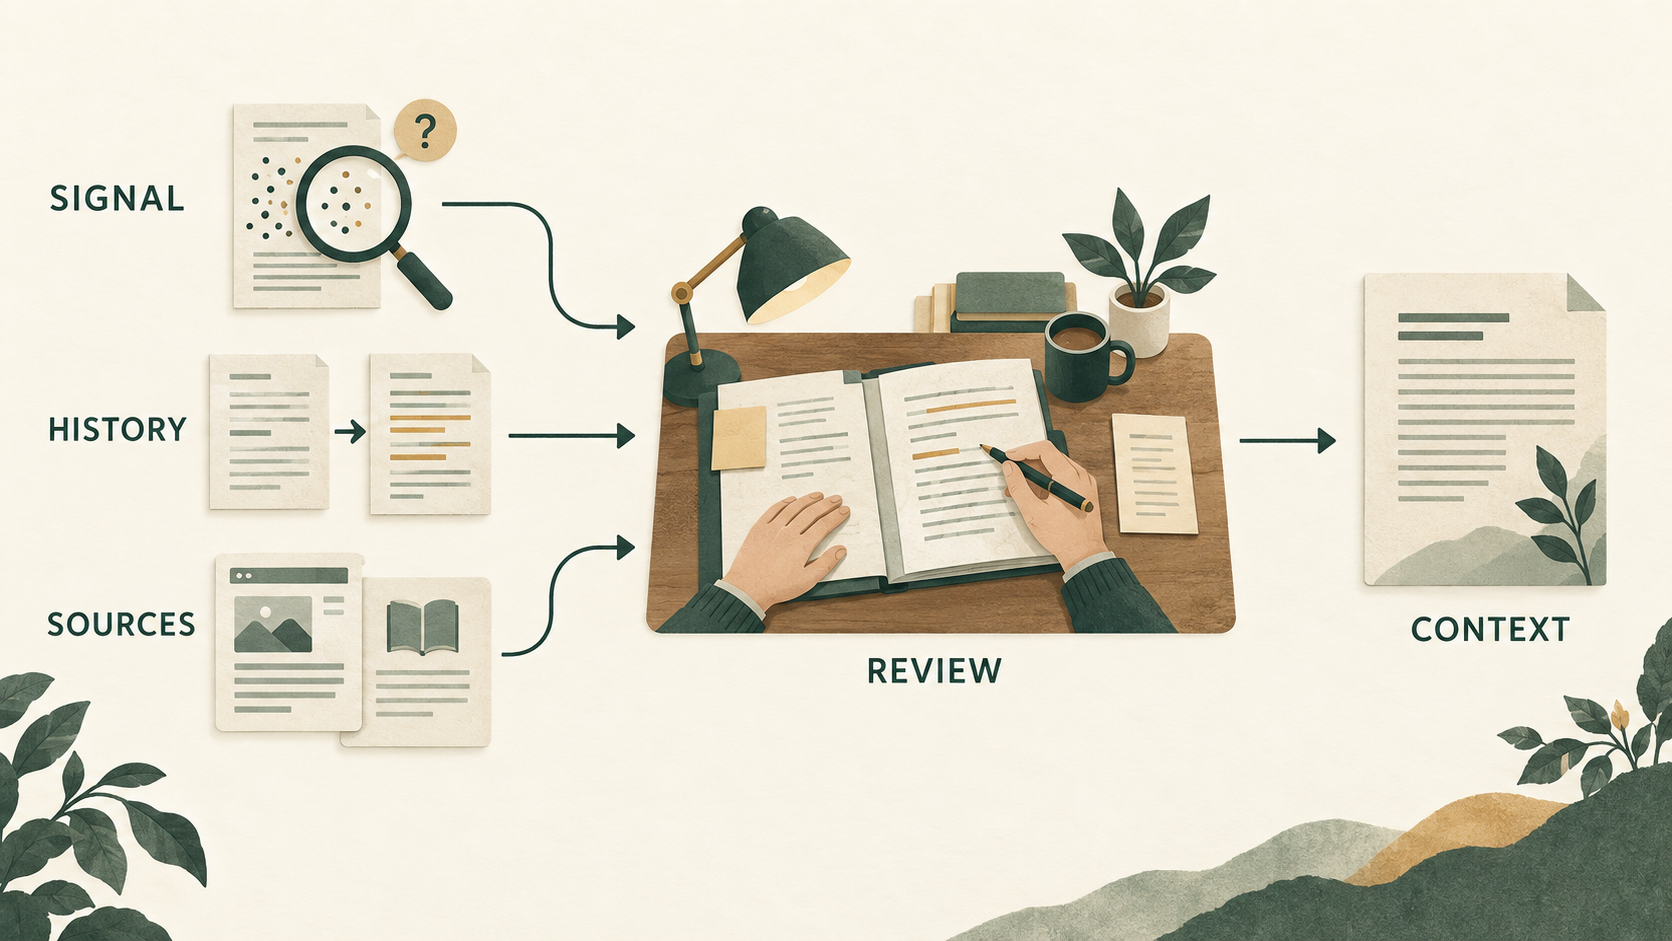
OpenAIは、透かしが示せるのは同社のシステムが文章の一部を生成・処理した可能性についての限定的な信号だと説明しています。人間がどれだけ考え、調べ、編集したか、所有権や責任が誰にあるか、内容が正しいかは、この信号からは分かりません。ユーザーや会話、プロンプトを特定するものでもありません。
AICompanyとして記事制作に取り入れるなら、検出結果を制作履歴に添える扱いが現実的だと考えます。参照した一次資料、下書き、編集差分、確認した数値を残しておけば、透かしとは違う角度から制作過程を説明できます。この記録を併用する運用は、今回の報告で効果が実証された手順ではなく、私たちの応用案です。
例えば、文章に陽性が出たら、すぐに無断のAI利用と決め付けるのではなく、どの方式の信号か、対象言語や長さは評価条件に合っているか、編集履歴と整合するかを確認する。陰性でも、人間だけが書いたという証明には使わない。そんな位置付けが合っています。
今すぐ誰でも使える万能な判定器ではない
10月5日の発表では、APIについては対象モデルの文章透かしを利用者が選択でき、標準ではオフとされています。EUの対象となるChatGPTとCodexの出力には、今後数週間で導入する予定です。全世界の全モデル・全出力に同時に標準導入されたという発表ではありません。
検出器の初期アクセスも、承認された研究者や専門機関に限定されています。公開記事で説明されているからといって、一般の投稿者がすぐに任意の文章を検査できる状態とは限りません。オープンソース化は予定として示されており、今回確認した技術報告は、動作する公開パッケージの提供を証明するものではありません。
規制への対応も今回の背景にありますが、個別の文章について何を表示すべきかという法的判断は、ここでは扱いません。この記事では、技術が何を観測しているのかに焦点を絞りました。
textGrainの価値は、生成時の信号と、失われる選択の自由度を具体的に結び付けたことにあります。そして、検出の限界を説明した点にも価値があります。制作履歴を補う道具として育つ余地はある。文章の真偽や、人間の仕事量まで肩代わりする道具にはしない。この区別を保つことが、文章透かしを使う側の第一歩になりそうです。
参照した一次資料
OpenAIの公式発表「Our approach to EU text provenance rules」(2026年10月5日)。検出率、同義語置換の比較、品質評価、導入範囲とアクセス制限はこの発表によります。
Xiang Liほかによる技術報告「textGrain: Entropy-Calibrated Watermarking for Language Model Text」(2026年10月5日、20ページ)。仕組みは第2節と第3節、数値計算と条件付きの保証は付録A、投機的サンプリングは付録B、既存研究との関係は付録Cを参照しました。