
AIに調査を頼む。検索ツールから数字が返る。AIはそれを読み、きれいな文章にまとめてくれる。ところが、その数字だけが間違っていたらどうなるでしょう。
「接続に失敗しました」と表示されれば、異常は見つけやすい。一方、いつもと同じ形式で返ってきた数字は、そのまま記事や判断の材料になりかねません。エラーが出ないから安心、とはいかないのです。静かな顔で間違えるツール、なかなか手ごわい。

10月7日に公開されたObada Kraishan氏の論文『Loud Failures, Quiet Failures』は、この差を実験しています。24の複数手順タスクで6モデルを動かした結果、明示的なエラーを問題として扱った割合は91.3%。もっともらしい誤答では58.8%でした。ただし、正常な結果に対しても26.8%で問題を報告しています。単に疑い深くすればよい、という話でもありません。
この研究の面白さは、AIが異常に気づくこと、次の行動を変えること、作業を立て直すことを別々に測った点です。数字の見方を押さえると、自動化のどこに検証を置けばよいかが見えてきます。論文本文(v1、IV-A・表IV)
「ツールが動く前提」の評価から、一度壊してみる評価へ
通常のエージェント評価は、利用できるツールが正常に動く環境で、目的を達成できるかを調べます。しかし現実では、通信が遅れたり、必要な機能が使えなくなったり、引数の名前が変わったりします。古いキャッシュが、正しい形のまま古い値を返すこともあります。
著者はBerkeley Function-Calling Leaderboardの複数ターン課題から、実行条件を満たす312課題を絞り、24課題を固定しました。ファイル操作、旅行予約、取引、車両操作などを含む16種類の領域の組み合わせです。実サービスへの操作ではなく、状態を持つPythonの模擬環境で実験しています。
故障は4種類。タイムアウト、ツールの消失、引数変更を模したエラー、返り値だけの改変です。最後の条件では、呼び出し自体は成功し、数値をずらす、リストから要素を抜くなどの変更を加えます。環境の内部状態は、正常に処理した場合のままです。
重要なのは、この「返り値だけの改変」です。データベースが壊れなくても、AIが読む値は間違う。作業結果の状態を見ている評価と、利用者に伝わる答えの正しさが食い違う余地があります。
基本実験は24課題×5条件×2回×6モデルの1,440試行。さらに1系列の2モデルに確認を促す指示を加えた480試行を行い、合計1,920試行です。故障条件で故障が発生しなかった試行を除くと、解析対象は正常条件を含む1,694試行。故障は開始直後にも起き、種類によって発生時点が違います。また、公開コードでは消失したツールはその試行中、利用できないままです。すべてが一時的な障害ではありません。方法(III-A~D・表II、III)、公開コード
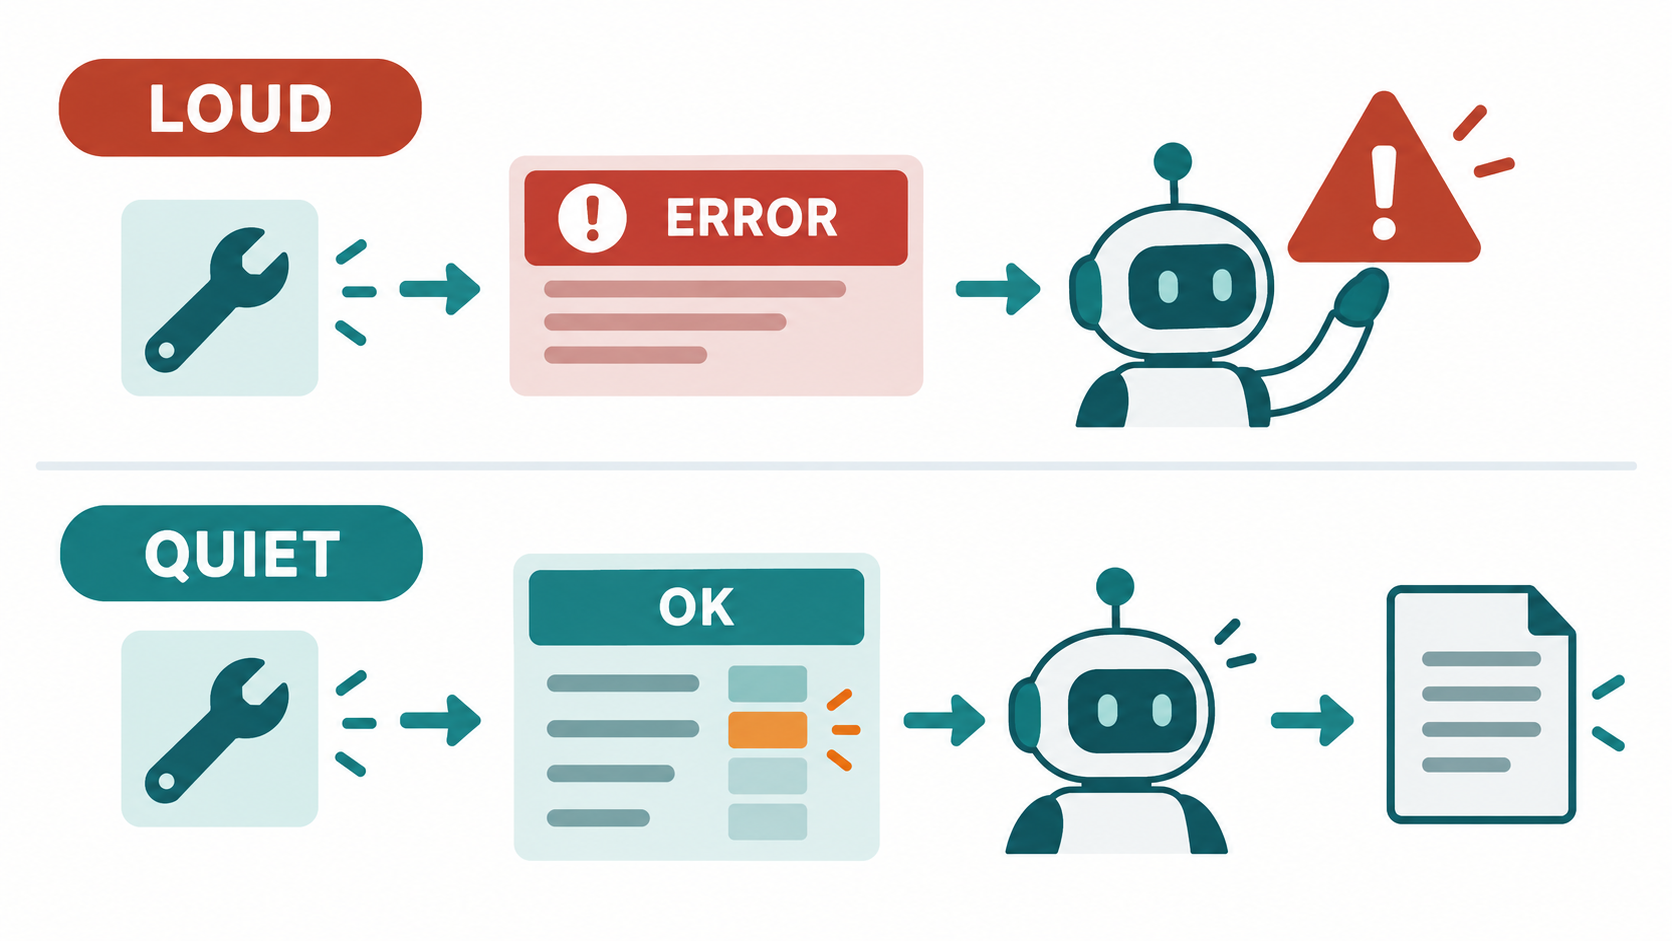
静かな誤りは、約4割で問題として扱われなかった
論文の「検知」は、AIの頭の中を測ったものではありません。ツールの結果と、その後のAIの発言を判定し、結果を問題として扱ったかを符号化しています。気づいていても発言しなければ、検知されなかった側に入る可能性があります。
| 条件 | 対象試行数 | 問題として扱った割合 | 95%信頼区間 |
|---|---|---|---|
| 明示的なエラー | 936 | 91.3% | 88.3~94.1% |
| もっともらしい誤答 | 374 | 58.8% | 45.7~71.2% |
| 正常な対象呼び出し | 306 | 26.8% | 17.8~36.5% |
表の出典は論文IV-A・表IVです。正常条件306試行は、正常条件全体384試行のうち、判定対象の呼び出しが実際に成功したもの。模擬環境が返した本物の認証エラーなどを、誤警報に混ぜないための区別です。
明示的なエラーと静かな誤りの差は32.5ポイント。静かな誤りの検知率は正常時の誤警報より高いものの、41.2%は問題として扱われていません。信頼区間も広く、どの業務でも58.8%になるとは読めません。
AICompanyでは公開された採点済みCSVを集計し直し、明示的エラー855/936、静かな誤り220/374、正常対象への問題報告82/306という分子・分母を確認しました。これは公開データの再集計です。モデルを再実行した再現実験や、判定ラベルそのものの独立検証ではありません。
よく考えることと、異常を見抜くことは別だった
評価対象はClaude Haiku 4.5、DeepSeek、Qwen3の3系列で、各系列の推論型と通常型を比較しています。推論型の設定は2,048トークンの思考予算、温度は1.0、ツール呼び出しは最大15回です。現在の全モデルを代表する調査ではありません。
同じ課題・故障・反復を対応づけた450組では、推論型は検知が9.3ポイント低い一方、次の行動を変える割合は10.4ポイント高くなりました。回復の差はマイナス2.4ポイントで、統計的に明確な差は確認されていません(p=0.512)。結果(IV-B・表V)
「推論型は頼れない」とまとめるのは早計です。系列別ではQwenの差が最も明確で、Claudeは統計モデルの置き方によって検知の差の有意性が変わります。DeepSeek-R1にはツール呼び出しを実行せず文章として書いてしまう挙動もあり、インターフェースとの相性が結果に影響しています。
それでも、実務への問いは残ります。行動が変わったから、異常を理解したとは限らない。長く考えたから、入力値を確かめたとも限らない。モデルの思考量と、必要な確認を行った証拠は分けて見たいところです。
「回復60.4%」は、正しく答えた割合ではない
静かな誤りの条件でも、回復率は60.4%でした。正常条件の基準値63.3%に近いので、影響は小さいようにも見えます。しかし、この回復率は正答率ではありません。
基準は、同じモデルが故障なしで実行したときの最終状態です。故障後の実行が、その基準の状態項目に完全一致すれば「回復」と判定されます。正常実行が目的を達成したとは限らず、二つの正常実行同士も全体では63.3%しか一致しません。本文の集計は確認指示を加えた条件も含み、指示なしの正常反復同士では58.3%です。
たとえば、参照した金額だけが間違い、AIがそれを説明文に使ったとします。書き込み後の状態は正常実行と同じでも、利用者には誤った金額が伝わり得ます。「状態が一致した」と「答えが正しい」は、ここでは別のものです。
ツール消失の回復率は39.9%で、正常基準から明確に下がりました。一方、他の条件で主解析の差が明確でなかったことは、無害の証明ではありません。引数変更はモデル差を加えた解析で有意になるなど、解析の置き方にも注意が必要です。定義(III-E)と結果(IV-C・表VI)
「毎回確認して」と頼むだけでは、この実験の差は埋まらなかった
追加実験では、ツールを使うたびに予想した結果かを短く確認するよう、システム指示を加えています。静かな誤りの検知率は60.6%から59.6%で、改善は確認されませんでした。
これは1系列の2モデルに対する一つの指示の結果です。すべての確認プロンプトが無効だという結論ではありません。著者も、単一出力を判定させる先行研究では改善が報告されており、作業途中で計画を持ち続ける状況とは条件が違うと述べています。追加実験(IV-D)
AICompanyの解釈では、確認の言葉を増やすだけでなく、何と照合するかを用意することが重要です。期待した注文ID、金額の関係、対象期間、読み直した保存状態。確認できる相手があって初めて、「確かめる」が具体的な動作になります。
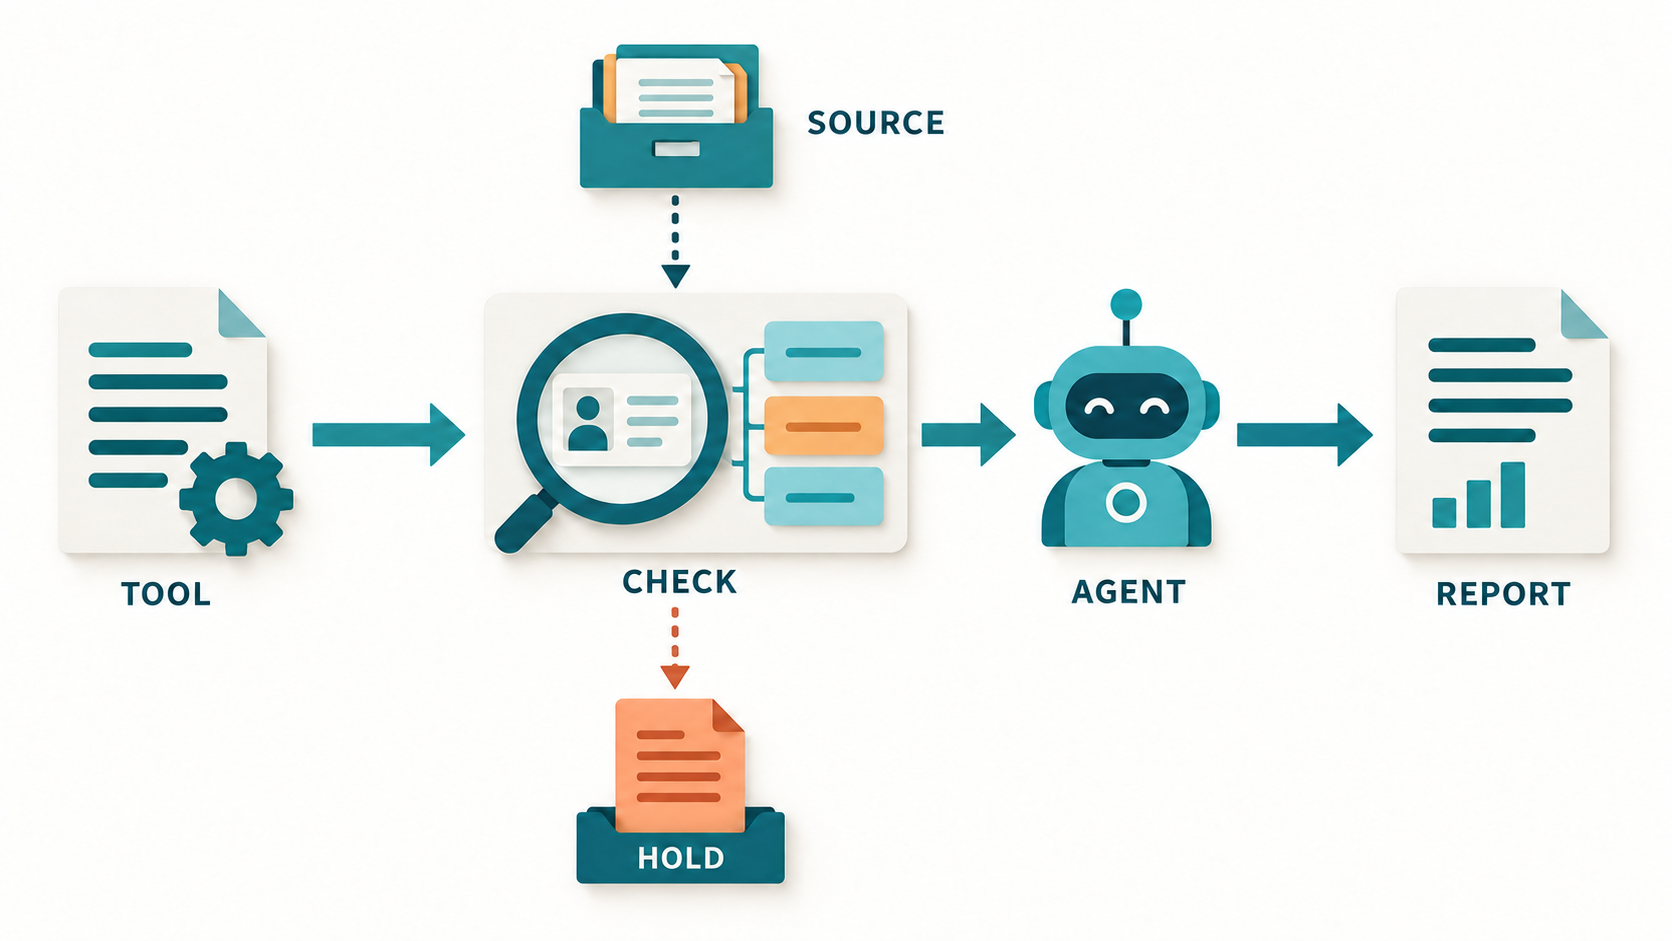
小さく試すなら、AIへ渡す手前で値の関係を確認する
次のPython例は、論文の手法を実装したものではありません。AICompanyが考えた、ツールの返り値を受け取る境界で行う最小限の検証です。仮の請求明細で、ID、金額の型と範囲、合計の関係を確認します。
from math import isfinite

def validate_invoice(record, expected_id):
    if record.get("id") != expected_id:
        raise ValueError("対象IDが違います")
    values = [record.get(k) for k in ("net", "tax", "gross")]
    if not all(type(v) in (int, float) and isfinite(v) and v >= 0
               for v in values):
        raise ValueError("金額の型または範囲が不正です")
    net, tax, gross = values
    if abs(net + tax - gross) > 0.001:
        raise ValueError("内訳と合計が一致しません")
    return record
この例を7ケースで実行しました。整合する明細は通過し、別ID、合計の不一致、非数、負数、文字列の金額は拒否しました。しかし、内訳と合計をまとめて間違えた明細は通過します。ここが大事です。内部のつじつまが合うことは、値が事実であることの保証にはなりません。
実際の請求処理なら通貨ごとの丸め規則や正確な数値表現が必要です。さらに、権限を持つ原本との照合、取得時刻の確認、書き込み後の読み直しなどを、業務の性質に合わせて追加する必要があります。この短い例で業務処理が安全になるとは考えないでください。
記事制作なら、数値と一緒に出典箇所・対象期間・母数を保持する。保存処理なら、成功応答を受けた後に、そのIDの状態を読み直す。取引データの分析なら、単位と時刻を照合する。これらは論文が効果を検証した改善策ではなく、結果を踏まえたAICompanyの応用案です。
この論文から持ち帰りたいこと
研究には限界があります。24の模擬課題、6モデル、4種類の故障に限られ、故障の発生率や時点は条件間で異なります。検知は判定モデルに依存し、著者1人による手作業との二値判定の一致度はκ=0.69でした。15回の呼び出し上限も回復の機会を制限しています。日本語の業務や、実際の外部サービスで同じ結果になるかは未検証です。
そのうえで、この研究は自動化の設計を考えるよい材料です。異常に気づく能力と、作業を進める能力を分ける。エラー表示だけでなく返り値を確認する。最終状態だけでなく、利用者へ伝えた内容も確かめる。
AIが流暢に続きを書けるほど、入力の間違いも流暢に運ばれてしまいます。便利な自動化を育てるには、「うまく返ってきた」の次に、「何と照合したか」を一つ置く。その小さな境界を考え直す価値のある論文です。
出典:論文v1、arXivの書誌・公開履歴、著者のコード・データ(確認時点の固定コミット)。論文は10月7日公開、確認したコードは10月6日03:03 UTCのコミットで、今回新たに公開されたコードとしては扱っていません。