
同じ資料を読み、同じ設定を直し、同じ実験を終えた。ところが、使ったツールの名前を変えただけで点数が下がる。仕事は変わっていないのに、成績表だけが悪くなるのです。
10月8日に公開された論文「TRACE: Diagnosing Verifier Brittleness in Agentic Evaluation」は、そんな採点の落とし穴から出発します。著者はPrime IntellectのRadhika Gaonkar。新しいAIの性能を競う論文ではなく、性能を測る側をどう点検するかという研究です。

ただし、話は「ベンチマークは信用できない」で終わりません。公開ベンチマークの追加実験では、名前や表示形式を穏当に変えても、大半の条件で平均点の大きな変化は確認されませんでした。一方、まったく同じ条件でやり直すだけでも、合否は動く。TRACEの面白さは、点数の変化にすぐ理由をつけず、その理由を調べる手順を用意したところにあります。
点数は、仕事そのものではない
AIエージェントは、文章を返すだけでなく、ファイルを読み、ツールを呼び、データを書き換えます。その仕事を採点する仕組みが「検証器」です。完成した状態を調べるもの、必要な操作を行ったか確認するもの、別のAIに記録を読ませるものがあります。
どれも便利ですが、採点項目は仕事の目的を完全には表せません。例えば「確認ツールを呼んだ」ことを評価しても、確認した内容が正しいとは限らない。逆に、同じ確認をするツールへ名前を変えたら、古い名前しか認識しない採点器が失点させるかもしれません。
この区別は、AIを更新した日の比較でも大切です。前より点数が低かったとき、モデルが悪くなったのか、入力の見せ方が変わったのか、採点条件が違うのか。その数字だけでは判断できません。成績表にも、採点ミスという人間味があります。うれしくない人間味ですが。
TRACEは、同じ記録をもう一度採点する
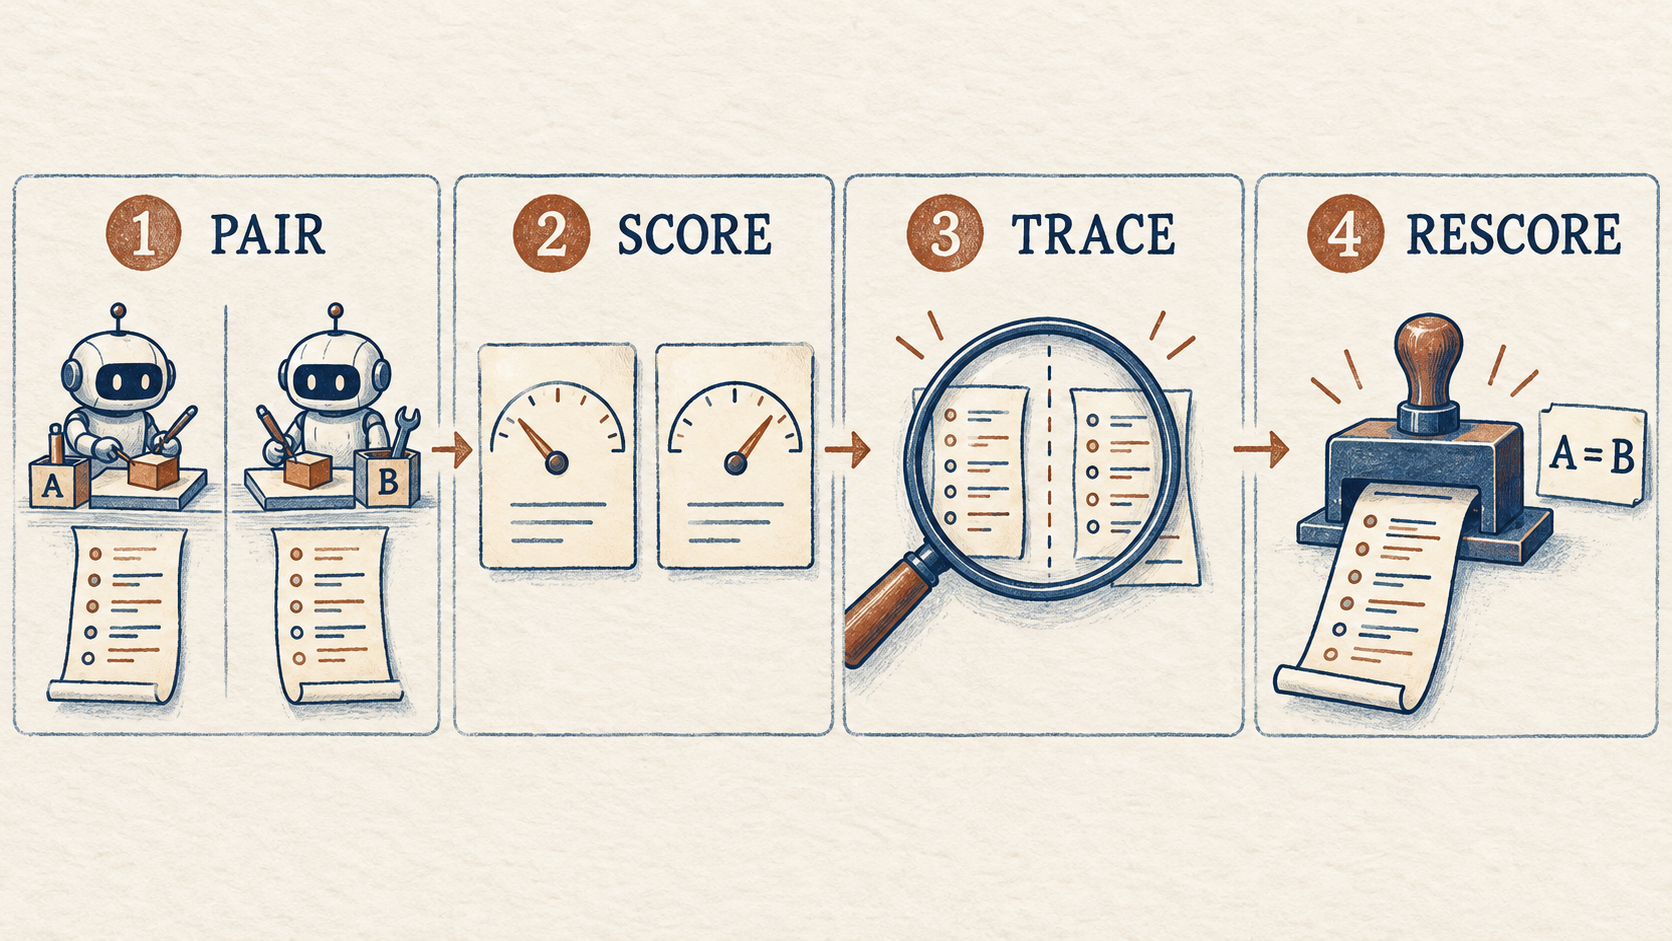
TRACEの中心は四つの段階です。まず元の条件と、一部分を変えた条件で対応する試行を行う。次に点差を見る。続いて操作、引数、観測、最終状態の記録を比べる。そして採点の問題が疑われたら、AIを動かし直すのではなく、保存済みの同じ記録を修正した採点規則で評価します。
ここで、最後の段階が効いてきます。AIを再実行すると、別の行動を選ぶ可能性がある。それでは、採点器だけを直した効果なのか分かりません。同じ仕事の記録を固定したまま採点だけを変えれば、少なくともその記録に対する採点の影響を確かめられます。
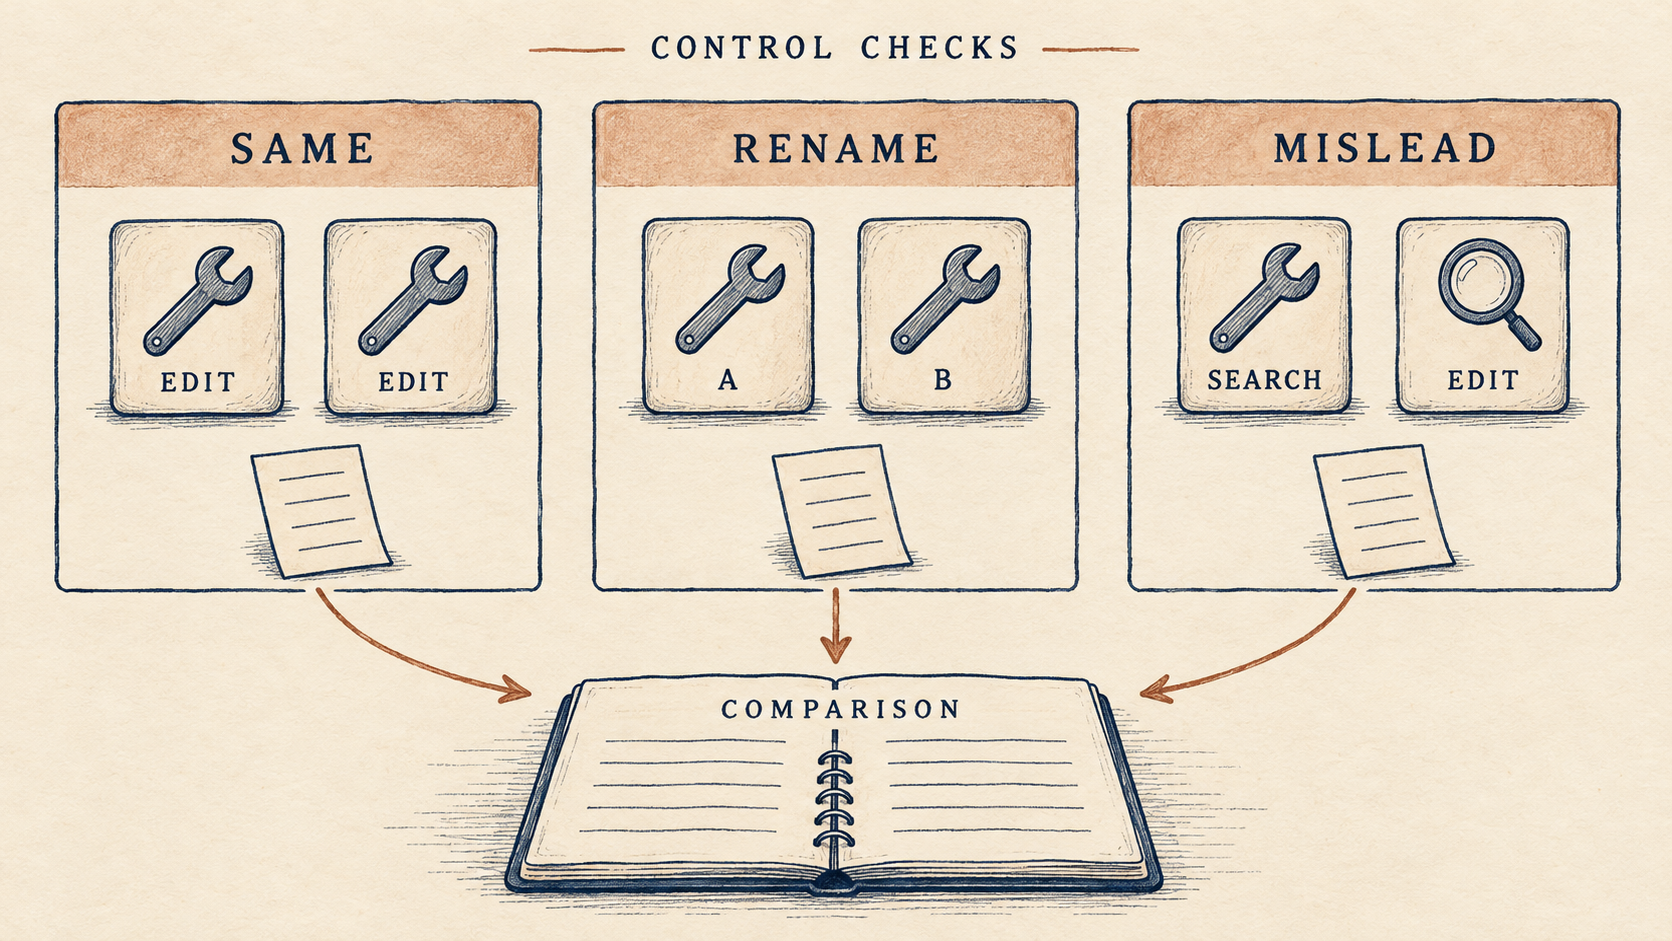
研究はさらに二つの比較を加えます。一つは条件をまったく変えない再試行です。普段どの程度、結果が揺れるかを測ります。もう一つは、結果を変えるはずの変更です。差が出ないという結論には、そもそも実験が差を検出できることも必要だからです。
人工的な課題では、採点の欠陥と行動の失敗を分けられた
最初の実験はResearchOpsEnvという25個の合成課題です。設定修正、模擬実験、ログ確認などを、三つの決められたプログラムが実行します。学習済みAIの実力テストではありません。原因があらかじめ分かる環境で、診断手順がその原因を見つけられるかを確認する実験です。
論文の保存版では、丁寧に仕事を行うcareful方策のツール名を変えると、平均点が0.250低下しました。操作と観測、シミュレーター上の仕事の品質は同じです。採点が必要な五つのツールを名前で数えていたため、別名を使うと点を与えられませんでした。
別名を元の名前へ対応づけ、同じ記録を再採点すると、点差は0.000になりました。一方、名前が変わったときに不十分な報告へ切り替わるoverfit方策では、修正後も0.130の差が残ります。こちらは実際に行動が悪くなっているため、名前の読み替えでは救えません。
点差が小さいことにも注意が必要です。ほとんど仕事を達成しないshortcut方策は、元の条件でも変更後でも低得点なので、平均点差が小さい。差の小ささだけを「頑健さ」と呼べば、安定して失敗する方策を高く評価してしまいます。差と達成状況を一緒に見る必要があります。(論文§3、図2、表2)
本物のAIでは、再試行の揺れが無視できない
次の舞台は、ユーザーとの会話とツール操作を評価するτ²-benchです。小売と航空の課題を、四つのLLMエージェントで試しました。ユーザーもシミュレーターなので、条件を変えて再実行すると、その後の会話や操作も変わり得ます。ここでの点差は、AI、ユーザー、環境、採点を含む全体の変化です。
初回の30課題では、一つのエージェントがツールの別名で良くなる結果が出ました。ところが追加試験では、その改善は再現しませんでした。研究はその結果も残し、最初の見栄えのよい数字を主役にしていません。
大きな追試は、航空・小売の利用可能な158課題を対象に各条件を三回実行し、主な判定には以前の試験で使っていない88課題を使います。ツールの中身を保った改名と、値を保ったJSONの表示変更では、四エージェント×二変更の八組中七組が、あらかじめ決めた±0.10の範囲内で同等と判定されました。八組をまとめた多重比較の補正後は六組です。
これは「完全に同じ行動」や「影響ゼロ」を意味しません。許容幅0.10に対する平均報酬の判定です。残るQwen3.8 Flashの表示変更は、同等とも異なるとも決められない結果でした。
一方、ツール名を別の機能の名前と入れ替えて、名前だけが誤解を誘う変更では、全四エージェントの報酬が0.196〜0.437低下しました。説明文と引数の仕様は正しいままでも、名前が判断を妨げます。中立的な別名への変更とは別の試験です。
さらに、元の条件をそのまま再実行しても、三エージェントでは14.7〜16.3%、Lagunaでは35.6%の試行で合否が反転しました。更新前に一回、更新後に一回だけ試して「改善した」と喜ぶには、かなり大きな揺れです。(論文§4〜5、図4、付録表6)
| 確かめたいこと | TRACEでの比較 | 分かる範囲 |
|---|---|---|
| 条件変更で点数が動くか | 元の条件と変更後の対応試行 | システム全体への影響 |
| AIの仕事が変わったか | 操作・引数・結果の記録比較 | 行動や状態の相違 |
| 採点側に原因があるか | 同じ記録を修正規則で再採点 | その記録への採点規則の影響 |
| ただの揺れではないか | 変更しない再試行との比較 | 通常の変動を超える差か |
安定した採点AIでも、違うものを測る
もう一つ、見落としにくい結果があります。118個の固定された実行記録を、GPT-6.1 SolとClaude Opus 5.5が採点する実験です。各表示条件で三回ずつ採点し、表示変更による判定の不一致を、同じ入力を繰り返したときの揺れと比べています。
表示を変えた影響は、その繰り返しの揺れを超えて確認されませんでした。それでも、二つの採点AIの判定は約57%で食い違います。ベンチマーク本来の結果報酬との一致はClaude側が95%、GPT側が38%。論文によればGPT側は、達成した結果よりも、一つのターンで複数ツールを呼ぶといった手続きに異議を唱えることが多くありました。
ここで95%を「正解率」と読んではいけません。本来の報酬も一部をAIが採点しており、絶対的な正解ではないからです。手続きを守るべき仕事もあります。重要なのは、何を成功とするかを決めずに採点器を取り替えると、比較の意味まで変わるという点です。同じ答えを繰り返す安定性と、測りたいものを測る妥当性は、別々に確かめます。(論文§5、付録表8)
小さな実験:名前が変わると25点落ちる採点器
仕組みを手元で確かめるため、AICompanyでは次の説明用コードを実行しました。論文の実装ではなく、ツール名だけに依存する採点の弱点を示す例です。0.75の固定部分は仮の点数で、仕事の正しさを検証した値ではありません。
expected = {"read", "edit", "run", "check", "submit"}
aliases = dict(zip(
    ["fetch", "patch", "execute", "inspect", "send"],
    ["read", "edit", "run", "check", "submit"]
))
def score(actions):
    return 0.75 + 0.25 * len(set(actions) & expected) / len(expected)

original = ["read", "edit", "run", "check", "submit"]
renamed = ["fetch", "patch", "execute", "inspect", "send"]
normalized = [aliases.get(a, a) for a in renamed]
print(score(original), score(renamed), score(normalized))
実行結果は1.0、0.75、1.0でした。別名を戻せば、同じ操作へ同じ点を与えられます。ただし、勝手に異なる機能を同じものと見なせば、今度は誤りを隠します。読み替え表は、入力、出力、副作用まで同じであることを確認して作る必要があります。この短いコードには、その確認機能はありません。
公開コードについても確認しました。参照したコミットは4e42d6a70832eeb0c2a2caa0062524ef0559995eで、更新は8月です。10月8日に新しい論文が出たのであって、このコードが同日に初公開されたとは扱いません。
現行の採点処理はすでにツールの別名を正規化しています。そのコードで25課題、三方策、七条件、三つのseedラベルの計1,575件を実行すると、carefulの改名による点差は0でした。決められたプログラムの実行なので、新しいLLMへの問い合わせは行っていません。
これは論文の保存版で得た0.250を再現した結果ではありません。公開READMEも、現在は以前の単一モデル・164課題のτ²分析を説明しています。論文の四モデルの追試や採点AIの大規模比較を、この公開リポジトリだけで再現できたとはしていません。
自分のAIを比べるなら、先に成功条件を固定する
AICompanyとしての応用案は、AIを更新する前に、小さな評価用の仕事と成功条件を固定しておくことです。例えば記事制作なら、文章の読みやすさ、出典との一致、必要な画像の存在、公開された本文の状態を分けて記録します。流暢な完了報告があるだけで、公開成功にしない。採点項目を変えたら、古い記録にも新しい規則を適用して比較します。
コーディング支援でも、必要なテストが通ること、変更範囲、許可された操作を、それぞれ別に見ます。手続きの違反を減点するなら、その規則を比較前に決める。評価後に気に入らない操作だけを減点すれば、性能比較ではなく後づけの採点になります。
何も変えない再試行も残しておけば、更新による差と通常の変動を比べられます。回数や許容幅は仕事の重要度に合わせて決める必要があり、論文の三回や0.10をそのまま万能の基準にするものではありません。こうした運用の効果を、今回の研究が記事制作や日常開発で実証したわけでもありません。
TRACEで分かること、まだ分からないこと
25課題の合成環境は人が設計し、方策は意図した修正を知っています。現実のAIがどれだけ採点の抜け道を発見するか、実務で何%失敗するかを測ったものではありません。
公開ベンチマーク側も、主な追試は航空と小売、四エージェント、二種類の表示変更です。一部には内部提供のモデルがあり、欠損した試行もランダムとは限りません。別の分野、日本語業務、長期の本番運用まで同じ結果が成り立つかは未確認です。採点AIの一致率にも、人間が確定した正解ラベルという裏づけはありません。
修正した読み替えも、試した一つの対応関係に対する結果です。新しい種類の変更へどこまで通用するか、評価を報酬にして学習を続けたときに何が起きるかまでは、検証していません。
それでも、手元へ持ち帰れる考え方ははっきりしています。点数が変わったら、仕事の記録を見て、同じ記録を採点し直し、変更なしの揺れと比べる。AIを信用するために、まず採点の意味を確かめる。TRACEは、その地味で大切な作業を研究の主役にした論文です。
参考:論文・書誌情報、本文と付録v1、参照した公開コード。数値は原著の報告であり、AICompanyが独立に確認したのは現行公開コードの合成試行と説明用コードです。プレプリントの結果として読み、研究の追試や改訂で結論が変わる可能性を残します。