
仕事を最後まで終えた人に「合格」とだけ伝える。これでも学びにはなりますが、途中のどの判断が役に立ったのかは、なかなか見えてきません。
道具を使うAIの学習にも、似た問題があります。検索し、ページを読み、操作して、最後に成功か失敗かが返ってくる。その間には、次の判断を学ぶ材料がたくさん残っています。

今回取り上げるCoPEは、成功した実行記録から「この時点の後に、どんな行動が続いたか」を取り出し、通常の強化学習と一緒に学ばせる方法です。別の予測専用モデルを追加せず、同じ言語モデルで行動と予測を担います。
ただし、成功例を増やせば何でもよくなるわけではありません。論文では平均成績が上がる一方、航空予約の課題では成績が下がりました。理由を追うと、「成功」の集め方そのものが、AIの行動を偏らせることが見えてきます。
最後の合否だけでは、途中の判断を教えにくい
AIエージェントは、環境から受け取った情報を見て、一つの行動を選びます。操作結果を受け取り、また次の行動を選ぶ。この繰り返しを一つの実行記録にしたものを、論文では軌跡と呼びます。
たとえば買い物なら、商品を探す、条件を確認する、別の候補と比べる、購入対象を選ぶ、という流れです。最後の成功だけを評価に使うと、その間の判断の違いを学習に生かすのが難しくなります。
CoPEが比較するGRPOは、同じ課題への複数の試行を相対的に評価し、よい行動を増やしていく強化学習の方法です。CoPEはこの学習を土台に、行動の続きを予測する追加の学習を組み合わせます。
従来の予測対象には、途中の成功見込みや、次に返る画面・ログなどがあります。しかし、画面やログは長く、判断に不要な情報も混じります。そこで著者らが着目したのが、実際に実行された行動です。環境の応答全文より短く、次に何をするかという判断にも直接つながります。
CoPEは、成功した記録を複数の地点から読み直す
仕組みは、大きく三つに分けると理解しやすくなります。
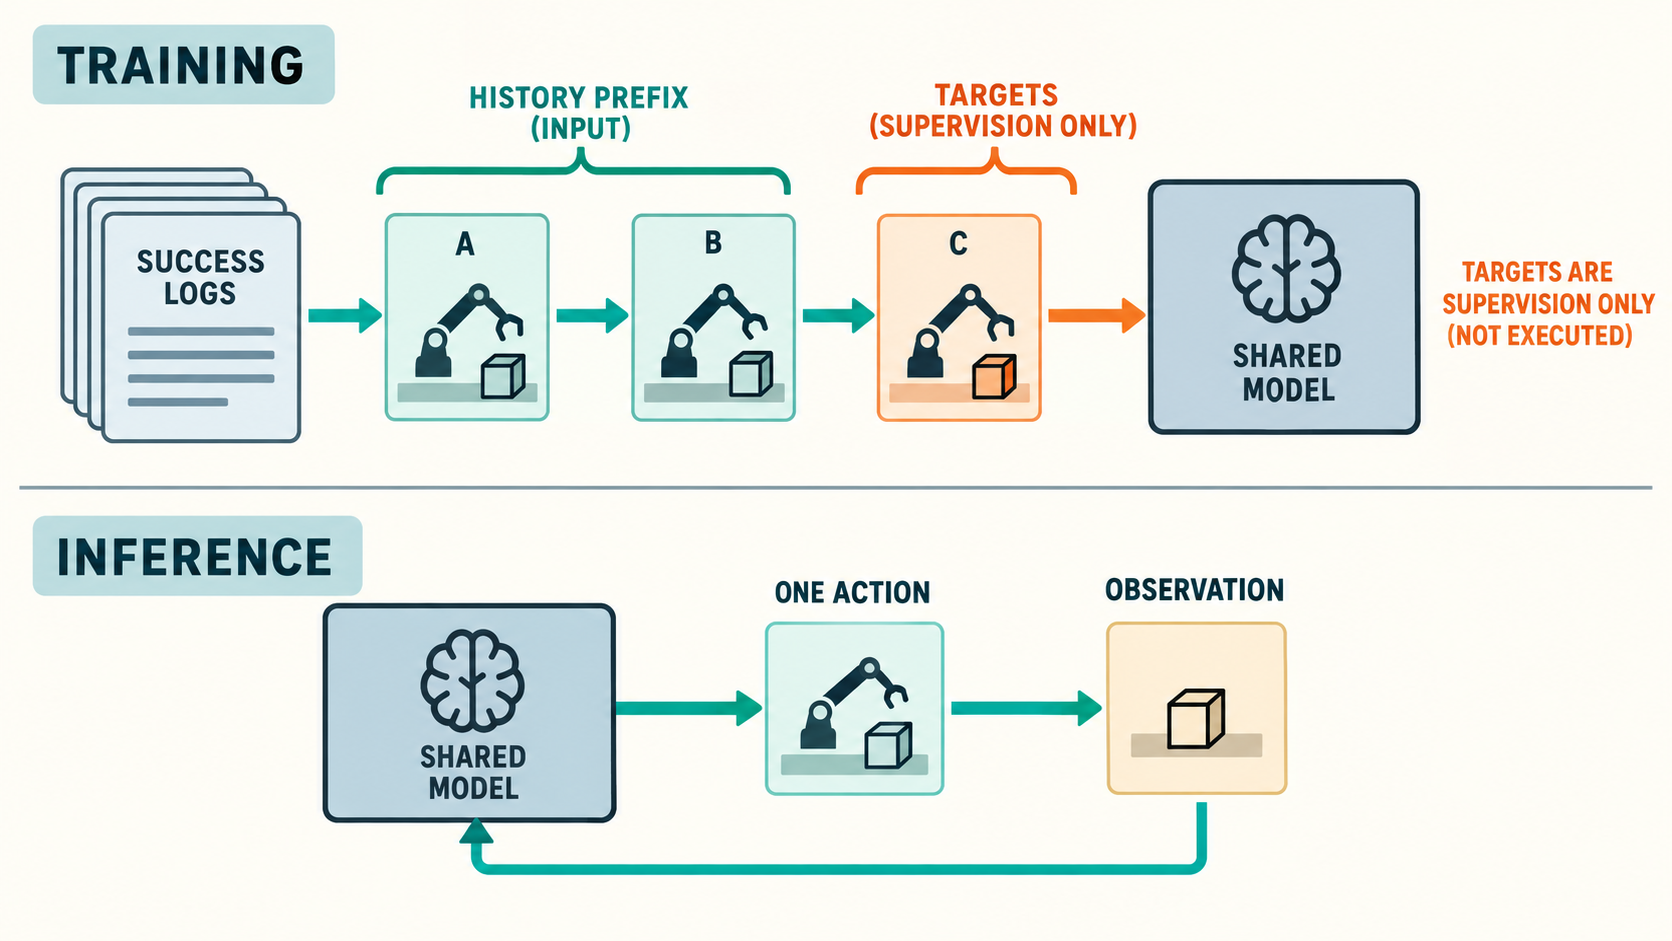
まず、現在のモデルで課題を実行し、成功した記録を選びます。次に、その記録の各時点について、その時点までの履歴と、そこから実際に続いた行動列を組にします。最後に、履歴から行動列を予測する学習を、GRPOと同じモデルに加えます。
重要なのは、未来の操作結果まで入力に入れるわけではない点です。予測に使う入力は、その時点までに見えていた履歴です。後で実際に起きた行動の並びは、答えとして使います。
一つの行動は、直前の履歴からも、少し前の履歴からも予測対象になります。同じ判断を異なる距離から学ばせることが、論文の中心的な発想です。著者らは、これを複数の時間幅の予測が同じモデルの中に取り込まれる働きとして分析しています。
学習時には、成功数が増えただけで予測側の学習が強くなりすぎないよう、同じ課題の成功記録の数で重みを調整します。単純に成功例を全部足すだけでは、強化学習との釣り合いが崩れるためです。
利用時の動きも押さえておきたいところです。CoPEは、その場で未来の行動列を生成して、まとめて実行する仕組みではありません。予測の学習は訓練時に行い、利用時は一つ行動して結果を見て、次を選びます。「先を学ぶこと」と「先まで一気に操作すること」は別です。
実験では何が改善したのか
論文は、ALFWorld、ScienceWorld、WebShop、τ²-bench、AppWorldの五つで評価しています。主なモデルはQwen2.5-7B-Instructで、AppWorldには14B版を使っています。Qwen3-8Bでの追加検証もありますが、あらゆるモデルで同じ効果が出ると示した研究ではありません。
以下は、論文内で同じ設定のGRPOとCoPEを比較した代表値です。すべて成功率で、改善幅はパーセントポイントです。
| 評価対象 | GRPO | CoPE | 変化 |
|---|---|---|---|
| WebShop | 64.5% | 77.0% | +12.5ポイント |
| ScienceWorld | 64.5% | 72.5% | +8.0ポイント |
| τ²-bench 全体 | 27.5% | 28.7% | +1.2ポイント |
| τ²-bench 航空 | 26.2% | 16.2% | -10.0ポイント |
| AppWorld 通常 | 41.67% | 55.36% | +13.69ポイント |
| AppWorld 難問 | 18.71% | 22.54% | +3.83ポイント |
出典は論文のTable 1、2、3です。τ²-benchは各課題を4回評価した平均で、全体値は三つの領域の単純平均です。他の評価と集計方法まで同じではありません。また、AppWorldの既発表手法には課題集合や手順の違いがあるため、ここでは著者らの同条件の比較に絞りました。
ScienceWorldでは、部分的な進捗を表す平均スコアも報告されています。こちらは52.8から53.4で、成功率の64.5%から72.5%とは別の数値です。どちらも「性能」とだけ呼ぶと、改善の大きさを取り違えてしまいます。
学習効率については、ScienceWorldで所定の性能水準に達するまでの学習ステップが、GRPO比で最大約2倍効率的だったと報告しています。これは、その実験での到達目標に対するサンプル効率です。推論が2倍速くなる、GPU費用が必ず半分になる、という意味ではありません。
予測を学習する追加処理自体にも費用はかかります。同実験では、その追加処理が平均でステップ時間の11%相当を占める一方、実行記録が短くなる効果を含めたステップ全体の時間は9%減ったとされています。この測定も、別の環境やモデルの費用にそのまま当てはめることはできません。
成功例だけを集めると、なぜ拒否が増えるのか
この記事で特に注目したいのが、航空予約の失敗分析です。
航空の課題には、依頼を断り、データベースを変更しないことが正解になるものがあります。論文によると、その割合は38%。小売の4.4%より大きくなっています。
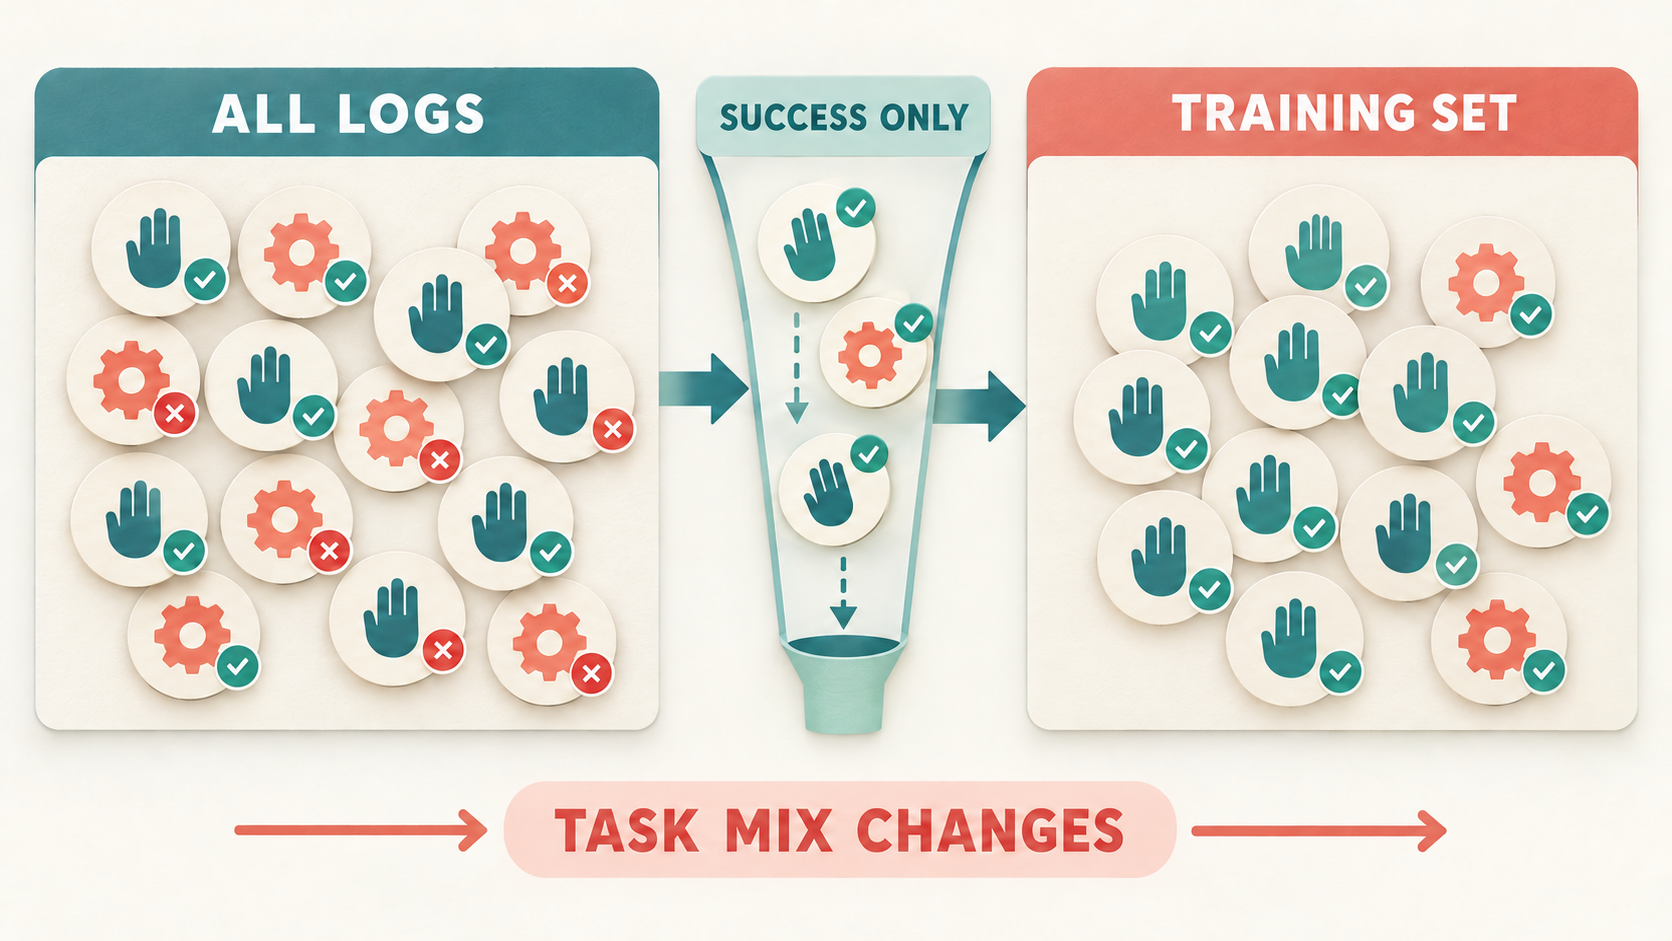
学習初期には、こうした変更不要の課題の方が成功しやすくなりました。その結果、成功した記録だけを集めると、拒否の事例が多く入ります。ところが、拒否すべき依頼と、正しく処理すべき依頼は、細かな条件以外は似ています。予測の学習が拒否を広げてしまい、本来は操作すべき課題まで断る。すると操作の成功例がさらに減る、という偏りが生じます。
これは「拒否は悪い」という話ではありません。必要な拒否は正解です。問題は、成功例の中で簡単な課題が過剰に代表され、行動が必要な課題を学ぶ材料が薄くなることです。
成功した実行記録の中にも、遠回りや、後から回復できた誤操作は残ります。成功というラベルが付いたからといって、その途中の全行動が最善だったことにはなりません。論文でも、成功行動をそのまま模倣する比較条件は、ScienceWorldでGRPOより成績が下がっています。
手元のログで、偏りだけを確かめてみる
CoPEの訓練を動かすには、モデルの重みを更新できる環境と、繰り返し課題を実行できる仕組みが必要です。普段のチャットに「先を考えて」と書くだけで同じ方法を再現できるわけではありません。
一方、成功ログの偏りを調べる考え方は、小さく試せます。以下はAICompanyが用意した架空の例です。論文の実験結果でも、学習コードでもありません。
logs = [
    {"kind": "refuse", "success": True},
    {"kind": "refuse", "success": True},
    {"kind": "act", "success": True},
    {"kind": "act", "success": False},
    {"kind": "act", "success": False},
    {"kind": "act", "success": False},
]
wins = [row for row in logs if row["success"]]
for kind in ["refuse", "act"]:
    before = sum(row["kind"] == kind for row in logs) / len(logs)
    after = sum(row["kind"] == kind for row in wins) / len(wins)
    print(kind, round(before, 3), round(after, 3))
拒否は全記録では約33%なのに、成功記録だけでは約67%になります。操作は約67%から約33%へ減ります。成功例だけを残すという選別だけで、学習材料の構成が変わりました。
ここからがAICompanyの実務への応用案です。記事制作やコード修正のログを次の改善に使うなら、成功件数だけでなく、課題の種類ごとの件数と成功率を並べるとよさそうです。「公開を見送る」「作業を止める」「実行して仕上げる」では、達成すべきことが違います。同じ成功箱に入れる前に、その違いを見える形にしておく必要があります。
ただし、この集計だけで偏りを解消できるわけではありません。種類の分け方や再配分が効果的かは、別の課題集合で確かめる必要があります。
公開実装を使う前に、論文の条件と照合したい
公開リポジトリも確認しました。今回確認した版は、2026年10月15日のコミット bf5de86bbedeb88e0d436435c80b2bc373fabf15 です。
ここには注意点があります。論文の予測幅Kは「現在から何手先までか」を表し、K=2なら現在の行動を含めて最大3行動です。一方、確認した実装のkは行動数として説明されています。記号だけを合わせると、予測対象の長さがずれる可能性があります。
さらに、航空予約環境の運用文書には、部分的な達成にも報酬を与える設定が記載されています。論文の比較実験は、終端の成功を二値の報酬として使うと明記しています。公開コードがあることと、その初期設定で論文の表を再現できることは、分けて考える必要があります。
AICompanyでは、論文全文、公開実装の該当部分、数値の差分と上の小例を確認しました。モデルの訓練や推論、五つの評価全体の再実行は行っていません。費用や成功率を独立に再現したという主張はしていません。
学ぶべきは、成功の数より成功の中身
CoPEの新しさは、成功を最後の点数だけで使わず、その途中に残った行動の続きまで学習材料にしたことです。追加の予測モデルを持たず、利用時には一手ずつ動く設計にも、実装上の魅力があります。
同時に、航空予約の結果は、その学習材料が何を代表しているかを問い直します。成功例が増えていても、簡単な課題に偏っていれば、必要な行動を学べるとは限りません。
AIを改善するときに見たいのは、合格印の数だけではなく、その合格がどんな仕事から生まれたか。CoPEは、効率化の提案と一緒に、その確認の大切さも示しています。
一次資料
本文の性能値と失敗分析は著者らの報告です。ログ集計の例と記事制作・コード修正への応用は、AICompanyによる説明と提案です。図は論文の図版を転載せず、仕組みを説明するために独自に制作しました。