
AIに仕事を任せたい。でも、社内の文書を毎回外へ送りたくはない。手元で動かすと遅いし、小さいモデルでは道具の使い方が頼りない。この板挟みに、Liquid AIが新しい選択肢を出してきました。
10月13日に公開されたLFM2.5-24B-A2Bは、総パラメータ数240億の推論モデルです。ただし、次のトークンを作る際に動くのは、その一部。公開モデルカードの詳しい値は24.0B総数、2.45B activeです。名称や発表の「2B」は短く表した数字で、厳密な仕様とは分けて読みたいところです。

面白いのは、単に文章を速く書く方向ではなく、考え、道具を呼び、結果を読み直すエージェント向けに仕上げていること。発表値ではツール利用や指示への追従に強みがある一方、コード修正やブラウザ作業で常に勝つわけではありません。手元の助手に向く仕事を、数字の中から見つけていきましょう。
小さい計算量と、小さい保存容量は別の話
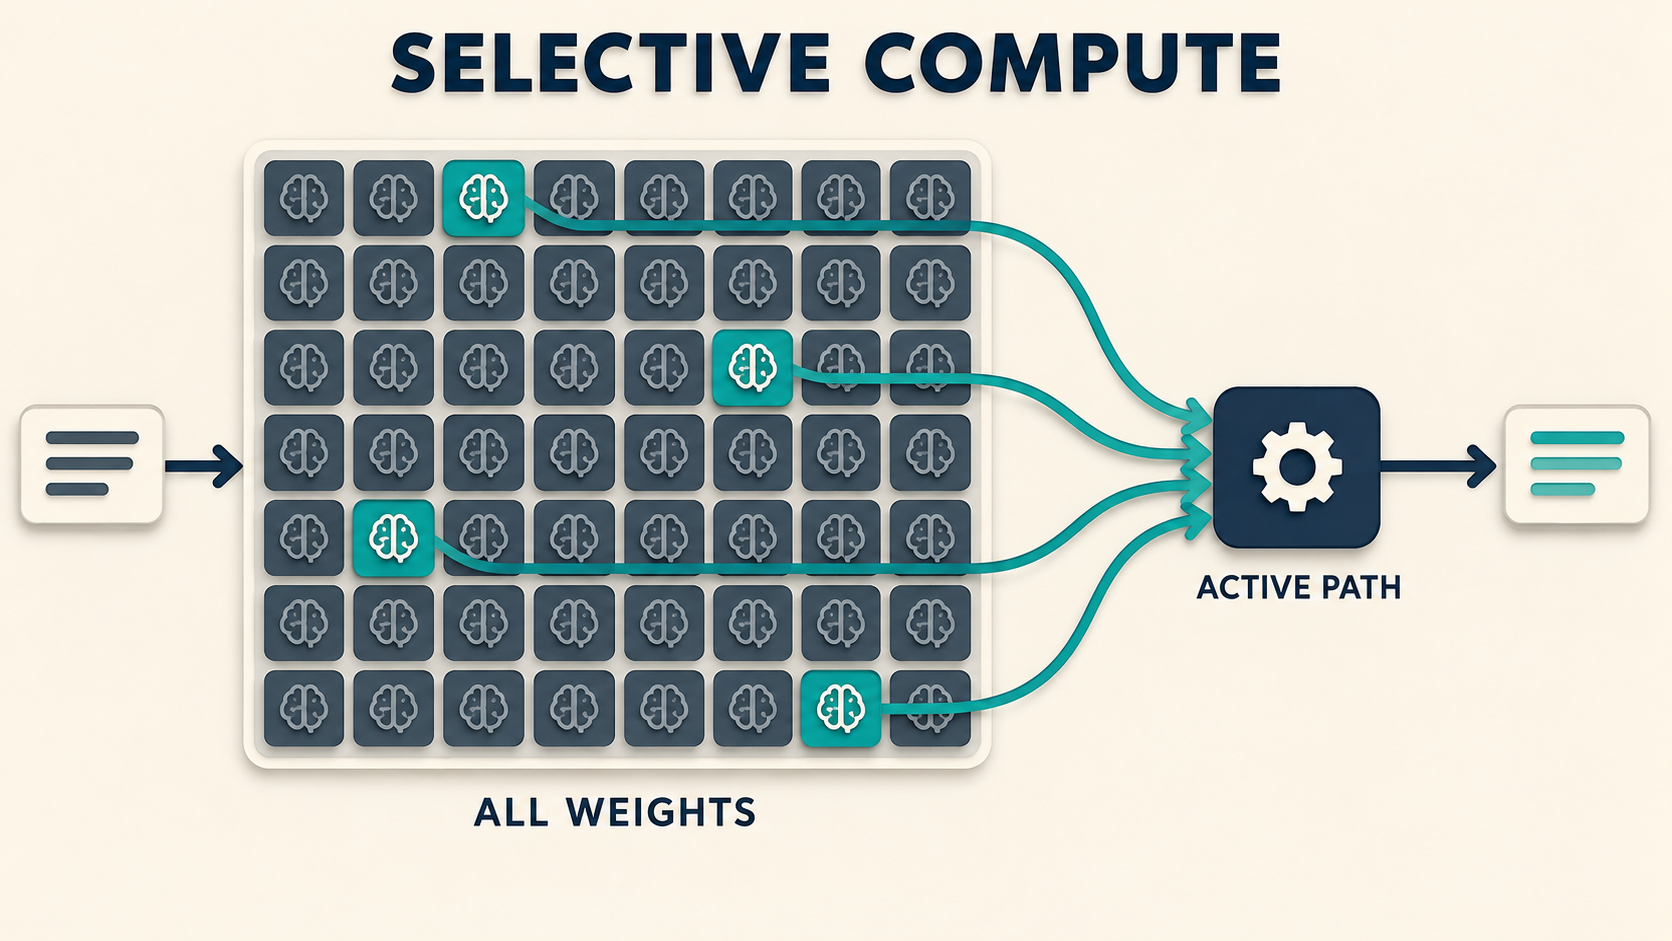
このモデルはMoEという仕組みを使います。複数の専門家に相当する計算ブロックを用意し、入力に応じて一部を選ぶ方式です。公開設定では、MoEブロックごとに64個の専門家があり、トークンごとに上位4個を選びます。
64人の厨房から、その注文に必要な4人へ仕事を回す感じです。ただし、厨房全体が4人分の広さになるわけではありません。選ばれない専門家の重みも、モデルの一部として存在します。
つまり、activeが小さいことは計算量を抑える材料にはなりますが、「2Bモデルと同じメモリで動く」という意味ではありません。総重量、数値の保存形式、会話履歴の長さ、実行環境を合わせて見る必要があります。
たとえば、240億個の値をすべて16ビットで保存するだけなら、単純計算で480億バイト、約44.7GiBです。4ビットで保存できたと仮定すると120億バイト、約11.2GiB。これは重みだけの算術例で、実際の量子化ファイルの大きさでも、起動に必要なメモリでもありません。補助情報、作業領域、会話のキャッシュなどは別に加わります。
同じ骨格に、長い文脈と推論の訓練を加える
LFM2.5は前世代LFM2-24B-A2Bの基本構造を引き継いでいます。40層のうち30層は短い畳み込みを使うブロック、10層はGQAという方式の注意機構です。前者で局所的な情報を扱い、後者でより広い関係を扱う組み合わせと考えると、イメージしやすいでしょう。
発表による主な変化は、扱える文脈が32,768から131,072トークンへ広がったこと、語彙が約65Kから128Kへ増えたこと、そして答えの前に推論を行うモデルになったことです。語彙の拡張は英語以外の文字列を扱う狙いがあります。日本語も対応言語に含まれますが、それだけで日本語の実務精度が分かったことにはなりません。
学習も、文章を読む段階だけで終わりません。公式説明では、教師モデルを専門化し、複数分野の蒸留を進め、さらにエージェントの実行環境で強化学習する流れを採っています。正解文を覚えるだけでなく、道具を使って何段階かの仕事を進める練習を組み込んだ設計です。
ただし、これらの各変更がどれだけ効果を生んだかを、この発表の比較表だけから切り分けることはできません。学習手順の説明と、因果関係の証明は別です。
数字を見ると、得意な仕事と苦手な仕事が分かれる
Liquid AIは、同じ比較群を16種類のベンチマークで評価しています。次の表は、公式モデルカードから代表的な値を抜き出したものです。すべて提供元の評価で、AICompanyによる独立再測定ではありません。
| 評価 | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | 見るポイント |
|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 自動化課題で大きな差 |
| BFCLv4 | 65.01 | 65.00 | ほぼ同値。0.01の差を優位と強調しない |
| ToolSandbox | 80.71 | 75.02 | 道具を使う対話で上回る |
| LiveClaw | 48.09 | 38.19 | エージェント評価で上回る |
| WebArena Verified | 26.75 | 37.62 | ブラウザ課題では下回る |
| SWE-Bench Verified(OpenCode) | 51.00 | 66.20 | コード修正でも下回る |
AutomationBenchでは、表の値の比は約3.18倍です。しかし、これは「あなたの事務作業が3倍速く終わる」という結果ではありません。評価の点数、作業時間、成功する仕事の数は同じ指標ではないからです。
また、評価ごとに生成設定が違います。たとえばToolSandboxは温度0、LiveClawは温度1.0で、出力上限も異なります。ToolSandboxにはGPT-4oのユーザーシミュレータを使っています。表の横方向の比較と、別々の評価をまたぐ比較を混同しないことが大切です。
AICompanyの読み方は、「小さいactiveで何でも勝つ」ではなく、「道具を呼ぶ仕事と指示を守る仕事で、端末内モデルの候補が増えた」です。ブラウザ操作や大きなコード修正まで一括して任せる前に、自分の仕事で確かめる余地がしっかり残っています。
毎秒184トークンと2.1万トークンは、同じ速さではない
端末側の公表値は、Apple M5 Maxで毎秒184トークン、AMD Ryzen AI Max+ 395で毎秒114トークンです。条件はllama.cpp、Q4_K_M量子化、入力文脈4Kトークン。131Kいっぱいまで長い会話を詰めたときの速度を示す値ではありません。
一方、NVIDIA B300で毎秒2.1万トークンを超えるという値は、多数の要求を同時に処理した合計の出力スループットです。測定はBF16の重み、入力1,024トークン、出力最大256トークンで行われています。ひとりの利用者に、その速度で長文が届くという意味ではありません。
さらに、このモデルは答える前に推論を生成します。生成そのものが速くても、推論を長く続ければ最終回答までの時間は伸びます。仕事の速さを知りたいなら、最初の表示までの時間、回答完了までの時間、道具の待ち時間、やり直し回数をまとめて測る必要があります。
ローカルに置けば、道具まで内側になるわけではない
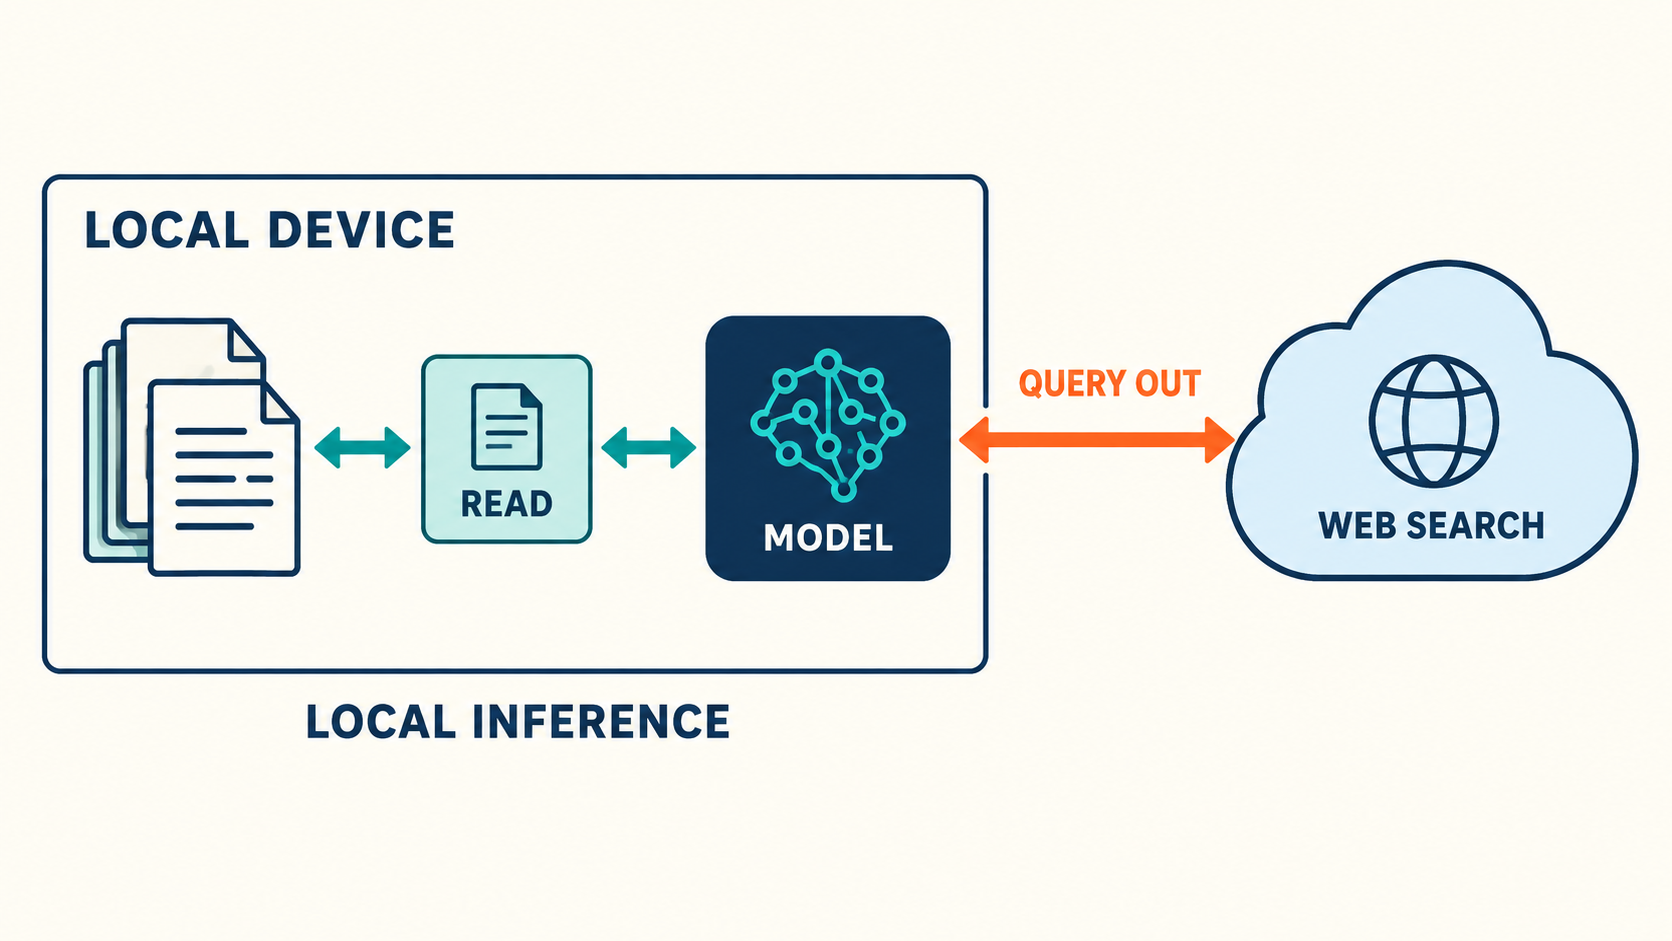
モデルは道具を呼ぶ文字列を出します。その文字列を解釈し、関数を実行して、結果をモデルへ戻すのは外側の実行環境です。公開モデルカードも、この往復を四段階で説明しています。
ここが実務では重要です。モデルの推論を手元で行っても、検索APIへ問い合わせれば検索語は外へ出ます。外部サービスへ文書を送る道具があれば、文書も外へ出ます。「モデルがローカル」と「仕事全体がローカル」は別々に確認する項目です。
記事の下書きを例にすると、手元の文書から必要な箇所を探す道具と、インターネットへ検索語を送る道具を分けると、データの行き先が見えます。最初は読み取りだけを許可し、公開や上書きは人が確認する。これはAICompanyの運用案で、LFM2.5で安全性や精度が実証された構成ではありません。
まず確かめたいのは、容量と仕事の相性
モデルを丸ごと導入する前に、見出しの数字を簡単な計算で確かめられます。次は標準Pythonだけで動く算術例です。モデルは実行せず、ネットワークにも接続しません。
parameters = 24_000_000_000
for bits in (16, 4):
    weight_gib = parameters * bits / 8 / (1024 ** 3)
    print(f"{bits}-bit weights only: {weight_gib:.2f} GiB")
print(f"AutomationBench score ratio: {27.69 / 8.72:.2f}")
結果は重みの理論量が44.70GiBと11.18GiB、点数比が3.18です。この計算を実行して値を確認しましたが、推論速度や必要メモリを測ったわけではありません。
次に試すなら、同じ文書、同じ道具、同じ実行回数で、身近な仕事を小さく比べるのがよさそうです。たとえば、文書から指定箇所を見つける、決めた形式の下書きを作る、存在しない情報には保留を返す、という三つ。成功率だけでなく、誤った道具の呼び出し、外部へ送った情報、回答完了時間も残せば、採用判断に近づけます。この実務評価は今回まだ行っていません。
重みは公開されていますが、ライセンスは独自のLFM Open License v1.0です。使い方に合う条件を原文で確認する必要があります。公開重みだから、あらゆる利用条件が無制限だとは受け取らないでください。
手元の助手を選ぶときの、新しい候補
LFM2.5-24B-A2Bの価値は、総パラメータ数の大きさと毎トークンの計算量を分け、さらに道具を使う訓練を重ねて、端末内エージェントへ近づけた点にあります。公開設定と学習手順があるため、宣伝の数字を条件付きで読み解けるのも利点です。
ただし、万能な置き換えではありません。日本語の仕事、長い履歴、量子化後の品質、外部ツールとの境界は、それぞれ確認が必要です。大事なのは「何Bなら安心か」より、「この仕事を、どの道具で、どれだけやり直さず終えられるか」。助手の採用面接は、パラメータ数だけでは終わりません。
一次資料:Liquid AI公式発表、Hugging Face公式記事、確認時点のモデルカード、公開設定、ライセンス原文。数値は提供元の報告、容量と比率は独自の算術例、運用案はAICompanyの解釈です。