
AIに難しい仕事を任せたとき、「もう少し考えて」と言いたくなることがある。でも、その追加時間を何に使うのか。やり直すのか、途中の成果を直すのか、それとも、すでにできている答えを確かめるのか。
Meta Superintelligence Labsの研究者らが発表した「Thinking Before Thinking」は、この判断そのものを、独立した仕事として扱う研究だ。作業をするAIとは別に、進み具合を整理し、次の作業を選び、必要な情報を渡す制御役を置く。

同じモデルでも、仕事の進め方を変えると結果が変わった。ただし、「司令塔を付ければ安く速くなる」という話ではない。制御役も計算資源を使う。短い仕事では、その相談時間が足を引っ張った。
注目したいのは、AIを何体に増やすかより、途中の成果をどう扱い、いつ次の手を打つか、という設計である。
長い履歴があっても、仕事の現在地は分からない
長時間動くAIエージェントには、試した方法、失敗した操作、修正案、検証結果がたまっていく。全部を履歴として渡せば、情報を失わずに済みそうに見える。
ところが、「記録がある」と「今の判断に使える」は別だ。古い失敗を何度も蒸し返したり、すでに正しかった答えを余計な修正で壊したりする。会議の議事録が厚くなっても、次の担当が決まるとは限らない。AIにも、この小さな会議地獄がある。
原著が分けたのは二つの役割だ。ワーカーは証明を書いたり、プログラムを作ったりする。コントローラーは、何が分かり、何が未確認で、次の一手にどれだけ価値があるかを考える。
これはモデルの重みを更新する学習ではない。推論時の実行環境、いわゆるハーネスの設計を変える方法だ。
制御役も、一回の思いつきでは決めない
提案手法の制御は、四つの段階を順番に進む。
- Assess:現在地を整理する。 新しい成果を読み、分かったこと、残った問題、注意点を短い状態メモに書き直す。
- Propose:次の候補を出す。 別解を試す、途中の結果を直す、検証するなど、選択肢を並べる。この段階には残り予算を明示的には渡さない。
- Evaluate:予算に照らして選ぶ。 候補の価値と残りの呼び出し回数を見て、何を優先するかを判断する。
- Dispatch:具体的に依頼する。 作業指示と必要な過去の成果を選んで渡す。十分なら、保存済みの答えを選んで終了する。
各段階は、必要に応じて複数回のモデル呼び出しや記憶の読み書きを行う。一つの長いプロンプトに「よく考えて」と書く方法とは、この点が違う。
ただし、価値の判断はプロンプトによる定性的な判断だ。次の作業が何点の改善を生むかを、厳密な最適化で求めているわけではない。
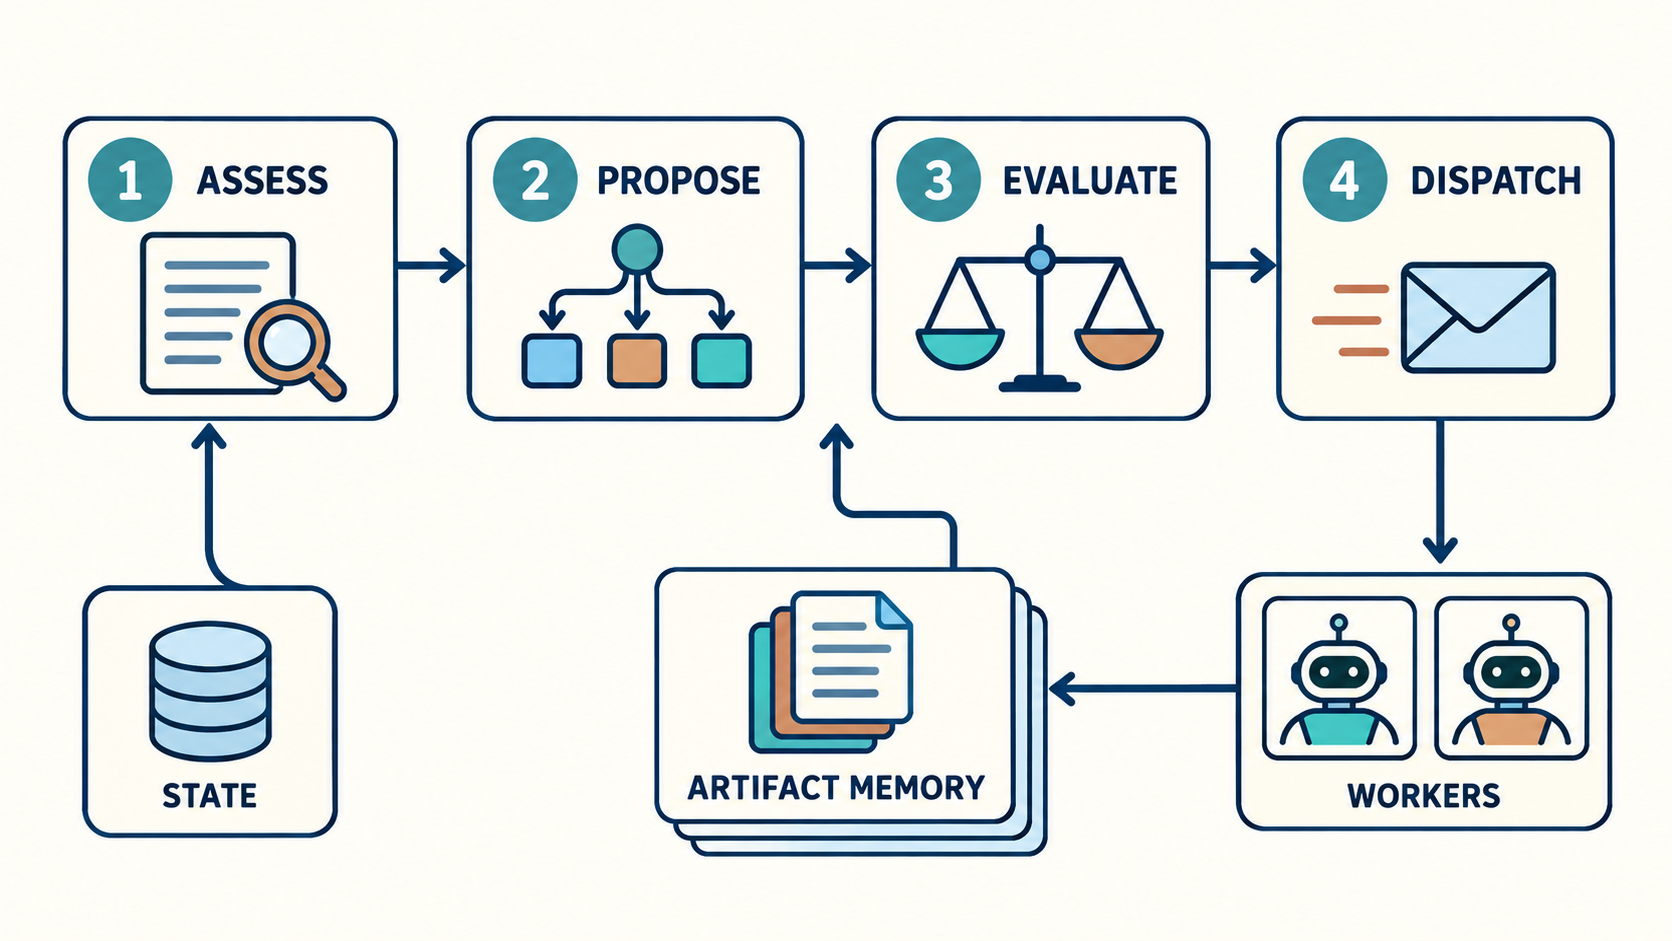
過去のワーカー出力は、識別子付きの成果物として保存する。状態メモは毎回書き直すが、元の成果物は残る。ワーカーには、制御役が選んだ指示と成果物を渡す。制御役の内部の検討内容を丸ごと引き継ぐ仕組みではない。
ここで大切なのは、記憶を単に増やすのではなく、次の担当者に何を見せるかも仕事の選択に含めることだ。修正なら元の案と指摘を渡す。別の方法を試すなら、以前の案を渡さずに始めることもできる。
終了時も、最後に出た成果が自動的に採用されるわけではない。すでに保存されている成果から選ぶ。新しい答えを出したければ、まずワーカーに作らせて保存する。
実験で何が変わったのか
原著は、三つのモデルと四つのベンチマークで調べた。数学の証明30問、格子パターンの推論120問、長い推論507問、プログラム再構築200課題である。課題ごとに評価指標は異なる。
プログラム再構築を測るProgramBenchでは、説明書と実行のみ可能な参照プログラムを使い、同じ動きをするコードベースを作る。成績は、各課題の隠しテスト通過率を平均した値だ。「200課題のうち何件を完全解決したか」という割合ではない。
同じワーカー、同じ操作インターフェース、同じ呼び出し回数の上限を使うDirect Controlが、仕組みの比較では中心となる。こちらは、たまった履歴を見て一回の呼び出しで次の行動を決める。
| ProgramBenchのモデル | Direct Control | 提案手法 | 比較した外部エージェント |
|---|---|---|---|
| GPT-5.5 | 63.7% | 71.5% | Codex:58.0% |
| Opus 4.8 | 65.3% | 67.2% | Claude Code:65.5% |
| Gemini 3.1 Pro | 46.9% | 48.7% | mini-SWE Agent:42.0% |
出典は原著の表1。ProgramBenchの呼び出し上限は1課題1,200回で、制御役の呼び出しも含む。GPT-5.5ではDirect Controlとの差が7.8ポイント、比較されたCodexとの差が13.5ポイントだった。これは相対的な増加率ではなく、成績の差である。
数学などの推論課題は上限100回で評価し、三モデル平均の改善は、証明4.0ポイント、格子推論4.2ポイント、長い推論3.6ポイントだった。主要な上限では、四課題系統と三モデルの12組すべてで、提案手法の点推定がDirect Controlを上回った。
ただし、これを現在のCodexやClaude Code全般の順位と読むのは早い。原著の付録Iでは、外部エージェントの標準ツールを無効にし、共通のコンテナ操作ツールを使わせている。予算通知も追加している。比較は、そこで評価した構成に対するものだ。
「同じ1,200回」は、同じ費用ではない
この研究でいちばん読み飛ばしたくない部分がある。
同じなのは、モデルを呼び出せる回数の上限だ。実際に使った回数、入出力トークン数、料金、所要時間が同じとは限らない。
ProgramBenchのGPT-5.5では、Direct Controlが上限1,200回の約18%で止まる一方、提案手法は、モデルによって上限の約89%から101%まで使った。上限は制御サイクルの間で確認するため、すでに依頼したワーカーの完了によって、わずかに超える場合がある。
つまり、提案手法は、追加予算を使って仕事を続けやすい仕組みでもある。上限がそろった結果を、同額での性能改善に置き換えてはいけない。
さらに、少ない予算では逆転した。Opus 4.8のProgramBenchで上限400回の場合、提案手法は56.6%、Direct Controlは62.7%。上限1,200回では、67.2%対65.3%に変わる。相談に時間を使う価値は、その後に働く余地があって初めて回収できる。
このため、短い質問や単純な一回の修正に、四段階の制御を必ず入れるべきだとは言えない。原著の付録Aも、同じトークン費用や同じ実行時間での効率は示していないと明記している。
正解を作ることと、正解を提出することは違う
原著は最終成績だけでなく、途中の成果物のつながりを記録した。ある出力を次の作業の入力に渡せば、両者を線で結ぶ。元の案から検証が生まれ、その二つから修正版が生まれる、といった流れが見える。
この記録により、「一度も正解が出なかった」のか、「正解は途中にあったのに最後に選ばなかった」のかを分けられる。
提案手法は、調べた多くの推論条件で、途中に正しい候補が現れる実行を増やした。しかし、最後の候補選びの改善はモデルや課題によって一様ではなかった。なお、この途中成果の正誤分析は推論課題で行われたもので、ProgramBenchにも同じ分析を実施したわけではない。
記憶を短くする利点も、慎重に読む必要がある。制御役が持ち越す状態は数千から数万文字程度に収まり、Direct Controlの長い履歴は、ある証明課題の実行で100万文字を超えた。ただし、取り出した成果物や各段階の対話は、別に文脈へ加わる。これだけで総トークン量の削減を証明したことにはならない。
状態を短くすること、段階を分けること、記憶へ選択的にアクセスすることを同時に変えているため、どれが何割効いたのかも分離できていない。
記事制作に置き換えるなら、原稿を上書きし続けない
ここからは、AICompanyによる応用案だ。原著が記事制作で効果を測ったものではない。
たとえば、初稿に数値の誤りを見つけたとする。初稿、数値確認の結果、修正版を別々の成果物として残す。現在地のメモには「導入は使える。表の母数が未確認。次は一次資料の表だけを照合する」と書く。
次の候補は、全文を書き直す、数値だけ確かめる、構成を変える、などだ。残りの時間と呼び出し予算を見て、まず数値確認を選ぶ。その担当には初稿と該当資料を渡し、関係のない過去の試行を全部読ませない。
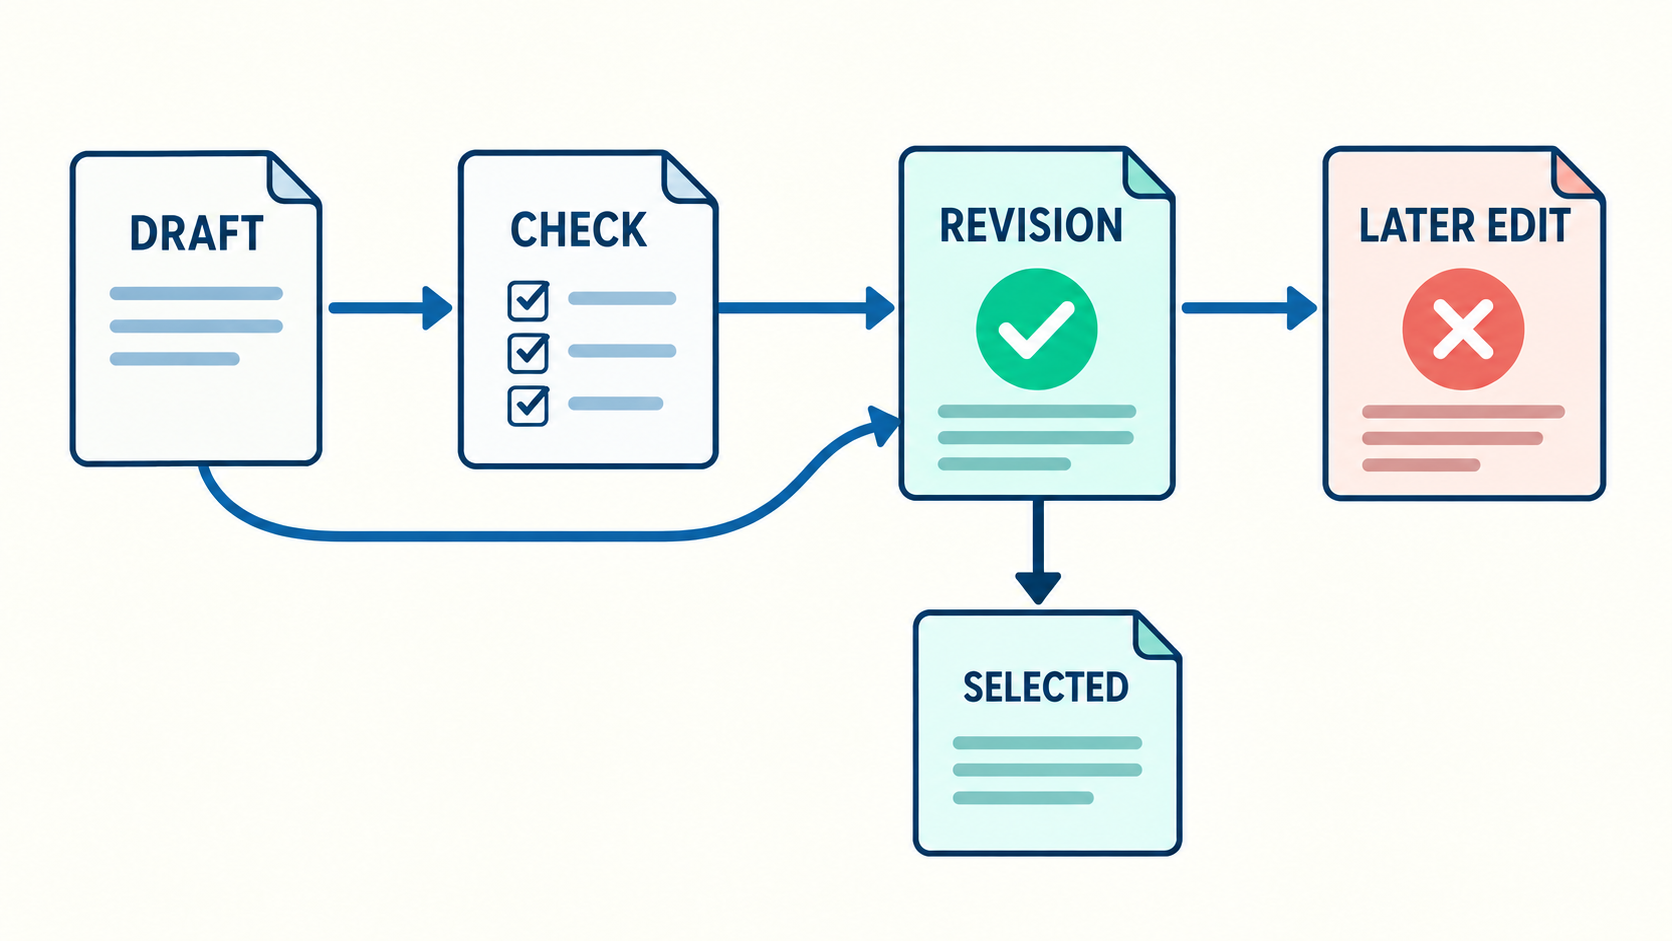
最低限の仕組みは、次のように考えられる。これはAICompanyが作った帳簿の例で、実際のモデル制御を再現したコードではない。
artifacts = {
    "draft": {"parents": [], "valid": False},
    "check": {"parents": ["draft"], "valid": False},
    "revision": {"parents": ["draft", "check"], "valid": True},
    "late_revision": {"parents": ["revision"], "valid": False},
}

remaining = 10
controller_calls = 4
parallel_worker_calls = [2, 2]
remaining -= controller_calls + sum(parallel_worker_calls)

selected = next(
    (key for key in ["late_revision", "revision"]
     if artifacts[key]["valid"]),
    None,
)
assert remaining == 2
assert selected == "revision"
この例の検証済みフラグは人が設定した仮の値だ。コードが原稿の正しさを判断しているわけではない。並列に二つの作業を走らせても、呼び出しは合計で数える。そして、最新の版が不合格なら、一つ前の合格した版を選べる。
同梱の小さな実行例では、予算超過時の拒否、合格した既存成果の選択、合格候補がない場合、依存関係の保存を含む五つの確認が通った。モデル呼び出しはゼロであり、論文の性能結果を再現した実験ではない。
実務で試すなら、同じ課題を使い、最終品質に加えて、実費、経過時間、使った呼び出し回数、余計な修正で壊した件数を比べたい。改善率を語るのは、その後だ。
考え直しすぎて、正しかった答えを壊すこともある
原著は、長い推論ベンチマークのチェス領域で、提案手法がDirect Controlより悪くなる例も挙げている。著者らの予備的な軌跡確認では、追加の検討が、すでに正しかった答えを不安定にする可能性が見られた。原因を全面的に解析した結論ではないが、実務にも響く失敗だ。
制御役の整理が間違えば、その短いメモを頼りに後続の作業が進んでしまう。要約で落とした情報を、後で必ず取り戻せる保証もない。
また、証明の課題数は30問と小さい。主要条件で全組の点推定が良かったことは、すべての差に統計的な有意性があることや、別のモデル、別の仕事、さらに長い実行でも改善することを保証しない。今回、AICompanyは大規模なモデル評価を再実行していない。提案ハーネスそのものの公開実装も、確認した論文リンクからは見つけられなかった。
増やすべきなのは時間だけでなく、次の一手の質
この研究の価値は、「長く考えれば強くなる」を、もう一段具体的にしたところにある。
何ができたのかを整理し、別の手を並べ、残り予算に照らして選び、必要な成果だけを次の作業へ渡す。長い仕事を前へ進めるための判断を、独立した工程として扱った。
一方で、制御を増やすほど得になるわけではない。短い仕事では相談を減らす。長い仕事では、良い途中成果を保存し、正しかった答えを壊さない。モデルを替える前に、仕事の進め方を測り直す余地がある。
原著: Thinking Before Thinking: Scaling Agentic Inference Through Meta-Reasoning(2026年9月29日公開、v1)。数値・設定・限界は本文の表1、5〜7節、付録A・Iを参照。本文の図はAICompanyが概念を独自に再構成したもので、原著の図の転載ではない。