
同じ90回の試行で、成功した回数はどちらも57回。それなのに、一方は優勝し、もう一方は2位でした。
違ったのは、成功の回数よりも、その成功がどこに集まっていたかです。一度はできる課題が多いのか。それとも、できる課題を繰り返し確実にこなせるのか。

AIに作業を任せる場面では、この差が効いてきます。昨日は正しくできた公開操作を、今日はうっかり飛ばす。失敗した更新を、なぜか「完了しました」と報告する。たまの好プレーだけでは、安心して任せにくい。
Ivan Matveev氏の技術報告「Policy as Code」は、そのばらつきを減らすために、AIを支える実行の仕組みを工夫しました。柱は二つ。ツールの結果が返るたびにモデルを呼び直さないこと。そして、事実から決まるルールをコードで守らせることです。
57回成功しても、安定性は同じではない
対象のCAR-benchは、車内アシスタントがツールを使って依頼に応える評価です。操作できない機能を頼まれたり、情報が欠けたり、依頼が曖昧だったりする場面を含みます。今回読むのは9月24日に公開された報告で、競技会の結果そのものはそれ以前のものです。
主催者の隠し評価は30課題を各3回、合計90回実行しました。主指標のPass³は、同じ課題で3回とも成功したときだけ、その課題を合格と数えます。Pass@3は、3回のうち少なくとも1回成功すれば合格です。
| 隠し30課題の結果 | Policy as Code | 2位のチーム |
|---|---|---|
| 成功した試行 | 57/90 | 57/90 |
| 3回とも成功した課題 | 18/30(60%) | 15/30(50%) |
| 少なくとも1回成功した課題 | 20/30(66.67%) | 23/30(76.67%) |
2位のチームは、一度でも解けた課題の種類が多い。一方、Policy as Codeは解ける課題を3回そろえて成功させた数が多い。主催者の公式結果でも、この違いを確認できます。
公開集計から計算すると、Policy as Codeは「0回成功、1回成功、2回成功、3回成功」の課題数が10、1、1、18。2位は7、4、4、15です。これはAICompanyが表の数値から逆算した内訳で、実行ログを一件ずつ再集計した結果ではありません。
ここから読み取れるのは、万能さと安定性を分けて測る必要がある、ということです。より多くの課題に挑戦して当たりを引く力と、決まった仕事を繰り返し成功させる力は、同じ点数では表しきれません。
ツールが返るたびに、AIを呼び直す必要はあるか
たとえば「現在の状態を読む。その値に応じて設定を変える。変更結果を確認する」という作業を考えます。
次の操作を一つずつモデルに決めさせる設計では、最初の読み出し結果を渡し、またモデルを呼び、変更結果を渡し、さらにモデルを呼ぶ流れになります。判断が必要な分岐もありますが、条件が明確なら、普通のプログラムで続けられる部分もあるはずです。
この報告では、モデルがPythonプログラムを出し、実行側がその処理を進めます。ツールを呼ぶ箇所でPythonの処理を止め、外部の評価器へ呼び出しを渡す。結果が戻ったら、止まっていた場所へ値を渡し、同じ処理を再開する。この橋渡しが「coroutine bridge」です。
重要なのは、ツールを使う回数が消えるわけではないことです。ツールは引き続き評価器が実行し、呼び出しも記録されます。減らすのは、その結果を受け取るたびに挟んでいたモデル呼び出しです。
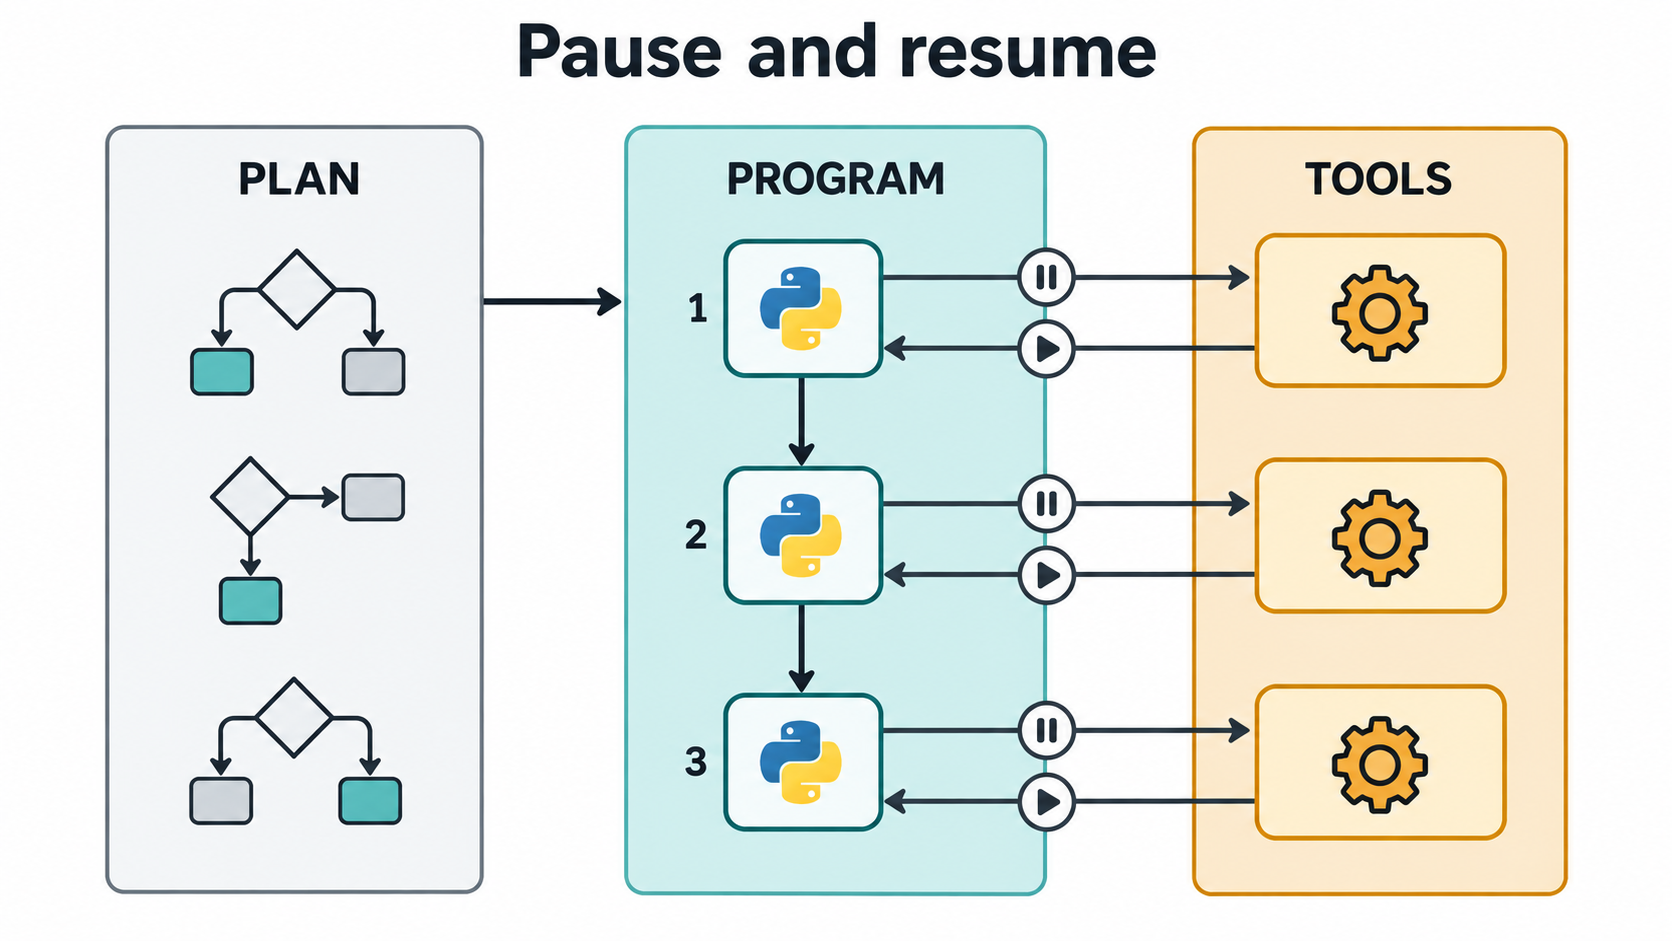
著者の公開テストでは、125課題を各3回評価した際、1課題あたりの中央値はモデル呼び出し2回、エージェントの往復7回でした。複数の往復を、一つのプログラムが引き受ける構造です。独立した読み出しはまとめられますが、先の結果が必要な操作は順序を守ります。
同じ公開テストのモデル待ち時間の中央値は1.8秒でした。ただし、これは利用者が作業完了まで待つ全時間ではありません。評価器のシミュレーターや判定器の時間を含まず、隠し評価で報告されたタスク時間の中央値3.14秒とも別の値です。いずれもAICompanyが独立に測った速度ではありません。
「忘れないで」と頼む代わりに、ツールを通る条件にする
呼び出し回数を減らすだけでは、間違った操作を速く実行することにもなりかねません。そこで、もう一つの柱が必要になります。
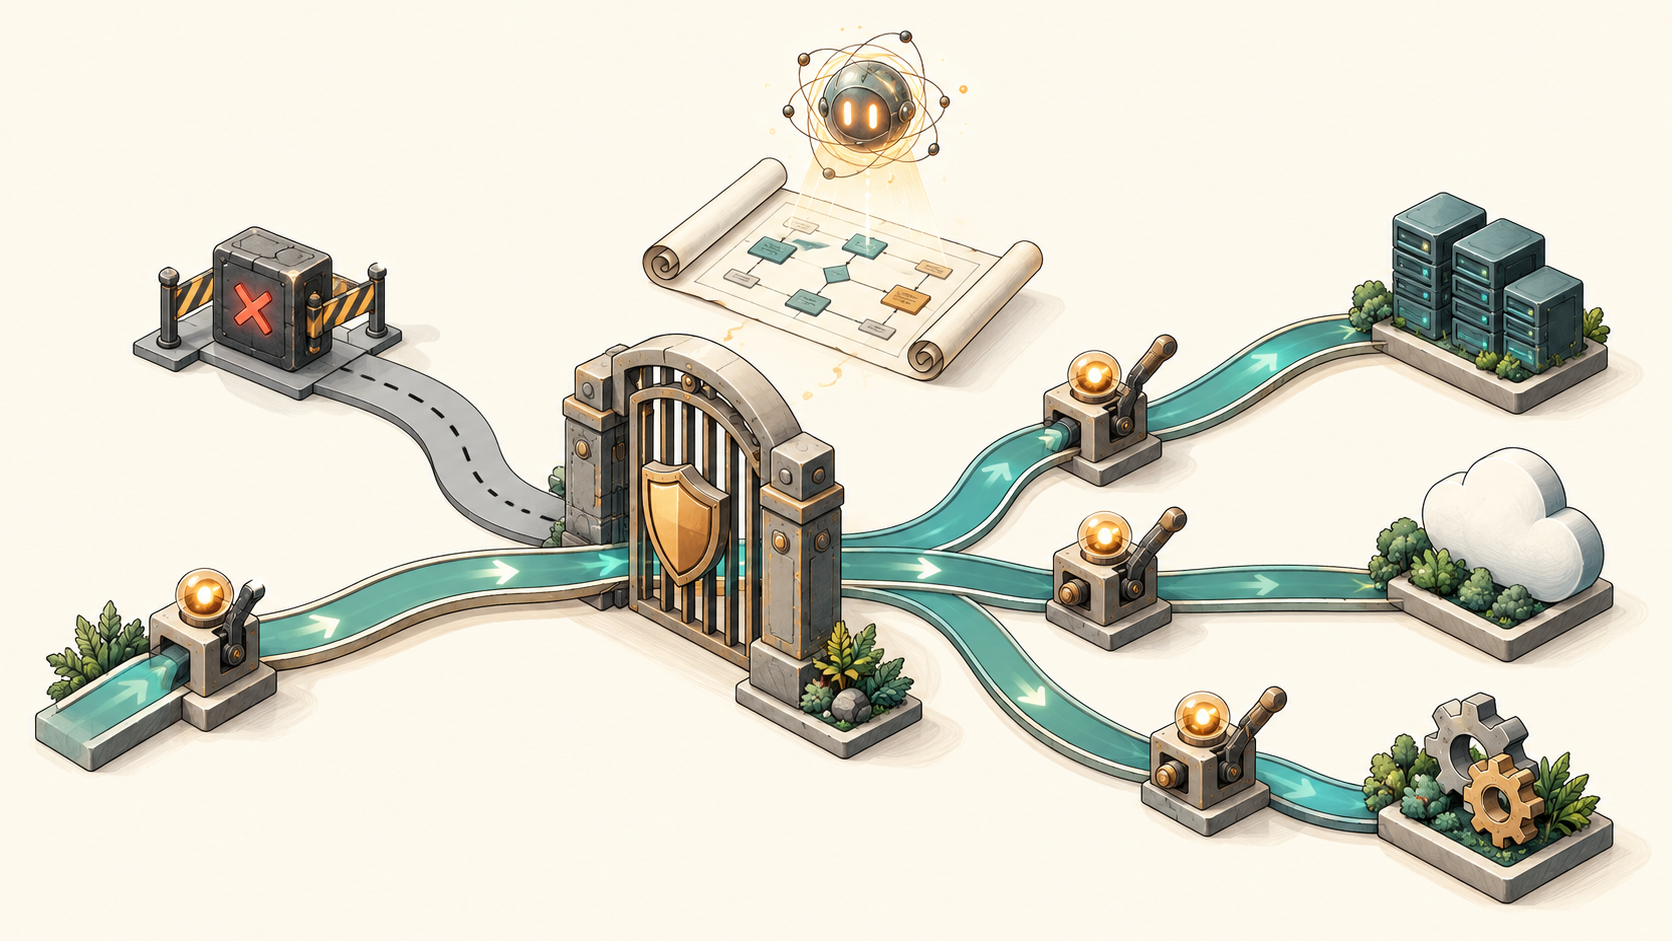
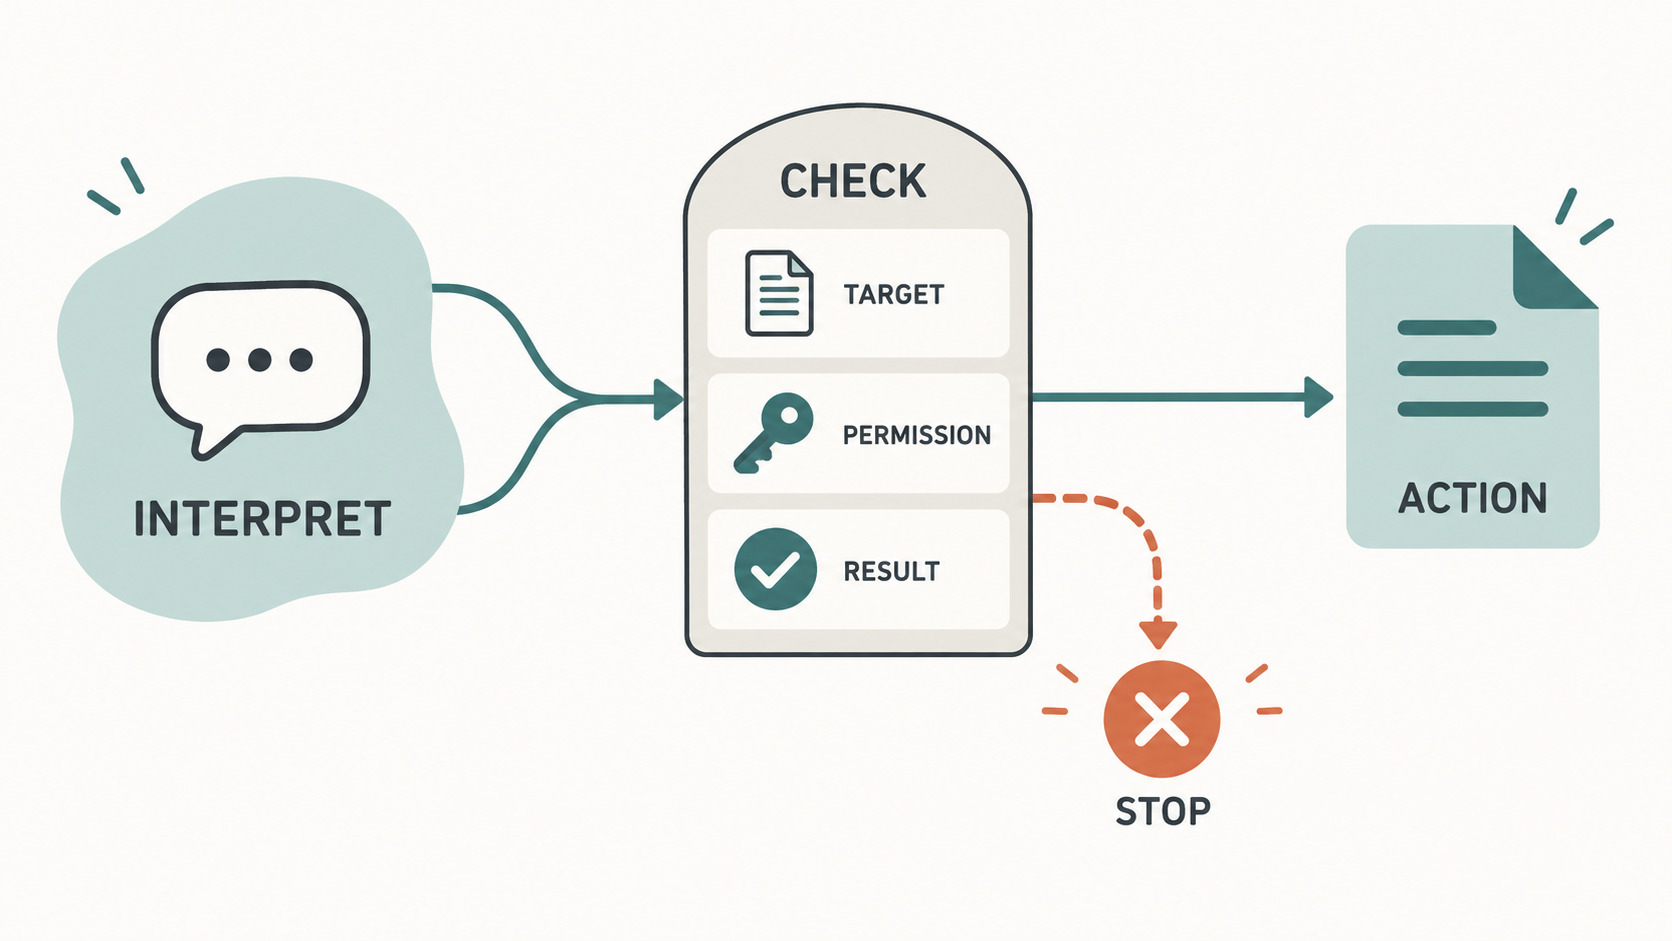
この報告は、ユーザーの意図を解釈する仕事をモデルに残し、根拠のある事実から一意に決まるルールをツール側へ移しました。モデルが公開された操作名を使っても、内部ではガード付きの処理を通ります。確認が必要な操作は、その具体的な対象と内容を保留して、次のユーザー応答につなぎます。
欠けている値を勝手に補わない、という扱いも実行側で支えます。また、操作が失敗した事実を同じユーザーターンの中で追跡し、途中の処理を挟んでも成功扱いに変わらないようにします。仕組みの詳細は原著の3節と4節にあります。
ここでの分け方が実務的です。「この依頼で何を望んでいるのか」は解釈の問題。「この対象への変更が許可されているか」は、事実と規則を確かめる問題。同じモデルに両方を何度も思い出してもらう必要はありません。
もっとも、コードに書けば何でも正しくなるわけではありません。規則自体を間違えたり、古い情報で判断したり、ガードを通らない操作経路が残ったりすれば、誤りをきれいに繰り返すだけです。ここは設計する人の仕事が残ります。
小さな模型で、停止と再開を確かめる
AICompanyでは、この考え方を理解するため、手書きのPythonプログラムと模擬ツールを使った小さな例を動かしました。LLMや実際の公開サービスは使っていません。
流れは、対象を読む、権限を確認する、フラグを変更する、の三段階です。Pythonのgeneratorを使うと、待ち合わせ部分だけは次のように短く表せます。
def program(target):
    record = yield ("read", target)
    if record.get("target") != target or record.get("value") == "unknown":
        return "missing_or_mismatched"
    permission = yield ("permission", target)
    if permission is not True:
        return "blocked"
    result = yield ("set_flag", target)
return "success" if result is True else "failed"yieldで操作を外へ渡して処理を止め、模擬実行側が返した結果を受け取って続けます。通常ケースでは、一つの事前定義プログラムが3件のツール往復を処理しました。
確認したのは6条件です。許可あり、許可なし、対象情報がunknown、許可情報がunknown、変更失敗、対象の取り違え。許可なしやunknownでは変更を行わず、変更失敗では成功と返さず、別の対象が返ったときも停止しました。
変更を受け付ける模擬実行側にも対象と権限のガードを置いています。上の分岐を省くだけで素通りできる設計にはしませんでした。
この例が示すのは、結果待ちのたびに新しい文章判断を挟まなくても、決まった処理を続けられることです。論文のワーカースレッド実装を再現したものではなく、速度やモデル精度が改善することを測った実験でもありません。実際に生成された任意のPythonを安全に実行する仕組みは、これとは別に必要です。
記事制作なら、どの判断をコードへ渡すか
ここからはAICompanyの応用案です。
記事を制作するAIに、「監査を通ってから公開してください」と指示する。方針としては自然ですが、公開の可否まで毎回文章から判断させると、長い作業の途中で条件が抜ける余地があります。
題材が面白いか、説明が読者に伝わるか、見出しに勢いがあるか。そこは人やモデルの判断を使う。一方で、対象の記事IDが一致しているか、必須の検証結果がそろっているか、禁止文字が含まれていないか。決まった条件は公開処理の入口で確かめる。
作り始めるなら、いきなり全判断をコードに移す必要はありません。直近の失敗を一つ選び、「同じ事実があれば必ず同じ判定になるか」を考える。その条件を操作側で検査し、正常ケースだけでなく、情報が欠けたケースと失敗ケースを試す。ここからで十分です。
確認の対象にも注意が要ります。「さっき許可された」だけで別の記事を公開できてはいけません。許可を具体的な記事や内容に結びつけ、実行時に条件が変わっていないか確かめる。再起動で保留状態が消えたときに、都合よく許可済みと解釈しない。こうした部分まで含めて初めて、実務のガードになります。
これは論文が記事制作で効果を実証した手順ではありません。車内アシスタントの設計から、こちらの仕事へ持ち帰るなら何を確かめるか、という提案です。
強い結果と、まだ任せきれない部分
Policy as Codeは、Cerebrasのgpt-oss-120bを使うTrack 2でPass³60%を記録しました。同じ構成をGPT-5.5で提出したOpen trackでも60%でしたが、これをモデルの能力全般が同等だと読むことはできません。解ける課題の広さと繰り返し成功する割合には違いがあります。
また、隠し評価の40%の課題は、少なくとも一度失敗しています。隠し集合は30課題と小さく、単一の車内アシスタント領域です。シミュレーターと判定器にはLLMを使い、複数の仕組みを合わせた提出物なので、個々の部品の効果を切り分けた証明でもありません。
主催者は時間とトークン数が提出者の自己申告で、独立検証できなかったことも明記しています。掲載費用は共通の価格とキャッシュ仮定を使う推計です。実請求額や、別の環境で同じ速度になる保証としては扱えません。
著者も、安定した経路へ寄せることで偶然の成功を拾いにくくなる点と、ワーカーの状態がプロセス再起動で失われる点を限界として挙げています。今回、採用された仕組みの公開実装は確認できず、AICompanyも競技会の実験を再実行していません。
それでも持ち帰れる設計の問いは明確です。その判断は、毎回AIに考え直してもらう必要があるか。
言葉の理解にはAIの柔軟さを使い、確定した手順はプログラムで続け、守るべき条件は操作の入口で確かめる。より大きなモデルを選ぶ前に、この役割分担を見直す価値があります。
出典:Policy as Code(arXiv:2609.29251v1)、CAR-bench Challenge公式結果。数値は原著と主催者公開結果の報告値、模型と記事制作への応用はAICompanyによる説明・提案です。