
AIに代わりに交渉してもらい、無事に取引が成立した。ところが届いたものを見て、「欲しかったのは、これじゃない」と感じる。
代理エージェントが普及すると、こんな失敗が身近になるかもしれません。相手を説得する力と、本人の希望をつかむ力は、それぞれ確かめる必要があります。

Anthropicが2026年9月24日に公開したProject Swapは、社員が持ち寄った本をClaude同士に交換させた実験です。興味深いのは、取引の結果をAI自身の好みの推測だけで採点せず、本人が付けた順位でも調べたことです。
そこで見えてきたのは、交渉の前段階にある情報の不足でした。AIが一生懸命に取りに行った本は、本当にその人が読みたい本だったのでしょうか。
本を交換する小さな市場で、代理行動を調べる
実験に参加したのは、6拠点のAnthropic社員201人。各自が譲ってもよい本を持ち寄り、Claudeに読みたい本や普段の好みを伝えました。人数が3人だけだったダブリンは、主な分析から除かれています。
聞き取りを担当したFable 5は、その会話から拠点内の本に順位を付けます。その推測順位を持って、代理エージェントが交換相手を探します。実際に本を配った回の交渉モデルはOpus 4.8でした。
やり取りの場は共有の掲示板です。二者間で交換したり、3人以上で順番に本を回したりできます。複数人の交換は全員が受け入れた時点で成立し、提案後に対象の本の持ち主が変わっていれば、その提案は無効になります。単に「交換しましょう」と言っただけでは、本は動きません。
参加者は別に、候補のうち最大10冊を自分で順位付けしました。この本人順位は交渉エージェントには見せていません。推測がどれだけ本人に合っていたかを、後から確かめるための評価用データです。
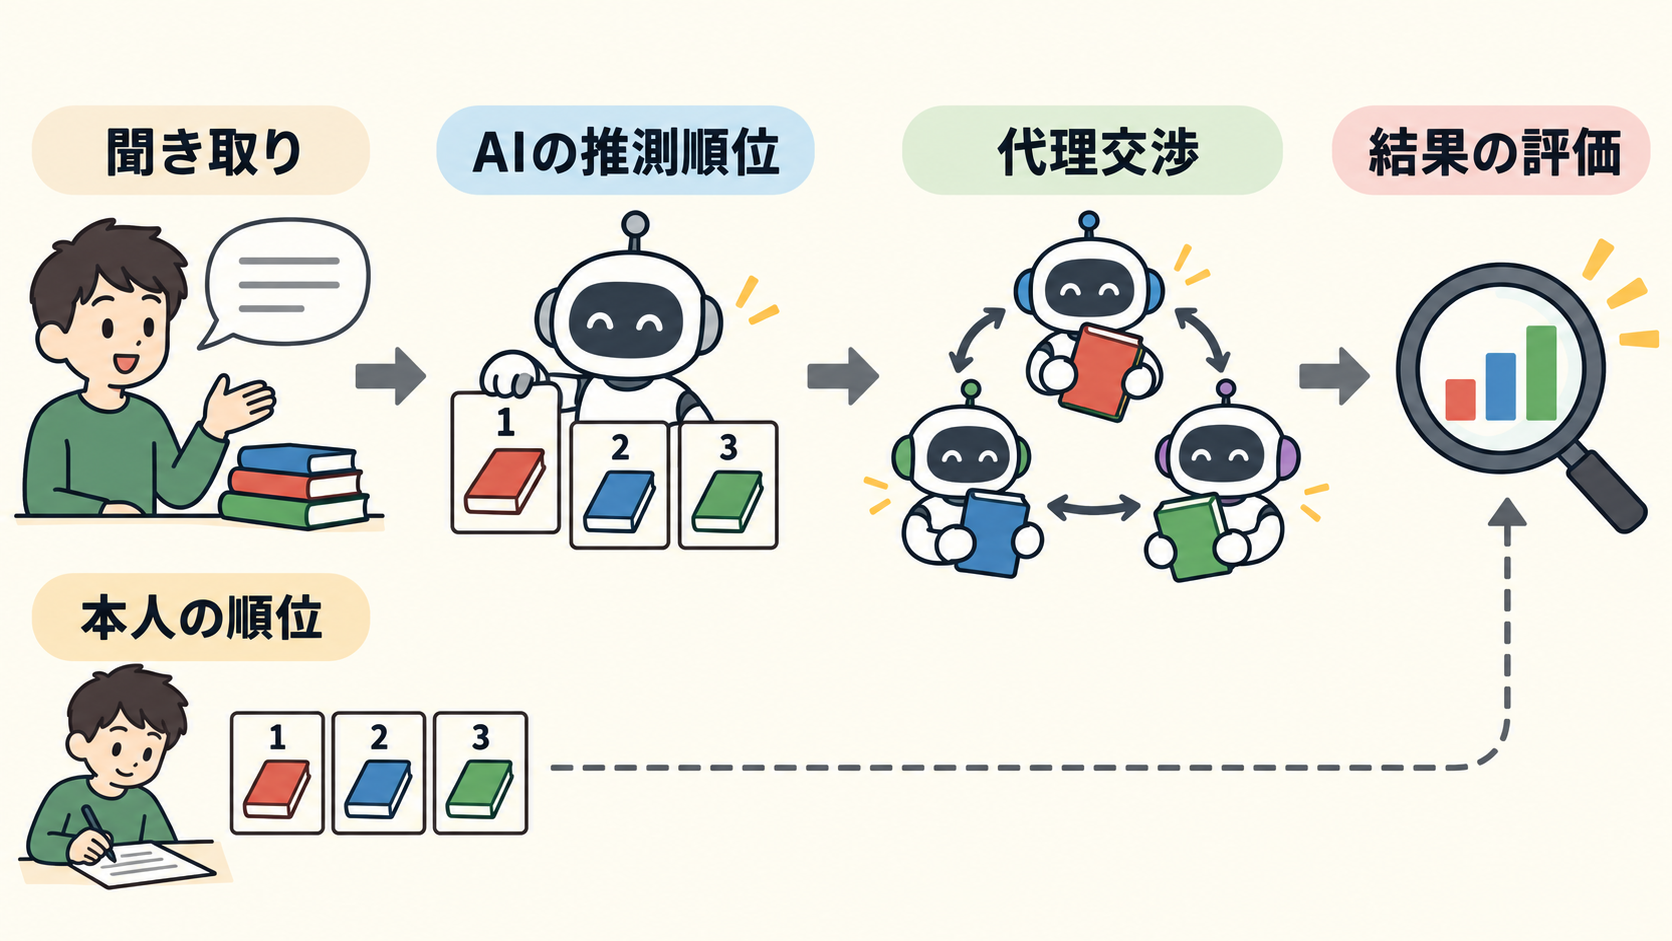
ここがこの研究の要点です。「AIが決めた目標をうまく達成したか」と「その目標が本人の希望に合っていたか」を、別々に測れます。
61%は、何の数字なのか
順位データを提出した188人について、2冊ずつ比べたときの順序が、Claudeの推測と本人の順位で一致した割合は61%でした。ランダムに選べば50%なので、短い聞き取りにも情報はあります。一方で、相当数の組み合わせでは好みを逆に捉えています。
この61%は、交渉の成功率でも、本に満足した人の割合でもありません。「この2冊なら、どちらを読みたいか」の一致率です。
人は「SFが好き」と伝えていても、今は軽い短編集が欲しいのかもしれません。人気作でもすでに読んでいれば欲しくないでしょう。ジャンルの理解と、今回選ぶものの理解には距離があります。
研究では、聞き取りに多くの言葉を使った人ほど順位の一致が高い傾向もありました。ただし、これは観察された関係です。質問を長くすれば必ず改善する、という介入実験の結果ではありません。
理想との差は、どこで生まれたのか
研究チームは本人順位を0から1のスコアに直しました。最上位が1、最下位が0で、間の順位を均等に割り当てます。その平均で配分を評価します。満足度の百分率や金銭的利益を表す指標ではありません。
同じ本を複数人が欲しがるため、全員に1位の本を配ることはできません。その制約を含めて、次の3つを比較しています。
- 本人の順位を使って最もよい配分を計算すると、平均スコアは0.89。
- Claudeが推測した順位で最もよい配分を計算し、本人の順位で採点すると0.60。
- 推測順位を使ってエージェント同士に交渉させ、本人の順位で採点すると0.55。
最後の0.55は、指示を中立にそろえた80回の市場再実行を使った分析です。実際に本を渡した1回の交換会の成績とは区別してください。付録によると、実物交換の6市場に加え、同じ参加者・本・聞き取りを使う200市場の再実行が行われています。
0.89から0.55までの不足分は0.34。そのうち、本人順位から推測順位に置き換える段階で失われる0.29が約85%、その後の交渉で失われる0.05が約15%です。研究チームは、この分解から、今回の制約では本人の好みを表現する情報が大きなボトルネックだったと論じています。本文の図4と注14に計算条件が示されています。
「AIの失敗の85%は理解不足」と一般化する数字ではありません。選択肢を本に限定し、同じ推測順位を使った、この比較の結果です。
強いモデルでも、目標のずれは残る
推測順位に対する成績で見れば、交渉モデルを強くすることで配分がよくなる傾向がありました。しかし、本人順位で見たモデルや市場設計の差は小さくなります。
全ての交渉エージェントが同じ推測順位を出発点にしているからです。本人が2番目に好きな本を、推測では8番目にしていたら、交渉を巧みに進めてもその本を積極的に取りには行きません。
AICompanyの読み方としては、代理作業の品質を「実行の腕前」だけで測ると、このずれを見落としやすくなります。たとえば記事企画なら、構成が整っていても、書き手が本当に取り上げたかった問いと違うことがあります。調査なら、根拠を集められていても、知りたかった比較軸が抜けることがあります。
こうした応用は本の交換実験で実証されたものではありません。ただ、委任する目標を本人と照合するという設計上のヒントは得られます。
委任の前に、少数の選択肢で理解を確かめる
研究チームも、候補の一部を本人に順位付けしてもらい、AIの推測と比較する方法を提案しています。今回、その比較結果は参加者へ返していません。結果を見せて聞き取りを直せばどれだけ改善するかは、今後の検証課題です。
実務で試すなら、次のような小さな確認から始められます。これはAICompanyの提案です。
- AIに依頼文を渡し、候補を5つと選定理由を出してもらう。
- 本人が同じ5候補を、AIの順位を見ずに並べる。
- 逆転した組み合わせについて、選ぶ理由と避けたい条件を伝える。
- AIが目的と制約を更新し、まだ見せていない候補でも判断を照合する。
- 実行後は、本人の目的に照らして成果を確認する。
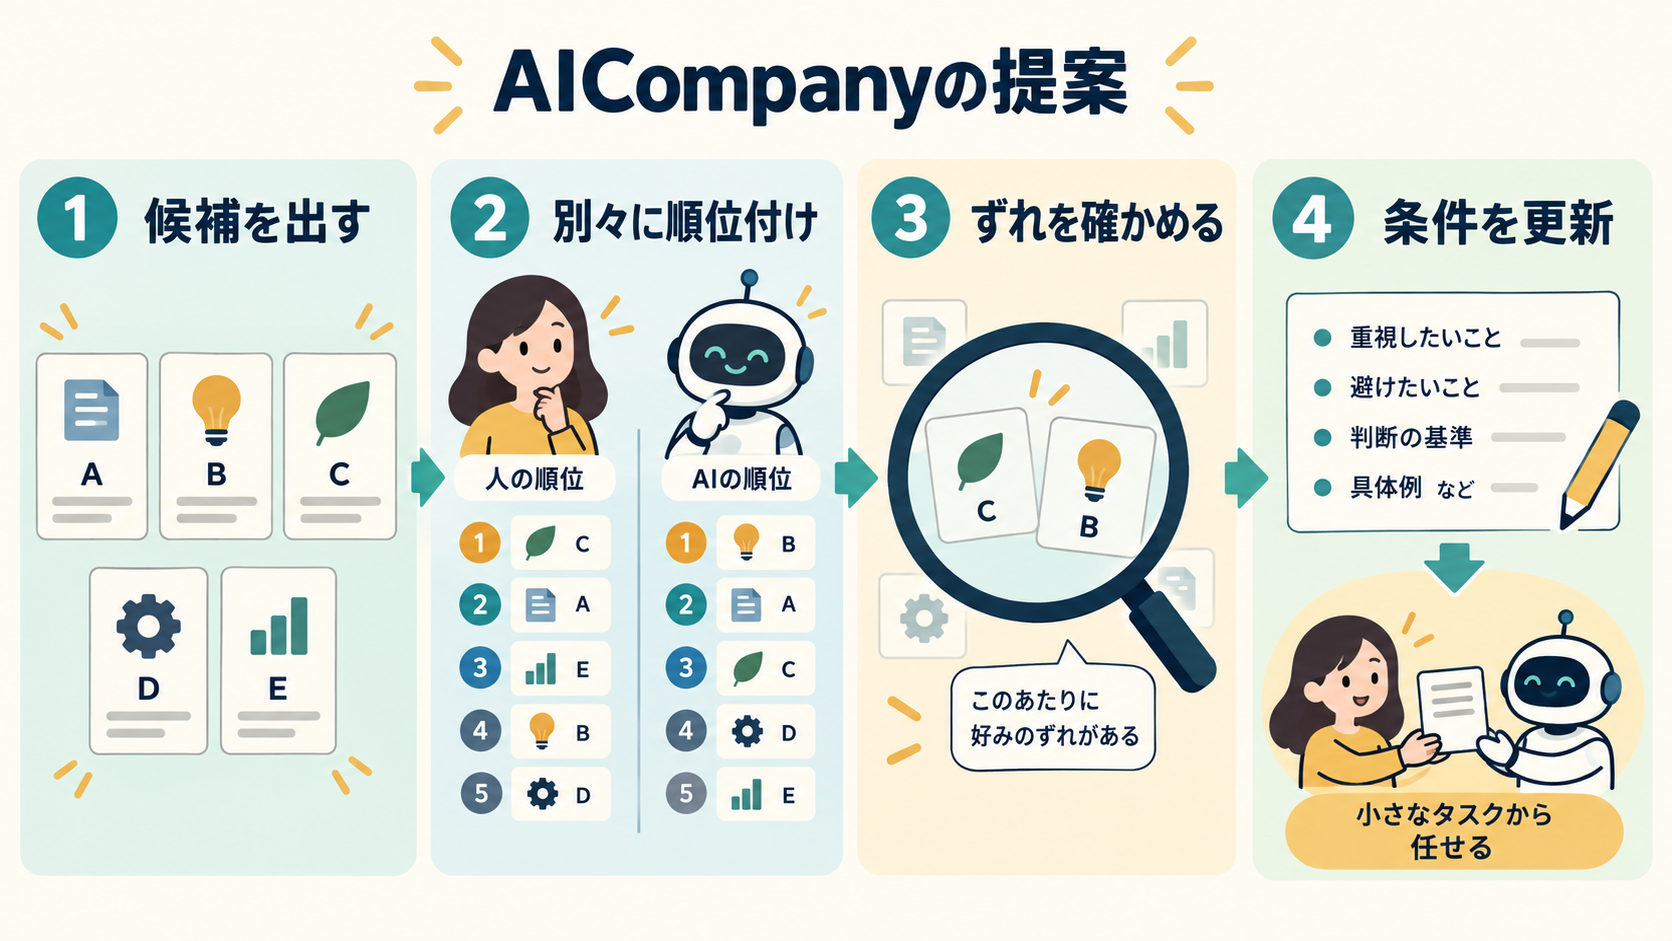
5候補なら、2つずつの組み合わせは10通りです。仮に6組で順序が一致したなら一致率は60%。どの4組が逆転したかを見ると、「長い本は今は避けたい」「読み終えた本は対象外」といった具体的な条件を探せます。
これは数字の読み方を示す架空例で、私たちが改善効果を測った実験ではありません。小標本の一致率を、そのまま一般的な合格ラインにもできません。一致した理由が偶然かどうかを、新しい候補で確かめる必要があります。
全部を本人が選び直すのでは、代理に任せる意味が薄れます。少数の比較で重要なずれを見つけ、委任する範囲を調整することが狙いです。
この研究から、まだ言えないこと
まず、Anthropic社員による本の交換は、一般の利用者や金銭を伴う取引を代表しません。使われたエージェントもClaude系列に限られ、悪意ある参加者を交ぜた市場は調べていません。
評価方法にも仮定があります。順位を均等なスコア差に直しているため、「1位と2位の差が非常に大きい」といった好みの強さは表現できません。本人の順位そのものも、その日の気分や提示された情報に左右されます。
さらに、本人が順位を付けなかった本のスコアは補完しています。研究チームは補完方法を変えても主要な差が小さいことを報告していますが、全てが直接観測された評価ではありません。補完をやめると、再実行で成績が悪かった側を含む38%の参加者が除外され、結果が上振れするという問題も記されています。
実験の説明とプロンプトは公開されていますが、AICompanyは個票データや実行コードの公開を確認できておらず、市場全体の実験も再現していません。ここで示した実務手順の効果も未検証です。
代理エージェントには、本人との照合が要る
Project Swapの価値は、AIが取引したという見せ場に加え、その取引が誰の希望に沿っていたかを独立に測った点にあります。
作業を任せるとき、最初の依頼文をAIがどう読んだかは見えにくいものです。候補をいくつか比べると、その理解を具体的に確かめられます。
代理エージェントを評価するなら、目標の理解、実行、本人による成果評価をそれぞれ記録する。その小さな分け方が、もっともらしい達成報告の中に隠れた目的のずれを見つける助けになります。
出典
- Anthropic:Project Swap公式研究記事。2026年9月24日公開。Zoë Hitzigほか6名。
- 研究本文PDF。図3・4、注12〜15、限界の節を参照。
- 付録PDF。市場の再実行、取引規則、エージェントのプロンプトを参照。